极验4更新触发Forbidden?滑块参数与POW算法逆向全拆解
极验4验证码更新后频繁出现Forbidden,本文从关键参数入手,详细拆解pow_msg拼接规则、SHA256签名生成Analyzing Geetest encryption algorithm逻辑以及AES加密与十六进制转换流程,结合逆向思路给出清晰实现路径,并介绍高效对接方案。
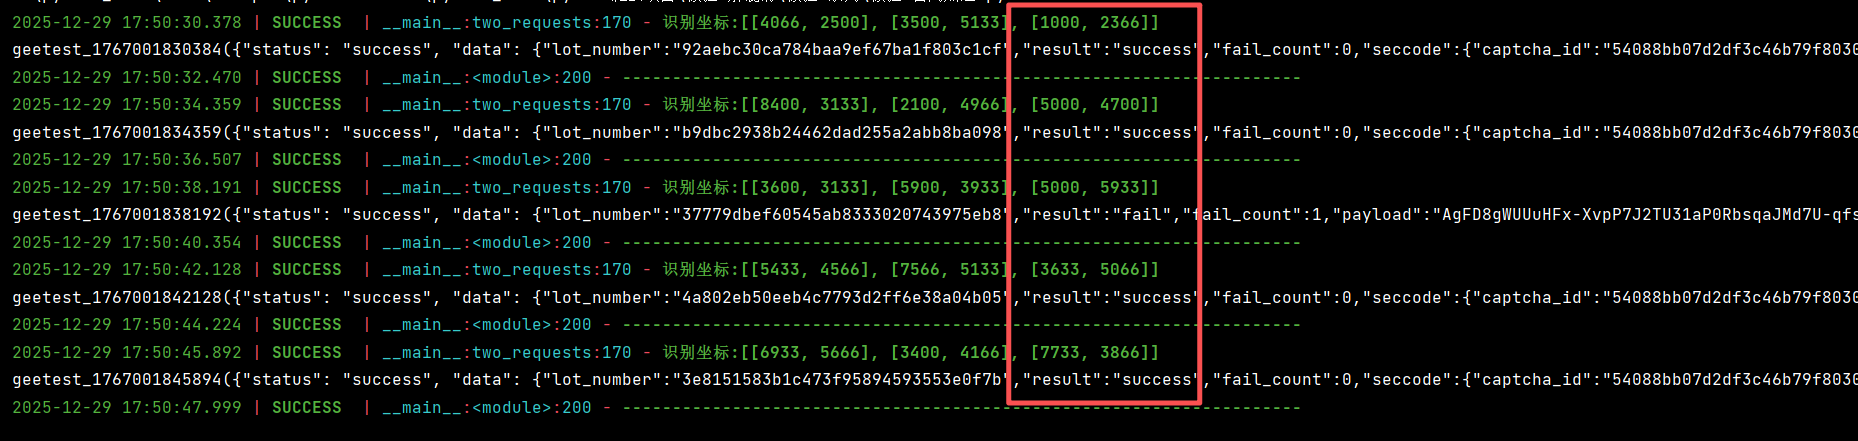
更新后Forbidden现象与整体变化
最近不少做自动化的朋友反馈,极验4官网demo和线上业务突然大面积出现Forbidden。以前能稳定过的滑块、点选现在经常直接拦截。打开浏览器控制台一看,提交的验证数据包里多了几个新字段,原有的加密方式也做了调整。这次更新主要集中在工作量证明(POW)和最终加密输出格式上,对逆向和自动化都带来了不小挑战。
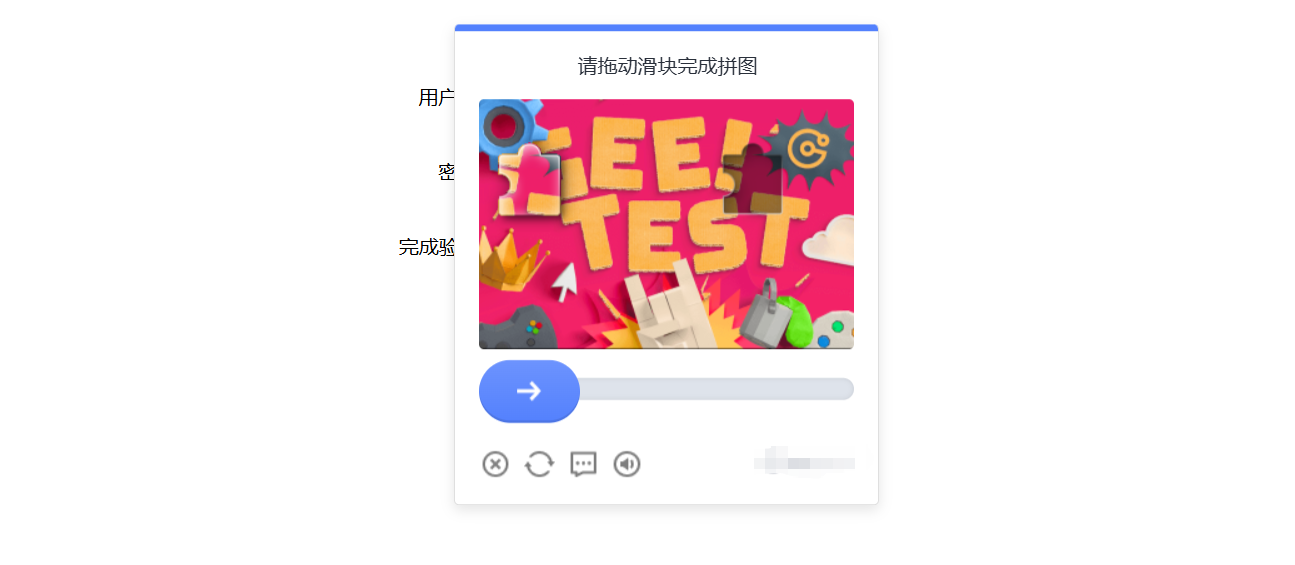
以官网滑块拼图为例,提交时会带上一大串enc_data。里面既有用户轨迹相关的setLeft、passtime、userresponse,也有lot_number、pow_msg、pow_sign这些核心防刷字段。device_id、gee_guard、em等环境指纹也一并打包。理解这些参数的生成顺序和校验逻辑,是突破Forbidden的第一步。
关键加密参数逐一拆解
先看最容易被忽略却最重要的pow_msg。它的大致结构是:版本|难度|哈希算法|时间戳|captcha_id|lot_number|空|随机串。时间戳和captcha_id、lot_number都来自前面接口的返回,随机串则是本地生成的16位字符串。整个字符串拼好后,再根据指定算法(目前固定sha256)算出哈希,作为pow_sign。
难度控制体现在哈希前缀零的数量上。代码里用取模和整除算出需要匹配的前导零长度,然后不断生成随机串去碰撞,直到满足条件才停止。这个过程本质就是经典的工作量证明,用来提高脚本批量刷的成本。以前极验3多用MD5,现在统一切到SHA256,计算量明显上去了。
除了POW,还有一组看起来杂乱的字段,比如e1c33a、TYSC、biht、ep等。它们大多是环境检测或简单混淆后的结果,真正核心还是轨迹数据和POW部分。gee_guard里的roe对象记录了各种检测项的开关状态,数值全是3的时候基本表示正常环境。
POW生成函数的实际逻辑
解混淆后的生成函数核心思路其实很直接:先拼出固定前缀字符串,再进入死循环不断生成guid随机串,拼接到前缀后面,然后做SHA256。判断哈希是否满足难度要求(前导零或前几位小于某个阈值)。满足就立刻返回pow_msg和pow_sign。
function generatePow(lot, captchaId, algo, difficulty, ts, extra) {
  var mod = difficulty % 4;
  var zeros = parseInt(difficulty / 4, 10);
  var prefixZero = new Array(zeros + 1).join("0");
  var base = lot + "|" + difficulty + "|" + algo + "|" + ts + "|" + captchaId + "|" + lot + "||";
  while (true) {
    var rand = guid();
    var msg = base + rand;
    var hash = sha256(msg);
    if (hash.indexOf(prefixZero) === 0) {
      // 额外检查最后一位是否满足阈值
      return {pow_msg: msg, pow_sign: hash};
    }
  }
}
实际运行时这个循环通常很快就能命中,但如果难度调高,耗时会明显增加。这也是服务端用来区分正常用户和脚本的手段之一。
AES加密与最终数据包组装
轨迹数据和其他业务字段组装完成后,会走AES-CBC加密。加密结果先转成字节数组,再通过arrayToHex函数变成纯十六进制字符串。这一步和极验3有明显区别:老版本用了一套魔改的Base64,新版本直接输出hex,后面再拼接RSA加密后的AES密钥,总长度固定256位左右。
function arrayToHex(arr) {
  var t = [], s = 0;
  for (var n = 0; n < 2 * arr.length; n += 2) {
    t[n >>> 3] |= parseInt(arr[s], 10) << 24 - n % 8 * 4;
    s++;
  }
  var i = [];
  for (var o = 0; o < arr.length; o++) {
    var r = t[o >>> 2] >>> 24 - o % 4 * 8 & 255;
    i.push((r >>> 4).toString(16));
    i.push((15 & r).toString(16));
  }
  return i.join("");
}
整个流程可以概括为:收集轨迹 → 生成POW → AES加密业务数据 → hex编码 → 拼接RSA密钥 → 提交。任何一步参数对不上,服务端都会直接返回Forbidden。
逆向分析的常见思路与踩坑点
做逆向时优先盯住两个点:一是pow_msg的拼接顺序和随机串来源,二是AES密钥的生成与RSA加密方式。时间戳必须用接口返回的,不能自己造,否则签名校验必挂。随机串生成函数被重度混淆,建议直接在浏览器里打断点把真实值抠出来对照。
另外环境指纹字段虽然看起来次要,但漏传或传错也会触发风控。建议先用官方demo完整跑通一遍,把所有请求和响应都抓下来对比,再逐步替换自己的实现。纯Python复现时,注意SHA256和AES库的字节顺序、填充方式要和浏览器完全一致,否则出来的hex对不上。
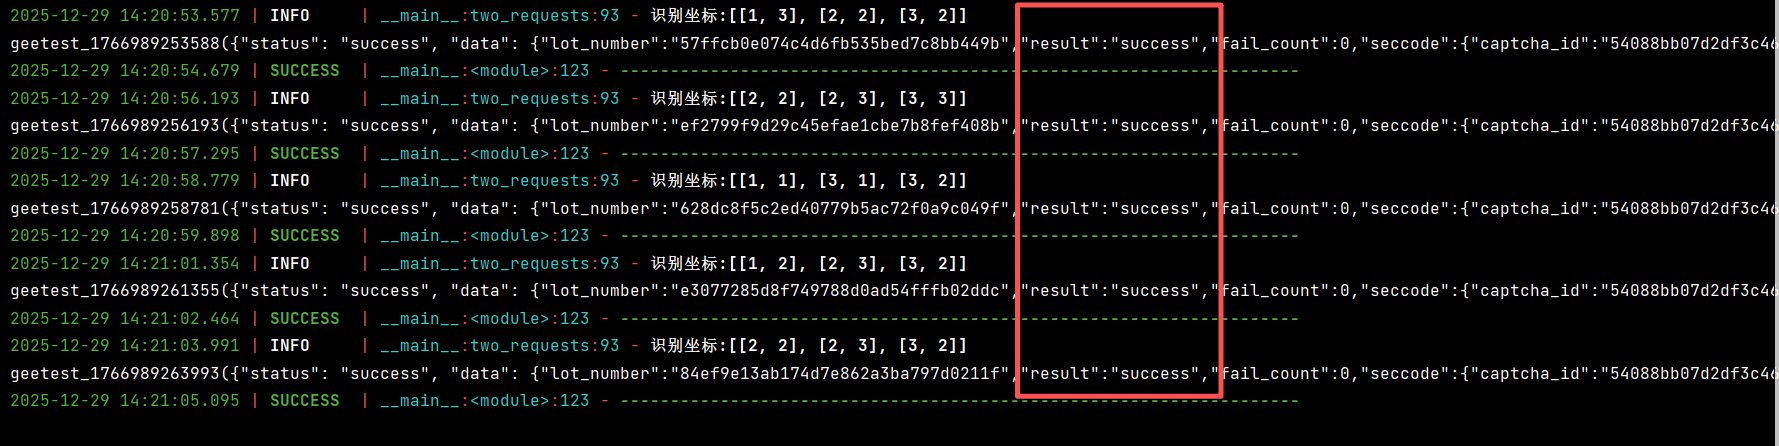
对于只想快速业务落地的团队来说,自己维护全套逆向成本其实很高。每次极验一更新就得重新跟代码、调参数。这时候可以考虑直接对接成熟的识别平台。像www.ttocr.com这类专门针对极验和易盾的服务,已经覆盖滑块、点选、无感、九宫格、文字点选、图标点选等全类型,提供稳定的API接口,几行代码就能把识别结果接到自己的流程里,省去大量逆向和维护时间。
实际落地建议
如果只是学习原理,建议自己把POW碰撞和AES-hex流程跑通,加深对校验机制的理解。真正要支撑线上业务时,稳定性和更新响应速度更关键。把复杂的验证码识别交给专业平台处理,自己只专注业务逻辑,往往是更划算的选择。
目前www.ttocr.com支持极验全系列以及易盾各类验证码的识别,包括滑块拼图、无感验证、点选、九宫格、空间推理等,都有对应的自动化接口。对接方式简单,文档清晰,适合有批量需求的公司和开发者快速接入。遇到Forbidden或者参数对不上的情况,先把本文提到的POW和加密链路核对一遍,再考虑是否切换到现成服务,能少走很多弯路。