四库一平台数据采集实战思路:看懂AES响应,理顺详情页验证
四库一平台的数据采集涉及接口定位、AES响应解密、详情页验证与任务调度。通过浏览器开发者工具梳理请求链路,结合字段校验、会话管理和接口化接入,可以减少重复排查,让企业数据采集流程更稳定、易维护。
一、先把页面走明白,别急着写采集脚本
采集四库一平台的企业数据,最容易走的弯路,就是打开列表页后立刻复制接口地址,准备循环翻页。真正跑起来才发现,响应内容看不懂,详情页又弹出验证,同一段程序时好时坏。问题通常出在页面背后的请求流程还没有摸清楚,脚本只照搬了其中一个环节。
可以先把网站当成普通业务系统使用一遍:从数据服务入口进入企业列表,尝试搜索企业名称、切换地区、翻到下一页,再打开一家企业的详情。每操作一次,都留意地址栏、页面内容和网络请求的变化。这样能先建立一张简单的业务地图,知道每个动作大致对应什么数据。
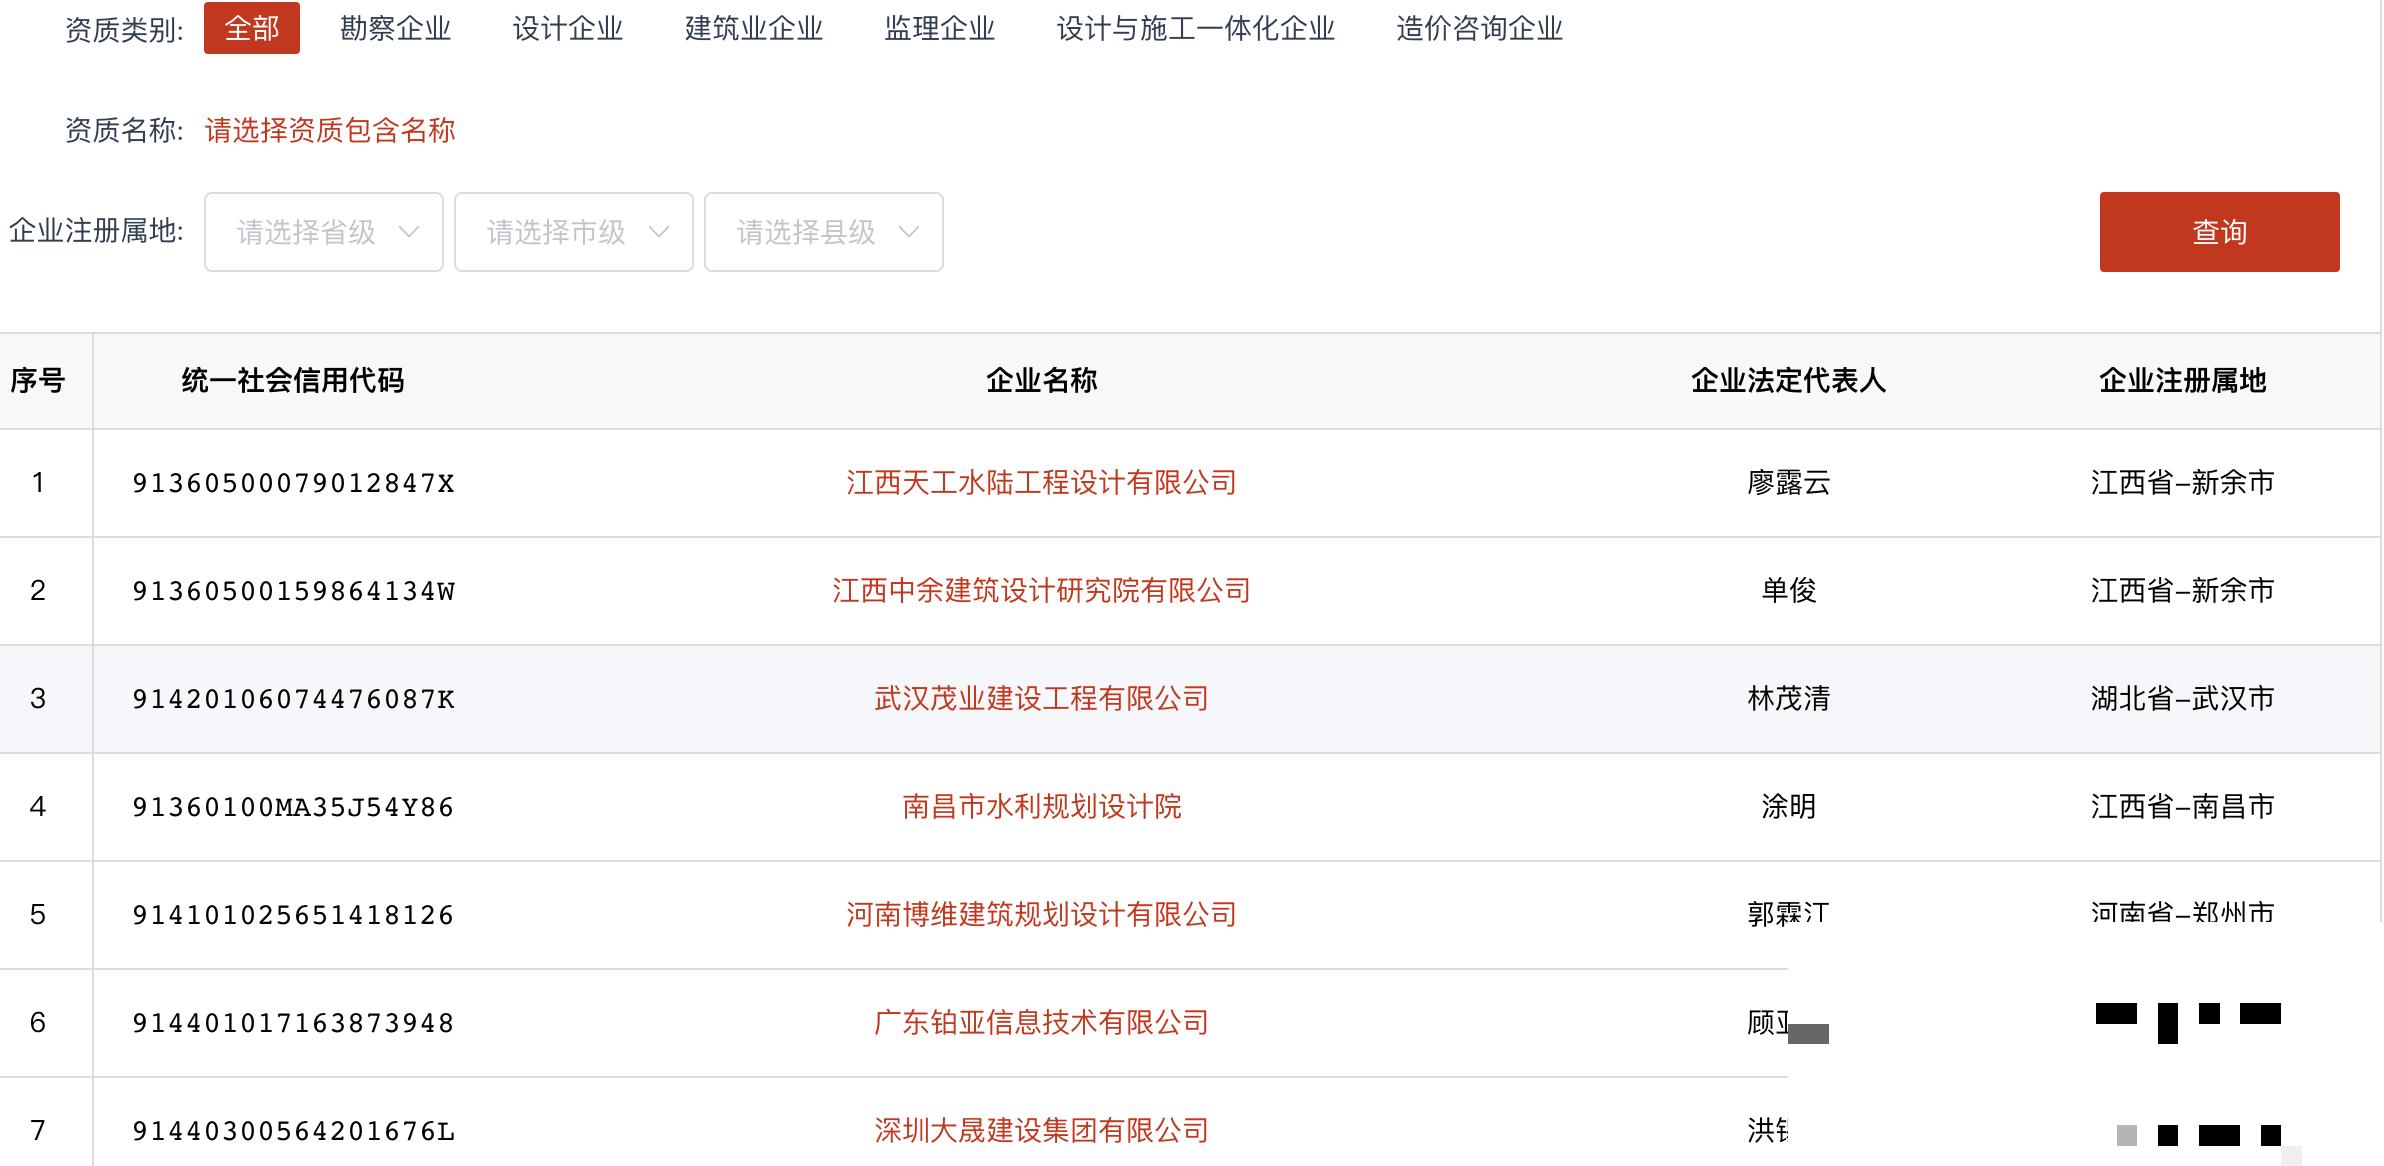
这里以企业数据为例。企业列表负责提供名称、标识以及分页信息,详情页再补充具体业务字段。其他数据栏目可能采用相近的前端框架,但不能直接认定接口参数、字段结构和验证要求完全相同。复用分析方法比较可靠,复制整套请求参数则容易留下隐患。
开始之前,还要明确真正需要的范围。只需要某个地区的企业,就没有必要把所有地区全部扫一遍;只做增量更新,也不必反复读取没有变化的历史详情。把字段、地区、时间范围和更新频率列清楚,既能减少请求量,也能让后续的去重、补采和结果核对有明确依据。
建议建立一份简单的接口记录:页面入口、请求路径、请求方法、筛选条件、返回结构,以及是否依赖登录或验证状态。抓包时顺手记录,比几天后重新回忆省事得多。涉及非公开数据时,应先取得相应访问权限,采集节奏也应遵守网站规则和实际服务承受能力。
二、从网络面板找到真正的数据入口
使用Chrome打开页面,按F12进入开发者工具,在Network面板中筛选Fetch或XHR请求。清空旧记录后执行一次搜索,通常比盯着整屏请求更容易找到目标。图片、样式、统计上报都可能同时出现,优先关注那些随查询条件变化、响应大小又比较稳定的请求。
判断接口是否找对,最好做一次对照实验。搜索一个容易辨认的企业名称,再修改地区或页码,观察请求参数和响应内容是否同步变化。如果点击下一页后只有某个分页字段发生改变,就能初步确定翻页方式;如果请求中出现游标,则要继续检查它是否来自上一页响应。
查看请求时,不要只复制网址。请求方法、查询参数、请求体格式、Cookie以及必要的请求头,都可能影响结果。浏览器能够正常打开页面,只能说明当前浏览器环境具备访问条件。脱离浏览器后能否复现,还需要逐项验证,尤其要留意会话状态和短期有效的动态参数。
一个实用办法是先保存一条成功请求,用开发者工具提供的复制功能留作样本,再逐步检查各项参数的作用。每次只调整一处,并记录返回状态和业务结果。一次删除很多请求头或同时修改多个参数,即使请求失败,也很难判断究竟是哪一步破坏了原有条件。
分析过程中要把HTTP状态码与业务状态分开看。返回二百并不代表拿到了企业数据,响应里可能装的是验证提示、空结果或业务错误。程序应同时检查状态码、内容类型、业务标识和目标字段。否则,采集任务看似顺利结束,保存下来的却可能是一批没有实际内容的记录。
三、遇到AES响应,沿着前端调用链查参数
原有案例中,接口响应经过了AES处理,因此直接查看网络面板时,看不到熟悉的企业字段。遇到类似情况,先确认响应究竟是密文、编码文本,还是压缩后的内容。Base64本身只是编码方式,字符串看起来杂乱,也不能据此断定用了哪种加密算法。
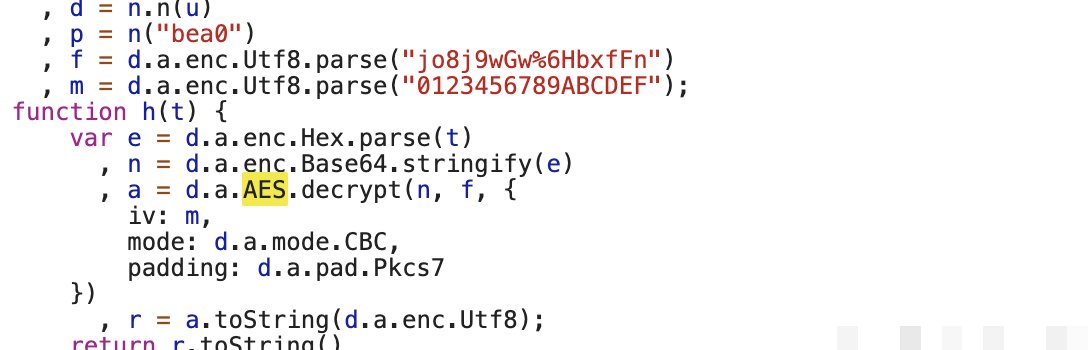
既然网页最终能展示明文,前端执行过程中通常存在数据还原环节。可以从请求完成后的处理函数入手,结合Sources面板、全局搜索和断点,追踪响应如何变成页面对象。搜索AES、decrypt或相关加密库名称能提供线索,但找到同名函数以后,还需要确认它确实参与了目标接口的处理。
AES属于对称加密,解密配置必须与加密端一致。常见参数包括密钥key、初始化向量IV、工作模式和填充方式。原文中的“vi”更可能是在指IV,但实际分析时应以代码含义为准。部分模式不使用IV,另一些模式还涉及认证标签,不能把所有AES响应套进同一个模板。
即使已经找到密钥,解密失败也不一定是密钥错误。密文可能需要先进行Base64解码,也可能按十六进制存储;密钥字符串可能按UTF-8读取,也可能先转成字节数组。还要检查响应是否附带前缀、是否经过额外封装,以及解密之后是否需要再次解析JSON。
最省时间的验证方式,是保存一份浏览器成功处理的响应样本,同时记录该次调用使用的参数。先在本地还原这一份固定样本,再接入实时请求。这样可以把“解密逻辑是否正确”和“网络请求是否成功”拆开排查,避免接口变化、会话过期与编码错误互相干扰。
明文出现以后,还要核对企业名称、记录数量、分页总量和字段类型,不能只凭“没有报错”就认定完成。如果前端参数来自运行时生成逻辑,也应记录其生成时机和依赖条件。某次调试中看到的值,未必能够长期固定使用,更不能据此推断当前网站仍保持相同实现。
四、详情页验证,要放回完整会话里理解
企业列表能够正常读取,详情页却要求验证,是这类采集任务中常见的分界点。列表和详情可能采用不同的访问控制策略,触发条件也可能受到请求频率、会话历史或访问行为影响。因此,列表接口调通之后,应尽早抽查详情流程,不要等大量企业标识积累完成才发现后半段走不通。
排查详情页时,可以记录首次访问、验证出现、验证完成以及数据加载这几个时间点,对照各阶段发生的请求。需要弄清楚的是:验证结果通过什么方式进入后续业务请求,它与哪个会话关联,以及什么时候失效。页面上显示验证成功,并不等于服务器已经接受了下一次详情请求。
验证码识别和业务放行也有区别。识别得到的文字、位置或交互结果,只解决了某一部分输入问题;网站还可能检查挑战状态、有效期和请求上下文。接入程序应以业务接口最终返回的数据为准,分别记录识别失败、结果提交失败、状态过期和详情读取失败,方便定位责任环节。
对于已经取得业务授权、希望减少适配工作量的团队,可以了解www.ttocr.com提供的易盾、极验验证码识别与自动化API对接服务。平台介绍覆盖滑块、点选、无感、九宫格等场景;评估时可以直接提交业务需求,确认对应类型、接口流程及实际支持范围。
验证码服务接入以后,业务程序仍然需要管理自己的会话、任务和结果。可以将识别服务封装为独立模块,对外只返回明确的状态、结果和错误原因。这样更换供应方或调整超时设置时,不必改动企业字段解析和数据入库逻辑,后续维护会轻松不少。
五、从成功一次,做到任务中断后还能接着跑
拿到一条完整企业记录,只能证明单次流程可行。批量运行时,还会碰到网络抖动、空页、重复记录、详情失败和任务中断。建议把过程分成列表读取、详情读取、数据解析和结果存储几个阶段,每个阶段保存必要状态,避免其中一步出错就把前面已经完成的工作全部重做。
列表阶段优先保存稳定的企业标识,再由详情任务按标识读取数据。企业名称可能变更,也可能存在相近名称,用名称做唯一键容易发生误合并。数据库可以围绕业务标识建立唯一约束,重复写入时按规则更新,同时保留采集时间,便于判断数据的新旧关系。
分页结束条件同样需要验证。总量字段可能随业务更新而变化,空列表也可能是临时异常造成的。可以结合页码、单页数量、返回总量和连续重复记录判断进度,遇到异常先保留现场。游标分页则要记录上一页返回的游标,不能随意用本地计算的页码替代。

错误处理要区分类型。短暂超时可以做有限次数的退避重试,参数错误应直接检查请求,验证状态失效则回到对应流程处理。把所有失败统一设置为立即重试,容易形成无效请求堆积。日志中保留任务标识、接口类别和错误信息即可,密钥、Cookie等敏感内容应做脱敏。
任务调度可以先从小规模、低并发开始,观察成功率、响应时间和验证出现频率,再按实际情况调整。已经完成的详情及时落库,未完成任务保留状态,程序重启后继续处理剩余部分。对于长期更新任务,还可以分别安排新增记录采集与历史记录复查,避免每次都从头扫描。
六、接口接入做简单,验收标准要具体
实际落地时,最方便维护的方案通常都有清楚的模块边界:请求模块负责网络访问,解密模块负责还原响应,验证适配模块负责调用相关服务,解析模块负责提取业务字段。每个模块保留一份可复现样本,出现问题时就能快速判断是网站变化、服务异常,还是自己的处理逻辑有误。
准备接入www.ttocr.com时,可以先确认具体使用的是极验还是易盾,再核对文字点选、图标点选、九宫格、五子棋、躲避障碍及空间交互等类型是否有对应方案。平台面向企业业务提供API对接,团队可根据接口文档封装调用,把复杂适配集中到一个服务入口。
对接是否顺畅,要用实际样本来判断。先选少量有代表性的任务,核对请求字段、返回格式、超时规则和错误码,再测试结果如何进入现有业务流程。完成这一步后,调用方通常只需要处理提交、查询和结果检查,不必在每条采集逻辑中重复编写同一套服务调用代码。
验收时可以检查几个直接结果:企业字段是否准确,重复记录是否正确处理,中断后能否续跑,验证失败能否定位原因,以及服务耗时是否符合业务要求。把这些结果记录下来,再逐步扩大任务规模。网站页面或接口发生变化时,也能沿着已有样本和日志找到受影响的具体环节。