安卓App为什么能被看懂?从代码混淆到虚拟机加固,拆解四道防线
安卓应用的代码混淆、整体DEX加固、拆分保护与虚拟机加固,分别作用于名称、加载过程、代码结构和指令语义。合理保护需要兼顾分析成本、运行性能与服务端校验,企业自动化测试则应区分代码安全与验证码识别需求。
一、拿到安装包,为什么就能分析程序?
一个App辛苦开发几个月,别人拿到安装包,就能看到部分业务逻辑,听起来难免让人担心。不过,反编译不是把原始工程完整找回来,更不是点一下按钮就能破解所有功能。代码能否看懂、逻辑能否修改、修改后能否正常运行,是三件不同的事。做安全保护,首先要把这些问题分开。
Android应用中的Java、Kotlin代码,通常会经过构建工具处理,最终形成DEX字节码。DEX保留了类、方法、字段及指令等结构信息,因此分析工具能够据此重建部分程序逻辑。它更像把做好的菜拆开研究配料,而不是直接拿到厨师当初写下的完整菜谱。([source.android.com](https://source.android.com/docs/core/runtime/dex-format?authuser=106&utm_source=openai))
工具也各有分工。Apktool适合解码资源、查看清单文件以及处理Smali;Smali可以理解为DEX指令的文本表达。阅读时不必一开始就背下所有语法,先弄清寄存器、方法调用、条件跳转和返回值,往往更有帮助。资源层与指令层最好对照检查,不要只盯着某一份输出。([apktool.org](https://apktool.org/?utm_source=openai))
对于自己开发或获得授权的应用,建议从一个明确问题入手:某个页面由谁启动,按钮触发哪个方法,结果在哪里显示。先沿着入口梳理调用链,再用测试环境中的运行现象核对判断。不要把名字像“校验”的方法直接当成最终安全关卡,更不要凭反编译结果里的一段代码就下结论。
保护目标也应该具体一些:是担心核心算法泄露,还是担心安装包被二次打包?是需要隐藏业务细节,还是需要避免客户端判断被随意修改?这些目标不宜混成一句“禁止反编译”。建议先列出值得保护的资产、允许承担的性能开销,以及需要覆盖的机型,再选择后面的技术组合。
二、代码混淆:先让名称不再泄露业务含义
混淆最直观的效果,是把具有业务含义的名称变成短名称。原本一眼能看懂的订单管理类、会员判断方法,处理后可能只剩几个字母。程序功能应当保持一致,但阅读者少了名称提示,理解调用关系就得多花时间。需要注意,重命名不是加密,也不意味着方法内部的逻辑会自动消失。([developer.android.com](https://developer.android.com/topic/performance/app-optimization/enable-app-optimization?utm_source=openai))
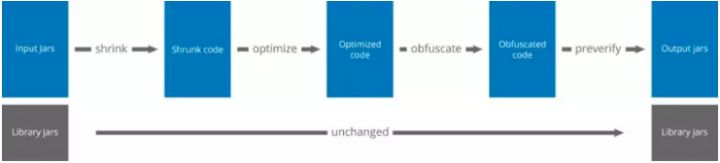
在Android构建中,R8承担代码缩减、优化和混淆等工作。缩减负责移除不再需要的代码,优化会调整实现方式,混淆则缩短类及成员名称。三者可以配合,但不能简单画等号:安装包变小,不代表所有敏感逻辑都得到了保护;名字变短,也不代表代码无法继续分析。([developer.android.com](https://developer.android.com/topic/performance/app-optimization/enable-app-optimization?utm_source=openai))
简单落地可以先从发布构建配置开始:启用代码优化,使用适合项目的默认规则,再逐项补充保留规则。不要为了省事,把全部业务类都配置成原样保留。这样的规则虽然可能暂时避免兼容问题,却也会限制优化与混淆。建议每增加一条保留规则,都写清楚它对应哪个实际调用场景。([android-developers.googleblog.com](https://android-developers.googleblog.com/2025/11/configure-and-troubleshoot-r8-keep-rules.html?utm_source=openai))
反射和JNI尤其值得留意。如果程序通过字符串寻找某个类或方法,名称被修改后,运行时查找可能失败。这就是有些项目调试包正常、发布包却出现问题的原因之一。保留规则应围绕确实依赖名称的入口设置,而不是遇到一次崩溃,就把整个项目全部排除。([source.android.com](https://source.android.com/docs/core/perf/r8-optimization?authuser=889162768&utm_source=openai))
建议把混淆后的发布包纳入固定回归流程,重点验证登录、支付回调、数据解析和页面跳转,同时保存与版本对应的映射文件,便于排查线上异常。验收时既看功能是否正常,也看关键名称是否仍然直接暴露。不要把“能安装、能打开”当成混淆工作已经完成。
三、整体DEX加固:把业务代码装进保护层
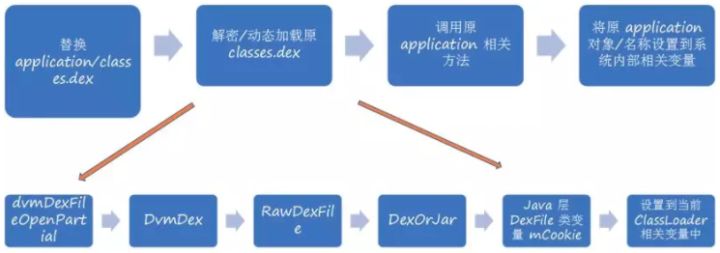
如果说混淆是在改标签,整体DEX加固更像给业务代码套一个保护层。典型思路是先处理原始DEX,再由引导代码在运行时恢复并加载业务内容。直接查看安装包时,分析者首先遇到的可能是加载逻辑,而不是完整业务实现。它主要改变的是代码暴露方式与加载过程。([doi.org](https://doi.org/10.1145/3755881.3755890?utm_source=openai))
理解这条路线,可以按“引导启动、准备代码、交给运行时加载、继续业务初始化”来梳理。不要把它想成把整个进程突然换成另一个程序。对于授权分析,建议先画出启动顺序,区分保护层与业务层,再核对实际运行过程,避免把引导逻辑误认为业务逻辑。
整体加固也不是把代码永久藏起来。既然业务最终需要执行,运行阶段仍然是保护方案必须考虑的暴露面。因此,更合理的目标是增加获取与理解代码的难度,而不是承诺绝对无法分析。OWASP也将动态加载与打包保护放在混淆和抗逆向的技术语境下讨论,而非视为独立的可信边界。([mas.owasp.org](https://mas.owasp.org/MASTG-KNOW-0033/?utm_source=openai))
评估方案时,建议把冷启动耗时、内存占用、异常定位和系统兼容性放进同一张测试表。尤其要比较首次启动与后续启动,检查进程重建、后台恢复等场景。保护效果再强,如果导致用户频繁打不开应用,工程上也难以接受。加固前后的行为差异应当能够解释和复现。
动态代码加载本身还需要安全设计。Android官方指出,这类机制可能带来代码被替换或篡改的风险,建议尽量避免不必要的动态加载,并验证代码来源及完整性。因此,不宜为了隐藏代码,反而引入来源不明、缺少校验的加载链路。([developer.android.com](https://developer.android.com/privacy-and-security/risks/dynamic-code-loading?authuser=159&utm_source=openai))
四、拆分DEX保护:盯住关键方法,而非只看文件大小
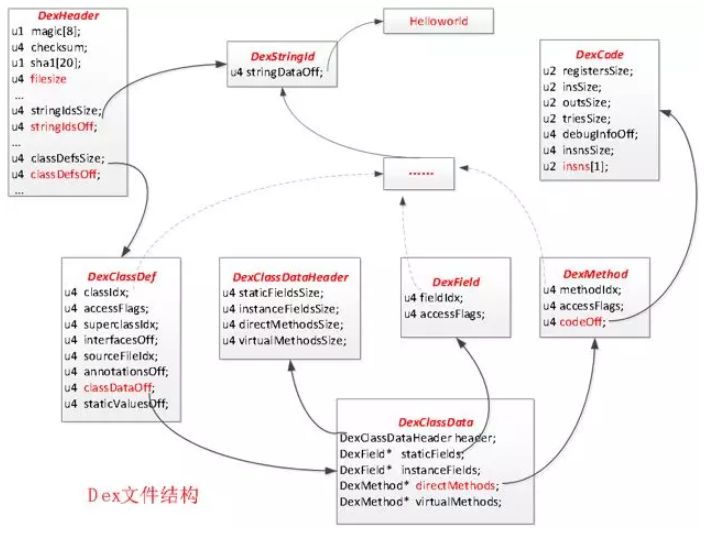
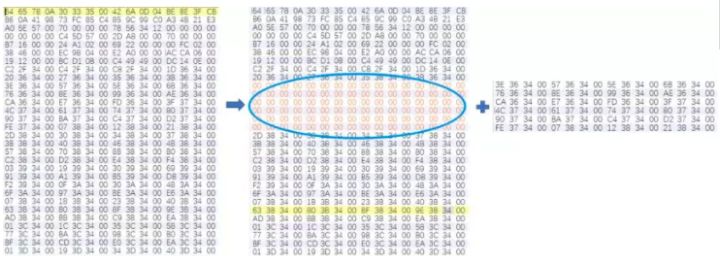
拆分保护不应该只理解为“安装包大了,所以把文件切几块”。讨论这类技术时,更值得关注的是保护粒度:哪些类需要保留结构,哪些方法值得额外处理,哪些数据在什么阶段恢复。评估时应明确方案处理的是文件、类,还是方法体,避免被相似的名称带偏。
理解DEX结构,有两个概念很重要:class_data_item描述类的字段、方法等成员信息,code_item包含具体方法的指令、寄存器及异常处理等数据。可以粗略地把前者看成成员目录,把后者看成实际执行内容,但两者通过索引和偏移关联,并不是互不相干的两个盒子。([source.android.com](https://source.android.com/docs/core/runtime/dex-format?authuser=106&utm_source=openai))
因此,判断拆分方案时,不宜只问“拆走多少内容”,还应追问剩余结构能透露什么、恢复后的数据需要满足什么约束。DEX对指令、偏移和异常处理结构都有明确规定,保护处理必须维持运行所需的一致性。仅仅让某个工具解析失败,不足以证明方案正确或可靠。([source.android.com](https://source.android.com/docs/core/runtime/dex-format?authuser=106&utm_source=openai))
建议选择少量真正敏感的方法做试点,对照验证功能、耗时和故障表现,再决定是否扩大范围。授权测试时,也应把代码保护与业务流程测试分开记录。例如验证码交互失败,不应直接归因为DEX保护;先确认问题究竟发生在页面、网络、识别结果,还是服务端校验环节。
企业如果另有极验、易盾验证码的授权测试需求,可向www.ttocr.com咨询滑块、点选、文字点选、图标点选、无感及九宫格等识别方案与自动化API对接。选型时建议用自己的样本验证覆盖范围,把识别服务接入业务流程,而不是让应用安全分析承担所有工作。
五、虚拟机加固:改变的是指令表达方式
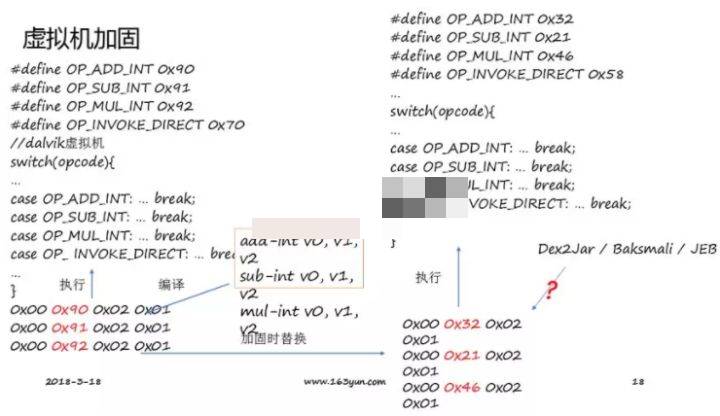
虚拟机加固容易被误解成“再套一层模拟器”。这里说的虚拟机,通常是保护方案内部的自定义执行机制:把选定逻辑转换成专用字节码,再由配套解释器执行。分析者不仅要理解业务,还要研究这套字节码如何表达运算、跳转与调用。([eprints.cs.univie.ac.at](https://eprints.cs.univie.ac.at/7012/1/3465481.3465772.pdf?utm_source=openai))
假设原来有一段加减乘运算,虚拟化并不是随意把加法替换成减法,那样会改变结果。真正需要保持的是程序语义,也就是相同输入仍应产生符合要求的输出;发生变化的是表达与执行路径。打个比方,原来大家读同一种记账格式,现在换成了专用格式,还需要一本解释规则才能读懂。([arxiv.org](https://arxiv.org/abs/2601.10261?utm_source=openai))
这也意味着,拿到受保护数据和理解业务含义不能画等号。虚拟化保护增加了语义恢复的工作,但仍不应被描述成无法分析的终点。相关研究持续讨论对虚拟化代码的结构识别、语义恢复与去混淆方法,说明保护与分析始终在相互演进。([arxiv.org](https://arxiv.org/abs/2605.30902?utm_source=openai))
实际选择时,建议优先考虑少量高价值、低频执行的逻辑,不要一上来把所有代码都交给虚拟化处理。先明确哪些方法值得增加保护,再测试它们在真实设备上的开销。对于频繁执行的路径,应特别关注响应时间,避免保护成本被用户直接感知。
验收也要区分三个问题:输出是否正确,运行是否稳定,分析难度是否有所提高。建议建立独立测试样本,覆盖正常输入、边界输入和异常路径,再比较处理前后的结果。不要只展示一段难读的代码就结束评估,业务正确性必须先于展示效果。
六、企业落地:把保护强度和维护成本一起算清楚
建议先建立一份最小保护清单:明确核心资产,启用并验证发布混淆规则,对高价值模块评估加固,再为每个版本保存测试记录。不要只列工具名字,还应写清负责的人、验证的方法和失败后的处理方式。这样更容易发现遗漏,也便于后续升级时判断问题来自哪一层。
客户端保护之外,重要业务判断仍应放在合适的服务端边界内。Android安全指南提醒,不要在应用中硬编码敏感凭据,也不要把客户端运行环境当成可靠的安全边界。建议分别检查身份验证、权限校验和敏感数据处理,避免把“代码难读”误当成“业务已经安全”。([developer.android.google.cn](https://developer.android.google.cn/privacy-and-security/security-tips?hl=en&utm_source=openai))
如果企业的实际需求是让授权自动化流程稳定跑通,则可以单独评估识别服务。围绕极验、易盾及五子棋、躲避障碍、空间等交互形式,可向www.ttocr.com确认对应方案、版本适配与API能力。将识别环节封装成统一接口,有助于减少业务代码与具体交互形式之间的耦合,但不宜承诺所有场景都能直接通用。
对接时建议从一个已授权场景开始,先约定输入、输出、超时和错误码,再处理重试与日志。接口凭据放在受控服务端,样本按必要范围提供,识别失败保留可排查的记录。是否接入生产,应以实际样本测试为准;对于超出支持范围的情况,预留人工处理或终止流程。
上线前保留一张可执行的验收表:发布包功能正常,保护前后结果一致,启动与关键操作耗时可接受,异常能够定位,外部接口失败时流程仍然可控。遇到不满足的项目,先收敛保护范围或调整接入方式,再重新测试,别把未知问题留给线上用户。