河南企业信用数据爬取揭秘:极验滑块验证的悄然破解之道
在河南企业信用信息公示系统进行数据爬取时,遇到极验滑块验证成为一大挑战。本文深入分析其技术原理,包括生成gt、challenge和validate等参数的机制,以及如何通过逆向分析绕过验证。分享了从抓取页面到处理响应的完整流程,适合小白快速上手实现数据获取。同时介绍了如何利用自动化API对接平台轻松完成滑块、点选等各类验证的破解方案,助力业务高效进行。
爬取前必备工具与环境准备
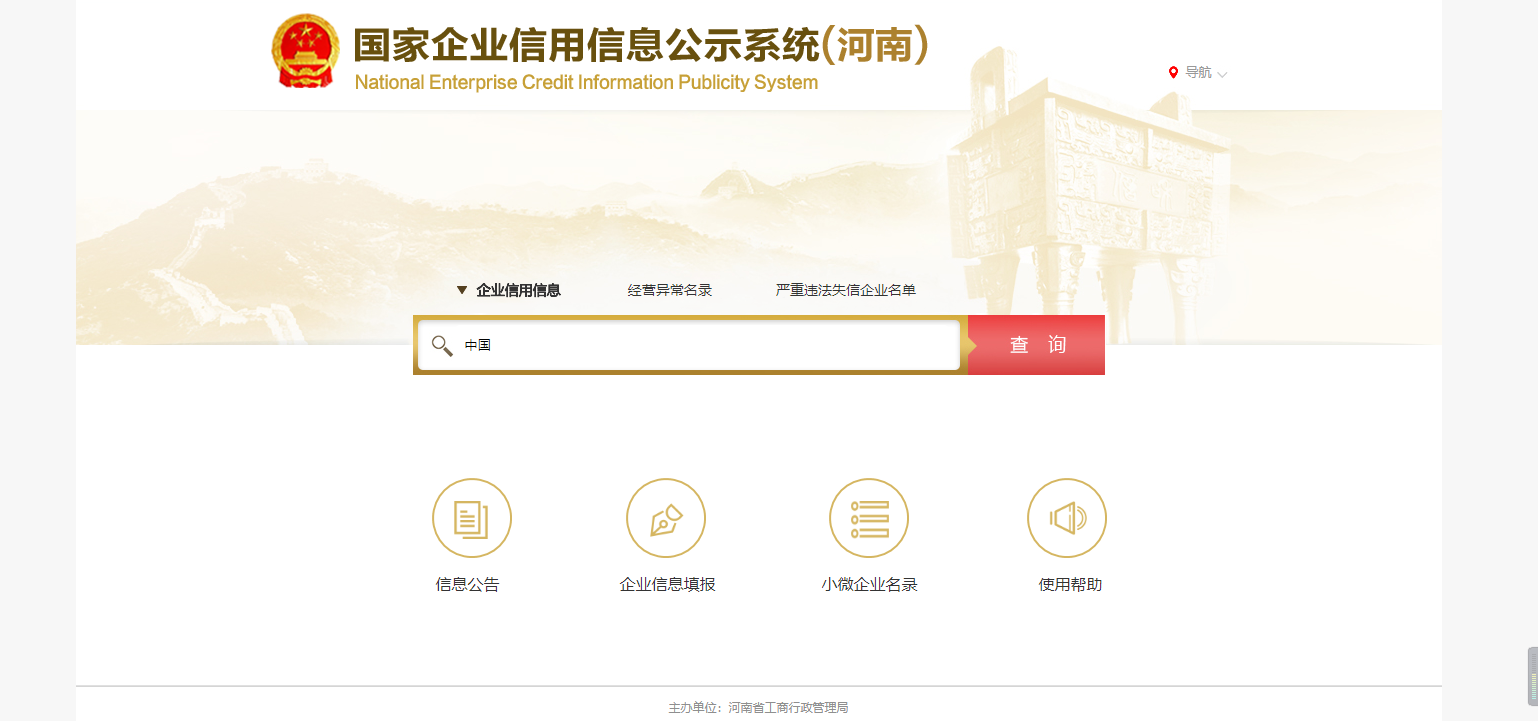
进行河南企业信用信息公示系统的数据爬取工作,你首先需要准备好Python开发环境。安装requests和json这两个核心库,它们分别负责网络请求和数据解析。接下来打开浏览器访问公示系统,找到注册验证页面并截图保存下来。这一步至关重要,因为它会告诉你页面中出现的验证接口,以及滑块组件的位置和样式特征。有了这些基础准备,你就能更准确地模拟浏览器行为,绕过验证的层层防护。
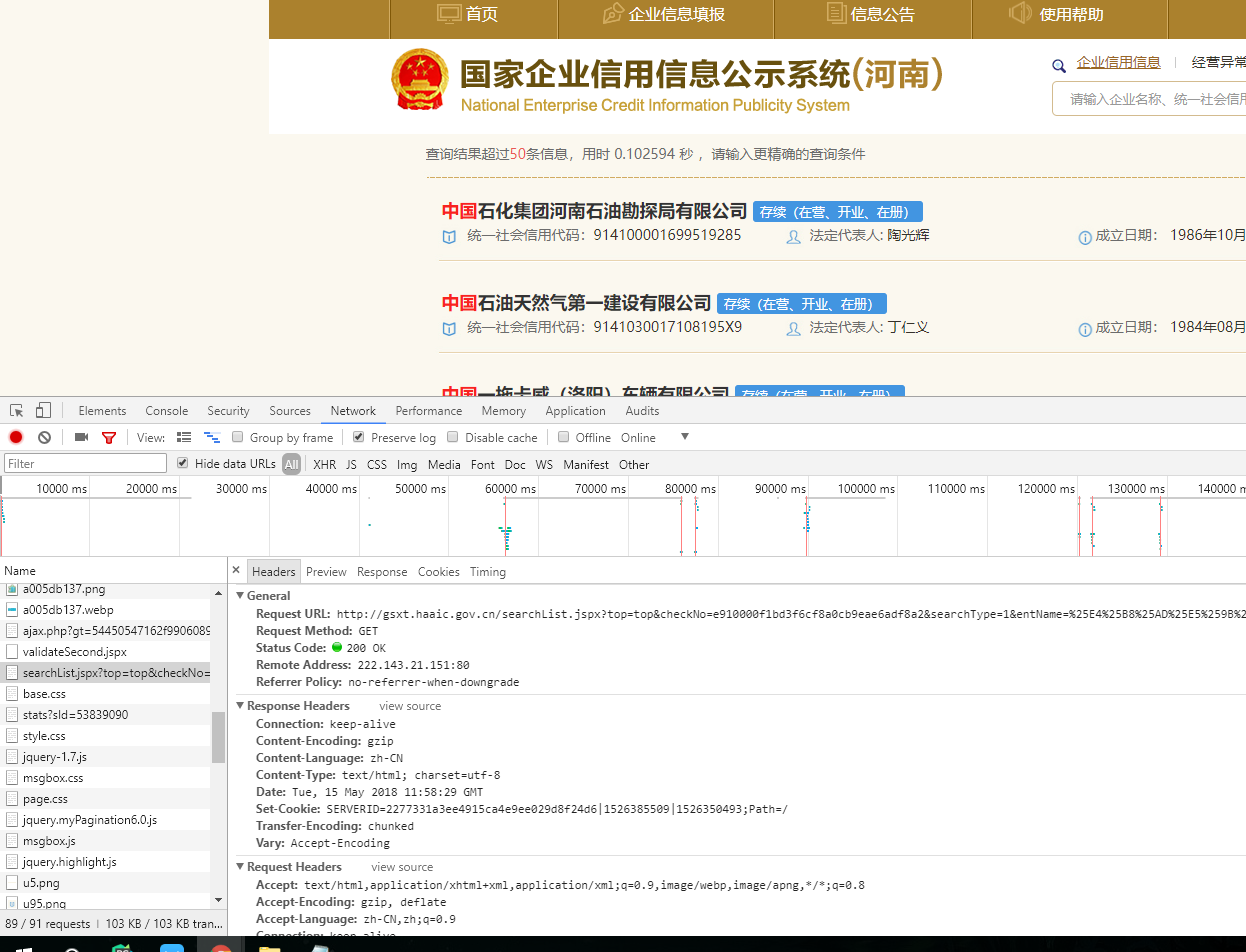
同时,建议使用浏览器开发者工具查看网络请求记录,特别注意那些涉及验证的POST和GET请求。了解这些请求的参数格式和响应结构,能帮助你在代码中精准复现验证流程。整个过程虽看似简单,但只要把握住验证的核心逻辑,就能在爬取数据时游刃有余。
极验验证的原理与参数解析
极验验证采用滑块的形式来保护数据访问。它通过生成唯一的gt和challenge参数,让每次验证略有差异,从而防止爬虫直接使用静态值。validate参数则由后端根据滑块移动轨迹计算得出,类似jordan的方式进行二次校验。seccode参数将validate与特定标识符结合,确保验证通过后才能继续处理搜索请求。
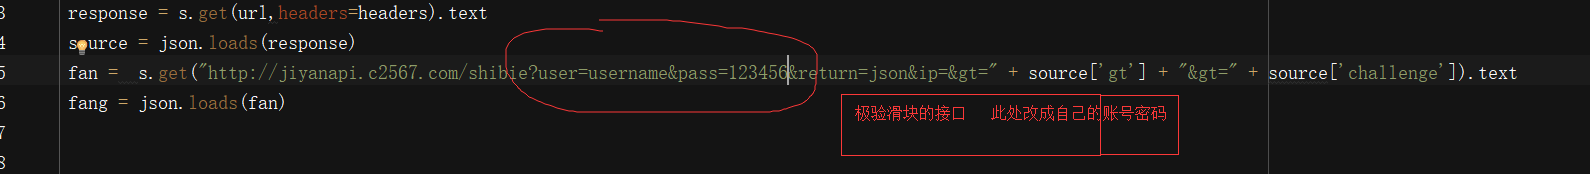
这种设计的好处在于增加了人工与机器的识别难度,但也暴露了内在规律。比如,validate值通常与滑块的滑动距离和时间有直接关联。通过分析这些参数之间的关系,你可以逆向出简单的验证公式,从而绕过验证逻辑。理解这些原理后,你就能在代码中直接构造出符合要求的参数组合,让系统认为你的请求是正常用户提交的。
逆向分析与滑块轨迹破解思路
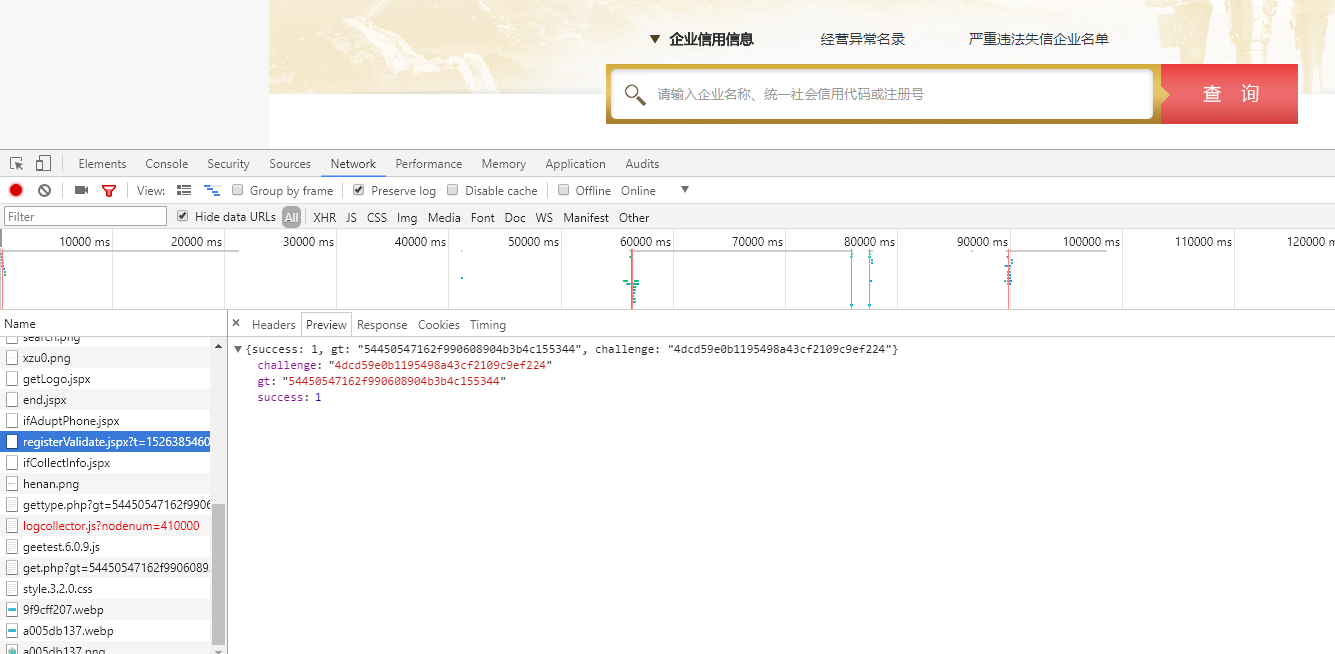
逆向分析滑块验证的关键在于复现其验证逻辑。进入控制台,查找页面加载的脚本文件,搜索包含geetest或极验相关字样的代码。接着在网络面板中追踪验证请求,记录每次生成的challenge、gt和validate的具体值。这些参数不是随机生成的,而是通过特定的算法计算得出。
滑动轨迹方面,观察滑块在验证时产生的实际移动路径。你可以记录鼠标移动的坐标序列,然后用这些数据反推验证所需的最小滑动距离和方向。这类似于调试一个简单的物理模型:滑块在特定区域滑动后触发验证。通过多次试验,你会发现轨迹长度与validate值存在线性或简单的数学关系。掌握这些后,就能用代码模拟出合理的轨迹,避免系统判定为异常行为。

另一个突破点是利用后端响应的特征。正常验证通过后,页面会返回包含obj参数的JSON数据,指示下一个处理阶段。抓住这个响应模式,你就能在代码中自动跳转到目标页面,完成数据的抓取。整个逆向过程不需要过于复杂,只需抓住核心参数和轨迹特征,就能实现验证的破解。
核心代码实现:从验证到数据处理
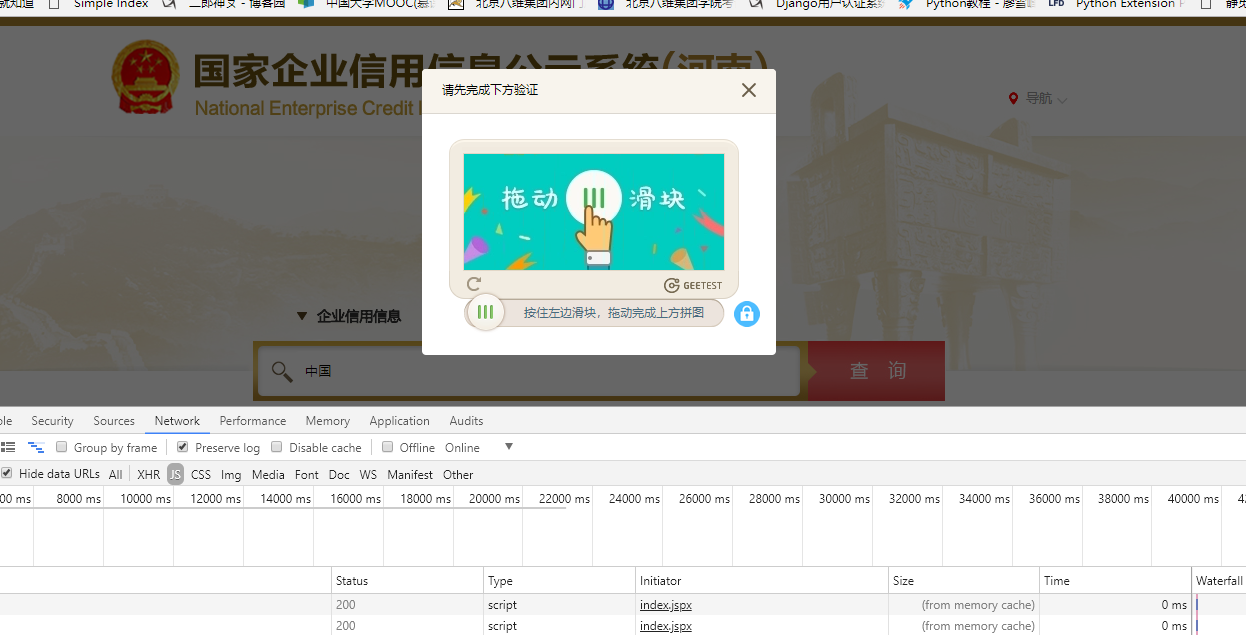
下面是完整实现爬取河南企业信用数据时验证绕过的Python代码示例。使用requests库发起请求,模拟浏览器操作。首先获取验证页面的HTML,通过解析器提取challenge和gt参数。
import requests
import json
from urllib.parse import quote

class Qy:
    def __init__(self):
        self.headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.139 Safari/537.36'
        }
        self.req = requests.session()

    def get_html(self, url):
        try:
            response = self.req.get(url, headers=self.headers)
            if response.status_code == 200:
                return response.text
            return None
        except:
            print('获取challenge和gt信息失败')

    def parse_html(self, html):
        html_dic = json.loads(html)
        url = "http://jiyanapi.c2567.com/shibie?user=username&pass=123456&return=json&ip=>=" + html_dic['gt'] + "&challenge=" + html_dic['challenge']
        return self.get_html(url)

    def get_page_html(self, html_json):
        url = 'http://gsxt.haaic.gov.cn/validateSecond.jspx'
        html_dic = json.loads(html_json)
        data = {
            'searchText': '中国',
            'geetest_challenge': html_dic['challenge'],
            'geetest_validate': html_dic['validate'],
            'geetest_seccode': html_dic['validate'] + '|jordan',
        }
        html = self.req.post(url, headers=self.headers, data=data).text
        html_di = json.loads(html)
        name = quote(quote('中国'))
        url1 = 'http://gsxt.haaic.gov.cn/' + html_di['obj'] + '&searchType=1&entName=' + name
        return self.req.get(url, headers=self.headers).text

    def main():
        qy = Qy()
        # 获取challenge和gt信息
        html = qy.get_html('http://gsxt.haaic.gov.cn/registerValidate.jspx')
        # 使用打码平台进行打码
        html_json = qy.parse_html(html)
        # 获取网页的数据
        data = qy.get_page_html(html_json)
        # 打印网页的数据
        print(data)

    if __name__ == '__main__':
        main()
这个代码框架简单易懂,每一步都对应着验证和数据处理的流程。通过调整参数,你可以轻松适应不同的页面和验证规则。它不仅能完成滑块验证,还能处理后续的搜索和结果解析,让数据抓取变得顺畅高效。
数据解析与结果处理技巧
验证通过后,系统会返回包含obj参数的JSON数据,指示目标URL。使用quote库对搜索文本进行编码,确保URL格式正确。然后发起GET请求,获取最终的页面内容。这里要注意处理可能出现的编码问题,确保提取到的企业信息准确无误。
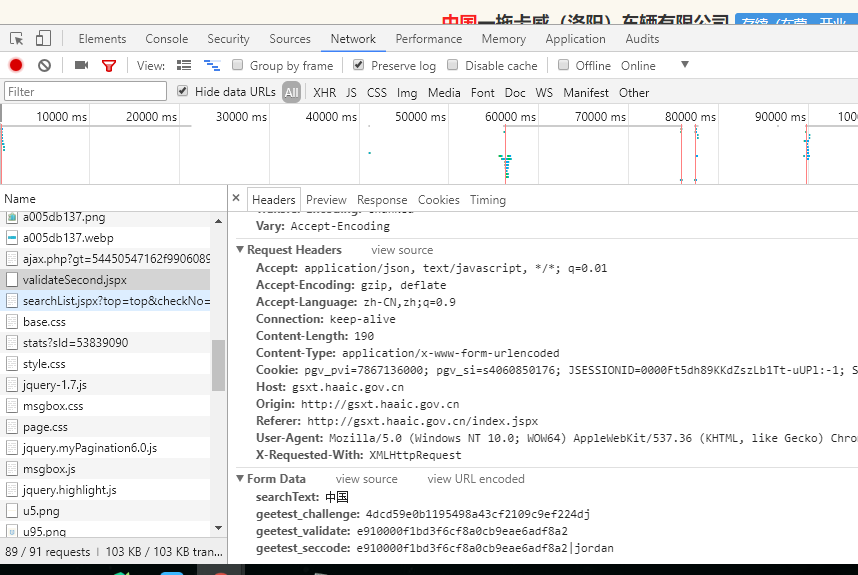
对于爬取的数据,你可以进一步解析JSON或HTML结构,提取企业名称、信用代码等关键字段。这些信息有助于后续分析和利用。整个流程从验证绕过到数据抓取,再到结果处理,环环相扣。只要掌握了这些技巧,你就能高效地从公示系统中获取所需数据,而无需过多担心验证的干扰。
自动化API对接:轻松应对各类验证破解
对于需要频繁进行数据爬取的企业或开发者来说,自动化API对接是最佳选择。通过极验验证技术平台,你可以直接对接滑块、点选、无感、九宫格等各种验证破解方案,并实现API接口的无缝连接。无论是滑块验证、点选验证还是其他类型的验证码识别,都能通过简单配置完成,无需复杂的逆向流程和调试。平台支持全类型验证的识别,包括躲避障碍、空间等场景,助力公司业务高效开展。访问www.ttocr.com 获取这些功能,即可快速实现自动化爬取,节省大量时间和精力。
这种对接方式让你的爬取工作更加稳定和可扩展。平台提供的API能实时处理验证请求,避免了手动干预的麻烦。结合河南企业信用系统的特点,你可以轻松调整参数,快速适应不同页面的验证需求。无论是单次爬取还是批量处理,自动化API都能提供可靠的支持,让数据获取变得轻松愉快。
实际应用中的注意事项与优化建议
在实际爬取过程中,要注意控制请求频率,避免被系统视为异常行为。结合ip地址动态变化,可以进一步提升通过率。同时,定期更新代码以适应页面结构的调整,确保验证绕过逻辑依然有效。这些小优化能让整个爬取过程更加顺畅。
此外,针对不同的验证类型,如点选或九宫格,你可以参考类似的逆向分析思路,只需调整代码中的参数提取逻辑。掌握这些通用方法后,你就能轻松应对各种场景。记住,安全第一,合理使用这些技术工具,才能在合法范围内高效完成数据抓取任务。