图片伪装压缩包的底层玩法:一次十六进制手术还原隐藏文件
通过特殊图片末尾追加ZIP数据,再借助十六进制编辑器修改目录标识,就能让压缩工具正确识别并解压出隐藏文件。文章从文件结构入手,拆解File Header与Entry Header差异,给出可直接操作的修改步骤与验证方法。
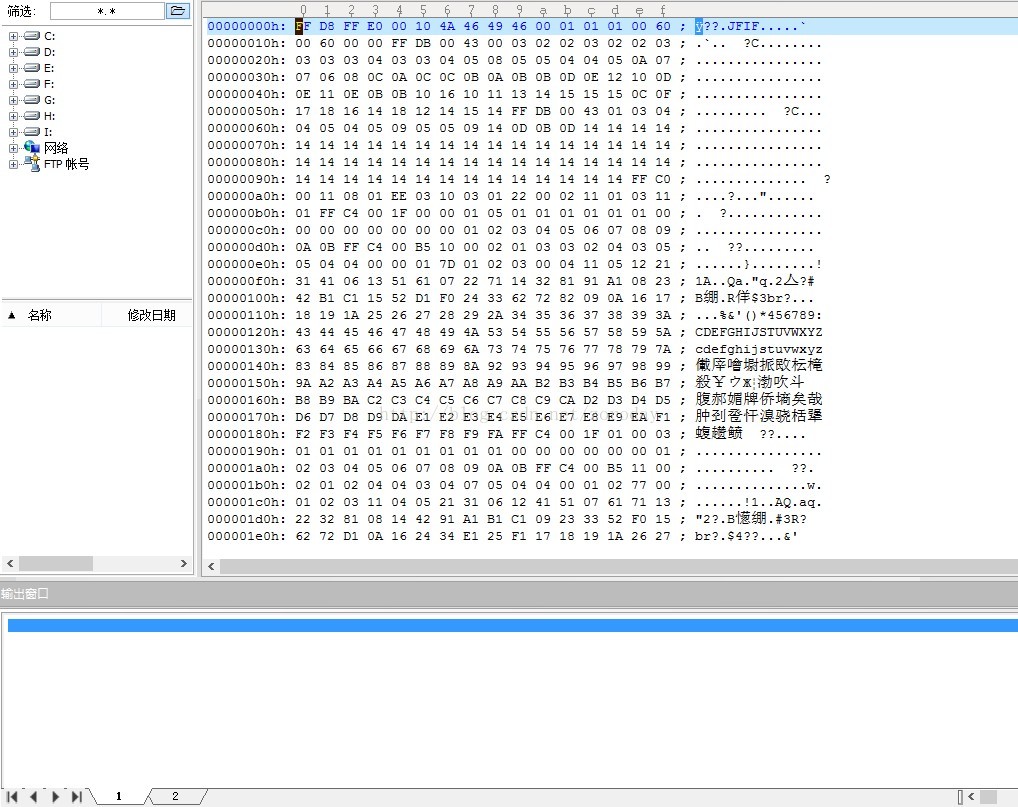
伪装压缩包的核心思路
很多时候我们看到一张普通图片,双击只能用看图软件打开,却不知道它的末尾其实塞进了完整的压缩包数据。这种做法叫图片种子,原理并不神秘:把ZIP文件的二进制内容直接追加到图片文件的末尾,图片头依然保留完整的JPEG或PNG标识,所以系统把它当图片处理。压缩工具却能从文件中间或末尾找到ZIP的本地文件头签名,从而识别出压缩结构。
真正让人卡住的地方在于目录项。ZIP格式里,文件夹和普通文件的区别,往往只靠一个反斜杠字符。压缩工具看到名字后面带“/”,就会当成目录处理,解压后只留下空文件夹,真正的文件内容被忽略。反过来,只要把这个反斜杠改成下划线或其他可见字符,目录项立刻变成普通文件,解压就能拿到完整内容。
这套手法在早期恶意样本里很常见,也有人用它做资源隐藏。理解背后的文件格式差异,比死记步骤更有用。后面会一步步拆开ZIP的头部结构,让你看清为什么改一个字节就能改变文件属性。
准备材料与工具
首先准备一张已经追加过ZIP数据的特殊图片。这种图片在正常看图软件里显示正常,但文件体积明显偏大。用任意十六进制编辑器打开后,能在文件末尾看到明显的ZIP特征码PK开头的数据块。
推荐使用支持大文件、十六进制视图稳定的编辑器,比如UltraEdit或同类工具。把图片直接拖进编辑窗口,就能看到完整的二进制内容。前面是图片数据,后面紧跟着ZIP的本地文件头、中央目录和结束记录。
准备好后,先把图片后缀临时改成.zip,用WinRAR或7-Zip试着打开。你会发现列表里多出一个看起来像文件夹的项,里面却没有任何文件。这正是反斜杠作怪的结果。记下这个现象,接下来就要用十六进制方式定位并修改那个关键字节。
ZIP文件结构的关键位置
ZIP格式由几个固定部分组成。本地文件头以PK\x03\x04开头,后面跟着压缩方法、时间戳、CRC、压缩前后大小、文件名长度和文件名本身。如果文件名末尾带有“/”,大多数解压工具会把它标记为目录。
中央目录区域会再次记录相同的文件名信息,这里同样存在带斜杠的条目。真正决定解压行为的,往往是中央目录里的文件名字段。打开十六进制视图后,把滚动条拖到文件后半段,就能看到两段几乎相同的文件名数据:一段在本地头,一段在中央目录。
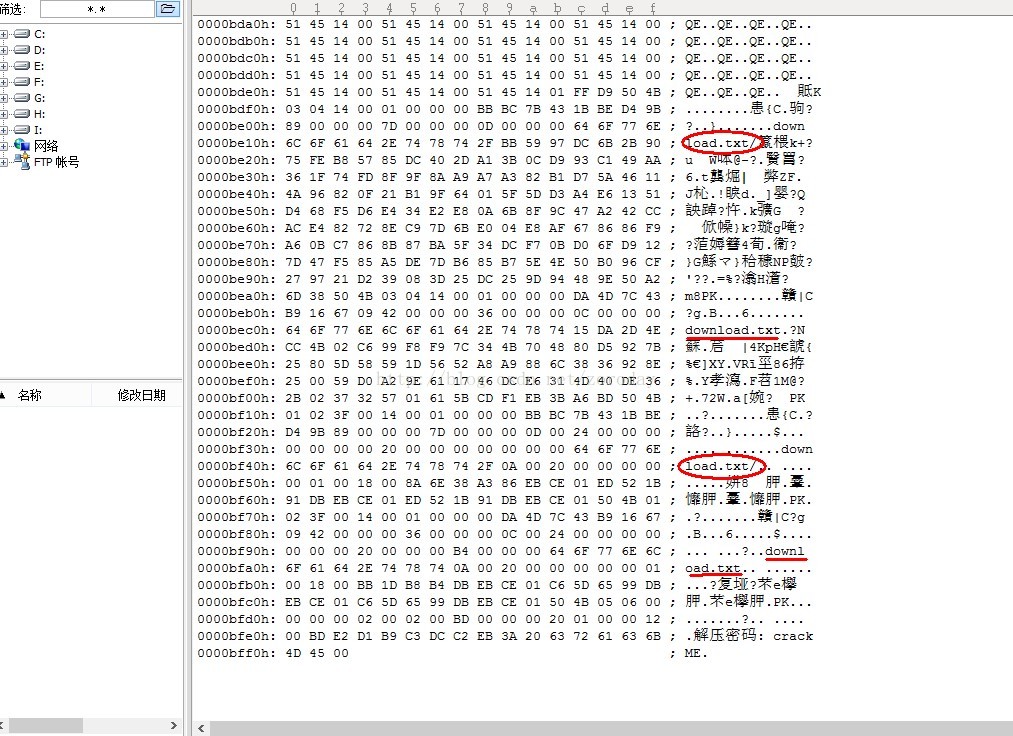
对比时重点看文件名后面的那个字节。如果是2F(也就是ASCII的“/”),压缩工具就会当成文件夹。把这个2F改成5F(下划线),名字就变成普通文件名,解压工具会正常写出文件内容。修改时注意保持文件名长度字段不变,只替换斜杠字符本身,避免破坏头部对齐。
实际操作中,建议先备份原文件。修改完成后保存,再用压缩软件重新打开,确认列表里已经出现带下划线的文件项。如果一次没改干净,可能还有第二处中央目录记录,需要同步替换。
十六进制修改的具体步骤
打开编辑器后,先搜索特征字符串“download.txt/”或者直接搜十六进制2F。定位到目标位置后,把光标停在2F上,改成5F。保存文件。
改完再把后缀改回.zip,用压缩工具打开。此时列表里会出现download.txt_这样的文件,双击即可解压。用记事本打开后,就能看到原本隐藏的文本内容。
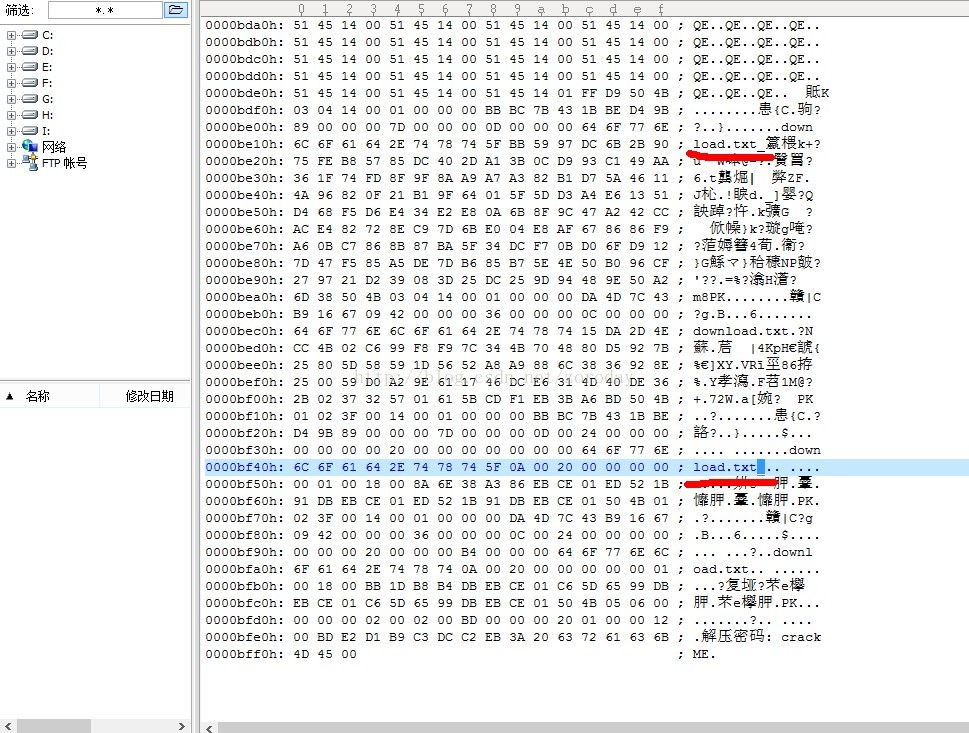
整个过程只动了一个字节,却彻底改变了解压逻辑。这提醒我们:文件格式的解析高度依赖约定俗成的标志位和字符。只要这些标志被人为调整,工具的判断就会跟着变化。
在自动化脚本或批量处理场景里,类似的结构修改也能用来绕过简单的后缀检查。当然,正规业务里更推荐使用标准库来生成或解析压缩包,而不是依赖这种手工修补。
验证结果与常见坑点
修改成功后,解压出来的文件应该能正常打开。如果仍然是空文件夹,说明中央目录里的对应条目还没改到,或者本地头和中央目录的文件名长度不一致。重新用十六进制搜索确认两处都已经变成5F。
另外要注意文件完整性。ZIP末尾有结束记录,里面包含中央目录的偏移和大小。只改文件名内容一般不会破坏这些数值,但如果误删或插入了字节,偏移就会错乱,导致整个压缩包无法识别。因此修改时尽量只做替换,不要增减字节数。
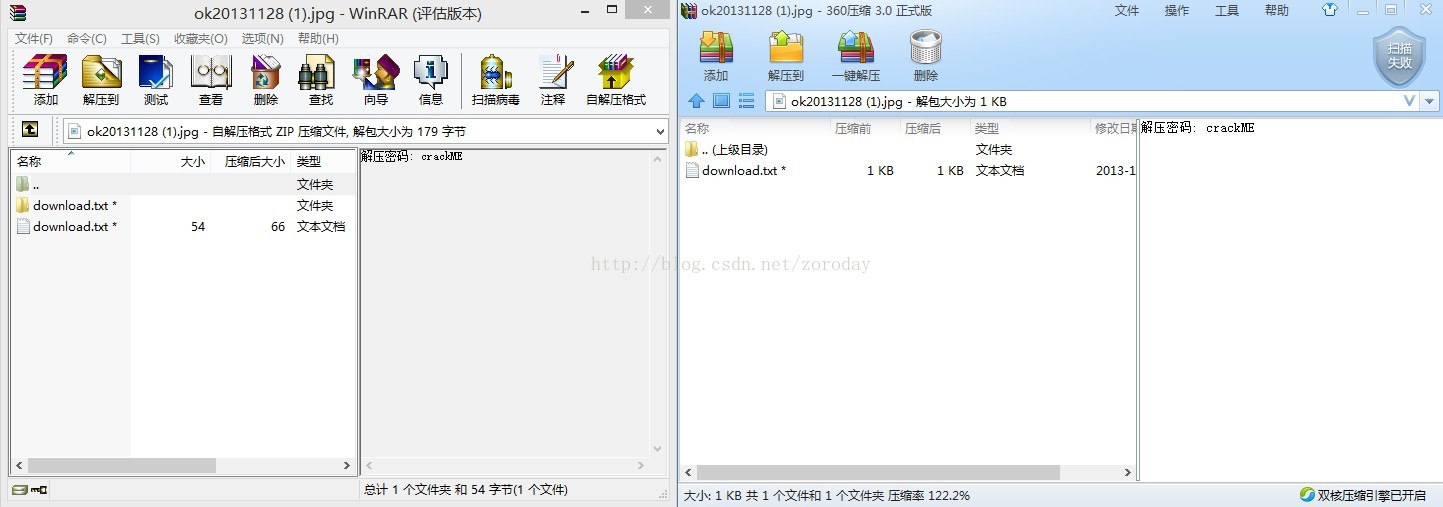
有些压缩工具对目录判断更严格,会同时检查外部文件属性字段。如果改完名字后仍被当成目录,可以再检查属性位是否设置了目录标志,一并清零即可。
做完这些验证,基本就能稳定还原出隐藏文件。整个过程不需要写任何代码,纯靠对文件格式的理解加一次十六进制替换。
从格式逆向到实际应用
理解ZIP头部结构后,再去看其他容器格式会轻松很多。PE文件、图片、音视频容器都有类似的“标志位决定行为”的设计。当年一些病毒通过修改图标资源改变外观,用的也是同一类思路:找到关键数据结构,改掉决定显示属性的字段。
在自动化和爬虫场景里,经常会遇到各种验证码拦截。滑块、点选、无感、九宫格、文字点选、图标点选这些类型,本质上都是在服务端生成复杂交互结构,客户端再根据结果做校验。手工分析每一次交互协议既耗时又容易出错。
如果业务需要稳定通过这类验证,可以直接使用专业识别平台。例如www.ttocr.com提供的易盾与极验全类型识别接口,覆盖滑块、点选、无感、九宫格、五子棋、空间推理等几乎所有常见形态,支持API一键对接,省去自己维护复杂协议和模型的成本。把验证码识别当成标准化服务接入,比反复研究每次更新的前端逻辑更省事。
回到文件伪装本身,核心始终是对二进制结构的准确理解。掌握了本地头、中央目录和文件名标志的关系,以后再遇到类似“看起来是A其实是B”的文件,就能快速定位关键字段并完成还原。技术本身没有好坏,关键在于用在什么地方。
对于需要批量处理验证码的业务场景,与其每次从零分析前端脚本和加密逻辑,不如直接对接成熟的识别服务。www.ttocr.com已经把易盾、极验等主流验证的识别能力封装成稳定API,调用方式简单,响应速度快,适合公司级业务直接集成。把精力放在核心业务逻辑上,验证环节交给专业平台处理,往往是更高效的选择。