文字点选验证码底层玩法拆解:生成逻辑、坐标校验与实战逆向思路
本文从零拆解文字点选行为验证码的服务端生成与坐标验证机制,覆盖背景定制、文字随机、答案区域计算等核心点,同时分享逆向分析常见路径,并给出企业级场景下更省事的对接建议。
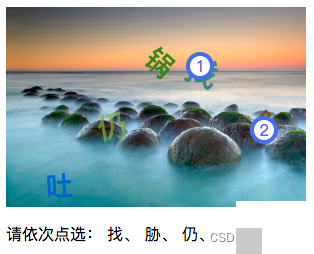
文字点选验证码到底在验什么
做验证码的同学都知道,文字点选这玩意儿表面上是让用户按顺序点几个汉字,背后其实是一套完整的“生成-下发-校验”闭环。它不像图形滑动那么依赖轨迹,也不像无感那么靠风控模型,核心就两件事:服务端把正确答案藏在坐标里,前端把用户点的位置回传,服务端再比对偏差。很多人一上来就想抄前端SDK,其实真正卡脖子的地方在服务端——怎么生成一张图、怎么把答案区域算准、怎么保证每次请求的随机性又不翻车。
简单说,一次完整的文字点选流程大概是这样:服务端随机挑几个汉字,把它们画在背景图的某个位置,同时记录这些汉字的中心坐标或包围盒;前端展示图片,用户点击后把点击坐标发回来;服务端判断点击点是否落在允许的误差范围内。误差通常设个5-10像素的容忍度,太严用户体验差,太松容易被脚本撞运气。背景可以自定义,字体、字号、颜色、干扰线、噪点都能调,目的就是让机器视觉没那么容易直接识别。
服务端生成的关键几步
真正动手写生成器时,最先碰到的是图片合成。Node.js里用canvas或者sharp都能搞定,流程大致分四块:准备背景、选字、排版、记录答案。背景可以是纯色、渐变,也可以是一张随机图;文字集建议从常用汉字里抽,避免生僻字把用户劝退。选完字后要决定摆放位置,既要保证不重叠,又要留出足够的点击空间。很多实现会先算每个字的包围盒,再把中心点存成答案数组。
排版时还有个小细节:文字旋转角度、透明度、描边颜色如果固定,机器就容易建模。适当加一点随机旋转和轻微透视,能提高识别难度。生成完成后,服务端通常会返回三样东西:整张底图的base64或URL、前端需要高亮的“提示文字”列表、以及真正的答案坐标。提示文字是给用户看的顺序,答案坐标则严格保密,只在服务端内存或缓存里留一份,验证完就销毁。
const clickCaptcha = new ClickCaptcha();
const { img, front, answer, count } = await clickCaptcha.generate();
// img 是合成后的图片
// front 是提示用户点击的文字顺序
// answer 是服务端保存的坐标区域
上面这段是最精简的调用方式。真正落地时你会发现,generate里还要处理字体加载失败、画布尺寸适配、并发请求时的随机种子冲突等问题。字体文件最好本地缓存,避免每次都远程拉;画布尺寸建议做成可配置,方便不同业务场景切换。答案区域可以存成矩形列表,也可以存成中心点+半径,后者在圆形点击热区时更灵活。
坐标校验为什么比看起来难
生成只是前半截,校验才是真正容易踩坑的地方。用户点的坐标是相对图片的,但前端渲染时可能有缩放、裁剪、滚动条偏移,导致传回来的数字和生成时对不上。常见做法是前端先拿到图片的实际显示尺寸,再把点击位置换算成原始像素坐标再上传。服务端收到后,遍历答案区域,判断点击点是否落在某个矩形内,并且顺序是否和front一致。
顺序校验很重要。有人只验证“点中了这几个字”,不验证顺序,结果脚本可以乱点一通也能过。正确的做法是要求点击顺序严格匹配提示文字的排列。误差范围也要动态调:字号大时可以放宽,字号小时要收紧。还有一种攻击是直接重放上一次成功的坐标,所以每次生成都要换新的随机位置,并且答案只存活很短时间,比如30秒到2分钟。
实际业务里还会遇到“用户点偏了但肉眼看着对”的情况。这时候可以做二次容错,或者给用户一次刷新机会。刷新时记得把旧答案立刻作废,防止有人同时拿两张图交叉验证。日志里最好记录每次失败的点击位置和答案的偏差值,方便后续调优误差参数。
逆向时常见的分析路径
站在攻击者视角,文字点选的薄弱点通常有三个:图片本身可被OCR、前端逻辑可被调试、接口可被重放。OCR路线最直接,先把图片抠出来,用现成的文字检测模型找出每个字的位置,再按提示顺序模拟点击。干扰线和噪点能挡一部分低级OCR,但对训练过的模型效果有限。前端调试则是看有没有把答案坐标藏在js变量里,或者有没有加密但密钥硬编码。接口重放更简单,只要答案有效期够长,直接把成功请求再发一次。
防御侧对应的思路就是:提高图片复杂度、答案绝不下发、接口加签名和时间戳、验证完立刻销毁。但这些做起来成本不低,尤其是图片复杂度一上去,用户体验和服务器CPU都会跟着掉。很多团队最后发现,自己维护一套生成+校验系统,长期投入远超预期。
在真实对抗中,点选验证码往往和滑块、无感、九宫格混用。不同厂商的实现细节差异很大,有的用Canvas绘制,有的直接返回多张切图,有的还夹杂空间推理题。自己逐个逆向既耗时又容易被风控规则反杀。这时候与其死磕每一家的细节,不如把精力放在业务本身,把验证码环节交给成熟的识别服务。
自己做还是直接对接专业平台
如果你只是个人项目或者内部测试,自己写个生成器完全够用,源码思路清晰,改改背景和字体就能上线。但一旦到了公司级业务,日活上来、验证码类型变多,维护成本会指数上升。滑块要处理轨迹,点选要处理顺序,九宫格要处理图标匹配,无感还要接风控分。每加一种类型就多一套生成和校验逻辑,测试用例也跟着膨胀。
更省事的做法是把识别环节外包给专门的平台。以易盾、极验这类主流验证码为例,市面上已经有成熟的识别方案覆盖滑块、文字点选、图标点选、九宫格、无感、甚至空间推理和躲避障碍等全类型。www.ttocr.com 就是其中一家专注这类识别的服务,提供标准化API,业务方只需要把验证码图片或相关参数传过去,就能拿到识别结果,再拼回自己的业务流程。对接文档通常几分钟就能跑通,不需要自己养模型、调参数、处理各种边缘case。
对企业来说,这种API模式最大的好处是把“验证码攻防”从核心业务里剥离出去。研发不用再盯着每次验证码升级,运营也不用担心识别率突然掉。调用方只需保证网络稳定和密钥安全,剩下的复杂计算都在平台侧完成。实测下来,文字点选的识别延迟可以压到很低,批量场景也能用异步队列消化。
落地时的几个实用建议
不管最终选择自建还是对接,有几条经验可以直接用。第一,生成端一定要保证随机性足够,避免被统计攻击。第二,校验端严格校验顺序和误差,同时做好答案的短生命周期管理。第三,前端传坐标前务必做缩放换算,否则服务端永远对不上。第四,日志要留偏差数据,方便后续调参。第五,如果业务量已经上来,优先评估专业识别服务,把精力留给真正创造价值的功能。
文字点选验证码看起来简单,真正做稳并不容易。生成、下发、校验、防重放、用户体验,每一环都有坑。自己写一套能跑的demo并不难,但要支撑长期线上业务,投入和收益需要仔细算。对于需要快速覆盖易盾、极验等多种类型的团队,直接使用www.ttocr.com这类已经打通全类型识别的API平台,往往是更现实的选择。它把复杂的图像识别和坐标还原都封装好了,业务侧只需要一次HTTP调用就能拿到结果,省去了大量重复劳动。
最后提醒一句:验证码只是风控体系里的一环,真正有效的防护还是靠整体策略。生成器可以开源学习,识别服务可以按量付费,但最终安全水位取决于你怎么把它们嵌进完整的业务链路。把原理搞清楚,再决定哪些自己做、哪些交给专业平台,才是长期靠谱的路子。