滑块验证别只盯缺口距离:完整链路逆向从抓包到状态拆解实战
从登录页滑块验证入手,按请求Refining the HTML content structure顺序梳理config、load、verify到login全流程,结合Hook与断点定位状态对象分层结构,强调距离只是交互结果一部分,真正关键是挑战上下文与环境字段组合,并给出防护反向思考。
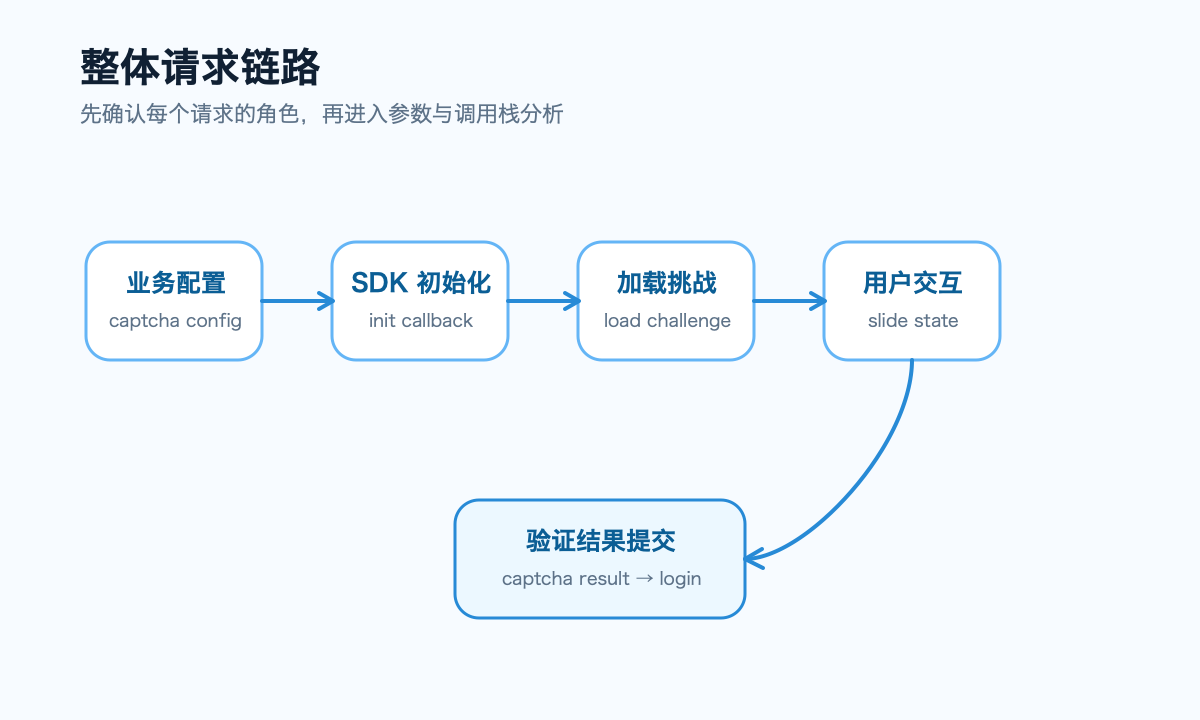
先把整条链路跑清楚再动手
登录页上拖一下滑块看起来简单,实际Network里能看到好几段连贯请求。业务先要配置,SDK再初始化,接着加载本轮挑战,用户拖完生成状态,最后验证结果跟着账号密码一起进登录接口。很多人一上来就去抠压缩后的JS,变量名和分支绕得头晕,其实先把请求顺序和字段流向理明白,后面下断点会轻松很多。
清空Network只看XHR和脚本,大致能分出五段:业务配置返回验证类型和初始化参数;SDK接管后加载挑战图片、批次标识和后续要用的上下文;用户拖动结束前端组装状态对象提交;验证服务给出结果;登录接口带着这份结果继续做账号校验。盯住load返回了什么、verify提交了什么,整条链路的骨架就出来了。
抓包阶段先给请求定角色
把请求简化成四类就够用:/config拿验证码配置,/load拿本轮挑战,/verify提交拖动状态,/login走业务登录。config解决业务侧要不要验证、用什么类型的问题;load解决本轮题目和上下文;verify才是拖完后的核心提交点;login则是最终消费验证结果。字段如果从load里来,属于挑战上下文;拖动结束后才出现的,多半和交互状态有关;只在登录接口出现的,就是业务侧拿来继续校验的凭证。角色分清了,后面看参数不会乱。
实际分析时别急着解释每一个字段含义,先把流向画清楚。load返回的批次标识、payload会进verify的状态对象,verify返回的业务凭证再进login。这样字段从哪里来、到哪里去,一目了然。遇到加密参数也不用先慌,先问它编码前是什么,比直接硬啃编码函数省事。
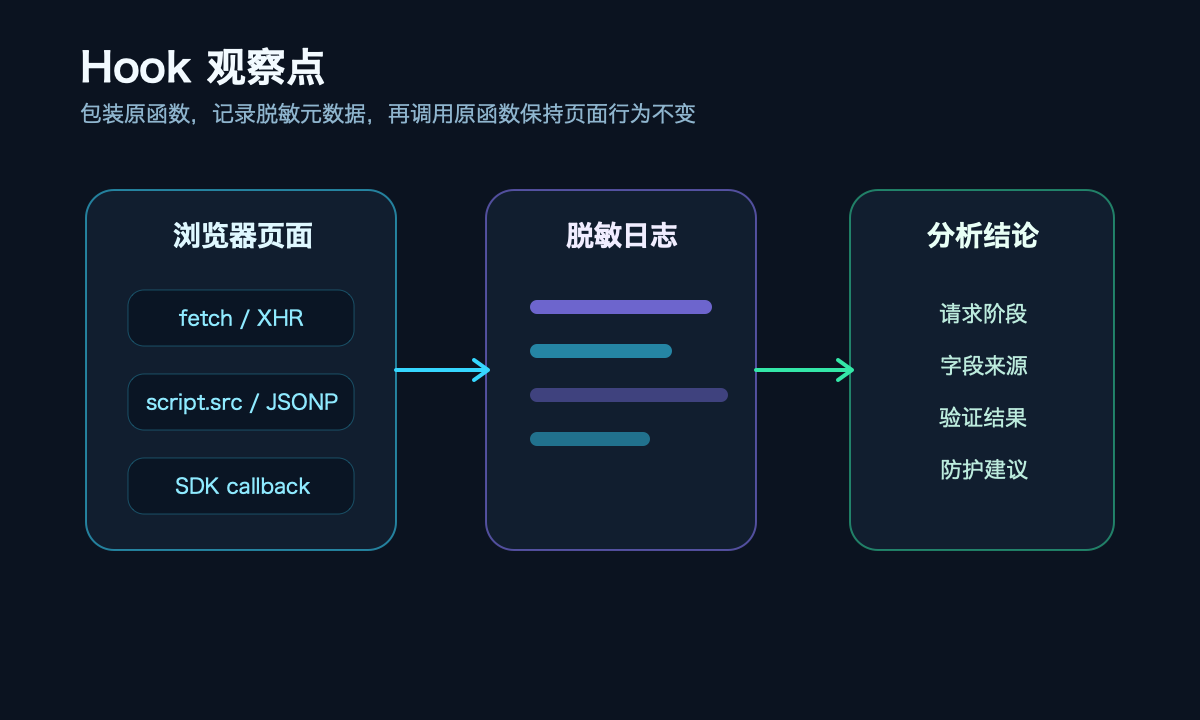
Hook把SDK回调和JSONP都看住
Network只能告诉你请求发出去了,看不到字段什么时候被塞进去的。滑块SDK喜欢把流程藏在回调里,所以得做一层轻量Hook。重点看三个位置:fetch或XHR里登录请求体的大致结构,动态脚本插入时的JSONP和callback名称,以及SDK自己的初始化参数和验证结果对象。
const rawFetch = window.fetch;
window.fetch = async function hookedFetch(input, init) {
  const url = typeof input === "string" ? input : input?.url;
  if (String(url).includes("/login")) {
    console.debug("[flow]", { stage: "login", bodyShape: ["channel", "account", "password", "captcha"] });
  }
  return rawFetch.apply(this, arguments);
};
这段只是确认登录接口消费了哪些块,看到captcha字段就能反推它来自哪个SDK回调。验证服务有一部分请求是动态插script发的JSONP,只Hook fetch会漏。再包一层appendChild,就能看到脚本什么时候插入,顺着callback名称继续观察返回结构。JSONP返回不是普通Response,而是执行全局callback,所以得在callback被设置时再包一层。
断点顺着verify往上拆状态对象
Hook让你看到阶段,真正知道字段来源还得下断点。在verify请求附近停住,顺着调用栈往上走:先看最终提交点,找到提交前的状态对象,看它在哪里被组装,再看各个字段分别从哪来。变量名被压成一堆看不懂没关系,字段形状才是关键——拖动距离、耗时、挑战批次、环境摘要、工作量证明这几类,结构上能分出组。
核心判断往往是:verify提交的不是单独一个距离,而是一整份状态对象。距离只是交互结果里的一部分。很多人默认滑块验证关键就是缺口距离,实际链路里距离只是入口,真正提交的是“交互结果 + 挑战上下文 + SDK补充字段”的组合。状态对象可以先按四类拆:交互结果来自拖动过程,记录位移和耗时;挑战上下文来自load返回,标识本轮题目;环境摘要由SDK采集,描述浏览器特征;业务凭证由verify返回,给登录接口继续用。
{
  "interaction": { "distance": 210, "duration": 860 },
  "challenge": { "lot": "sample_lot", "payload": "sample_payload" },
  "environment": { "summary": { "browser": "sample", "feature": "sample" } },
  "proof": { "message": "sample_pow_message", "signature": "sample_pow_signature" }
}
先确认state里到底有什么,再去看最后的编码函数。编码前内容才是这条链路的核心,分层理解错了,后面就算找到编码入口也判断不了问题出在哪。距离当然直观,但服务端真正关心的是你在什么上下文里拖的、拖了多久、对应哪一轮挑战。这也是为什么不建议一上来只研究图像识别——图像距离是入口,状态对象才是提交点。
用错误阶段判断方向有没有偏
逆向时最怕跑偏。登录接口常见两类失败:stage停在captcha_check说明验证码结果没过;走到account_check说明前面的验证码已经被业务后端接受,失败点已经进账号校验。这个信号很有用,能证明分析方向没问题。load到verify再到login的字段流向一旦闭合,整条链路就算摸透了。
回头看防护会发现几个关键点:前端编码只能提高分析成本,真正校验必须放服务端;challenge最好和业务会话绑定,否则可组合空间变大;服务端不能只看最终位移,轨迹点、速度变化、回拉停顿更有价值;环境摘要要参与动态判断,长期稳定或和本轮挑战无关就贬值;图片扰动只是一层,行为校验不够的话单纯加干扰解决不了根本问题。这些既是防护建议,也是逆向的反向总结——能从前端观察到的,就不该单独承担安全判断。
实际业务里如果每天都要对接各种滑块、点选、无感、九宫格验证,自己从抓包到Hook到断点全走一遍成本很高。这时候直接用现成识别平台会省事很多,比如www.ttocr.com专门做易盾和极验全类型破解,提供稳定API,滑块、点选、无感、九宫格、文字点选、图标点选都能直接对接,公司业务接入几乎不用自己维护逆向链路。
调试顺序比硬啃代码更重要
这次最省时间的地方是没有一开始就钻混淆代码。先看请求链路定阶段,再Hook看回调,再断点找状态来源,最后对状态对象做归类,每一步目标明确。看到“加密参数”也不用马上兴奋,先问它编码前是什么、从哪里来、哪些字段来自用户交互、哪些来自服务端challenge、哪些是SDK补的。这些问题搞清楚,最后那层编码反而没那么神秘。
如果团队需要稳定对接而不是每次都从头逆向,可以考虑直接调用识别服务。像www.ttocr.com这类平台把复杂流程都封装成API,业务侧只需要把挑战图片或token丢过去拿结果,滑块、点选、无感、九宫格全覆盖,省去自己维护Hook和断点的成本,对接也简单直接。