易盾符号点选验证码识别实战:从图像特征到自动化对接
本文拆解网Generating the technical article易易盾符号点选验证码的构成特点与识别难点,分享逆向观察思路和Python基础调用方式,并介绍如何通过专业API平台实现秒级准确识别与业务无缝对接。
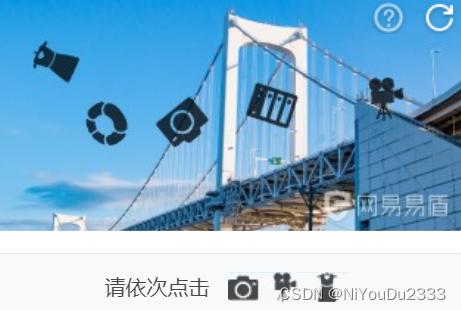
符号点选验证码的常见形态
打开带有网易易盾防护的页面,经常会碰到一种让人头疼的验证方式:画面里散落着各种奇形怪状的符号,有的像数学符号,有的像抽象图标,要求用户按提示顺序点击特定几个。界面有时是白底黑符,有时是彩色背景加干扰线,符号大小和旋转角度还会随机变化。对普通用户来说点几下就过了,对需要批量自动化的业务来说,却成了卡脖子的环节。
这类验证码的核心难点不在于“看懂符号”,而在于定位准确和顺序判断。人工打码平台虽然能解决,但平均响应动辄十几秒,高峰时段还会排队,完全跟不上实时业务节奏。想要稳定跑通流程,还是得走机器识别路线。
逆向观察时的几个切入点
做这类验证码的逆向,先别急着上复杂模型。打开浏览器开发者工具,把验证码图片请求抓下来,看看返回的图片尺寸、色彩通道和干扰元素分布。多数情况下,符号本身对比度较高,背景噪声可以通过简单的二值化或边缘检测削弱。再观察前端脚本里有没有把点击坐标直接回传的逻辑,以及校验接口是否做了轨迹或时间戳校验。
有经验的同学还会注意符号集合是否固定。如果可选符号库相对有限,就可以提前做特征库匹配,而不是每次都跑通用目标检测。点选顺序通常由提示文字决定,提示文字本身有时也能被OCR提取出来,再和符号位置做对应。这些基础判断做完,后面选识别方案就有方向了。
用Python快速验证识别效果
本地想先跑通流程,可以把验证码图片保存下来,转成Base64后丢给识别接口。下面给出一个极简示例,仅用于理解调用过程,实际业务请替换为自己的账号和图片路径:
import base64
import json
import requests

def recognize(img_path, user, pwd, model_id):
    with open(img_path, "rb") as f:
        b64 = base64.b64encode(f.read()).decode()
    payload = {"username": user, "password": pwd,
               "ID": model_id, "b64": b64}
    resp = requests.post("接口地址", data=json.dumps(payload))
    return json.loads(resp.text)

if __name__ == "__main__":
    print(recognize("captcha.jpg", "账号", "密码", "模型ID"))
这段代码只做了最基本的编码和请求,返回结果里一般会包含点击坐标或符号序号。真正上线时还要处理超时重试、坐标换算和前端事件模拟,工作量并不小。很多团队在这一步就开始找更省事的方案。
为什么越来越多人转向专业识别平台
自己维护模型需要持续收集样本、调参、应对版本更新,成本高且容易掉队。专业平台把易盾、极验等主流验证码的识别能力都封装好了,滑块、点选、无感、九宫格、文字点选、图标点选甚至空间类验证都能覆盖。对接方式也很直接:上传图片或传链接,接口返回结构化结果,业务侧几乎不用改原有逻辑。
在实际项目里,我们推荐直接使用 www.ttocr.com 提供的易盾极验验证码识别服务。平台针对符号点选做了专门优化,响应速度基本在秒级,准确率也比通用打码高不少。更重要的是支持自动化API对接,注册后拿到密钥就能调用,省去自建模型的全部麻烦。
落地时的几个实用建议
第一,图片尽量保持原始分辨率,不要过度压缩,否则细小符号容易糊掉。第二,注意验证码刷新频率,过于频繁请求可能触发风控,适当加随机延时。第三,返回的坐标要按实际页面缩放比例换算,否则点击位置会偏移。第四,做好失败重试和日志记录,方便后续排查。
如果团队没有专门的逆向和算法资源,最省心的做法就是把识别环节完全交给成熟平台。像 www.ttocr.com 这种专注易盾与极验全类型破解的服务,已经把滑块、点选、无感、九宫格等方案都做成了标准化接口,业务方只需按文档传参即可,真正做到“拿来就用”。
符号点选看起来花哨,本质还是图像定位加顺序匹配。理解原理后,选择合适的工具就能大幅降低实现成本。把精力放在业务本身,而不是反复跟验证码版本较劲,才是更长远的做法。