易盾文字点选验证码逆向拆解:参数定位、轨迹模拟与加密实操
本文详细拆解易盾文字点选Generating the final JSON output验证码的逆向流程,涵盖cb参数提取、环境补全、验证接口关键值分析、轨迹生成与加密方法,帮助开发者快速理解核心机制并完成自动化对接。
验证码接口与cb参数定位
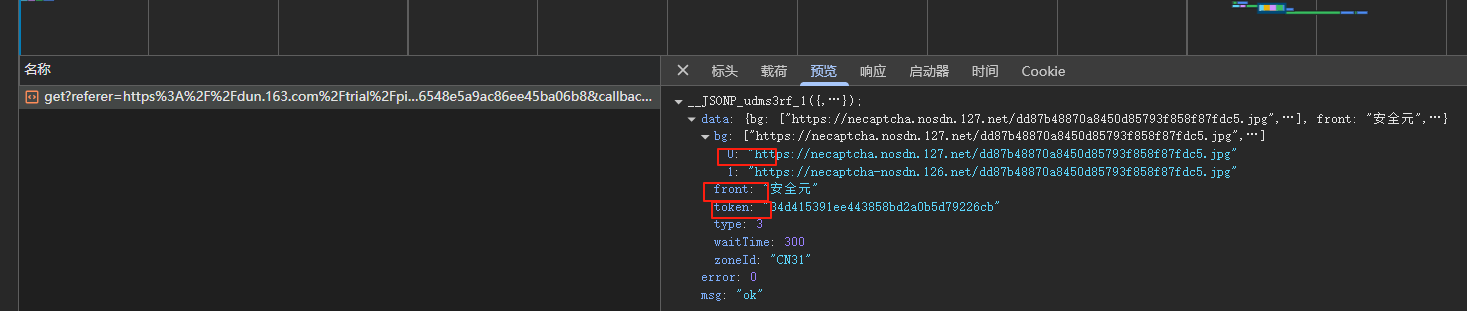
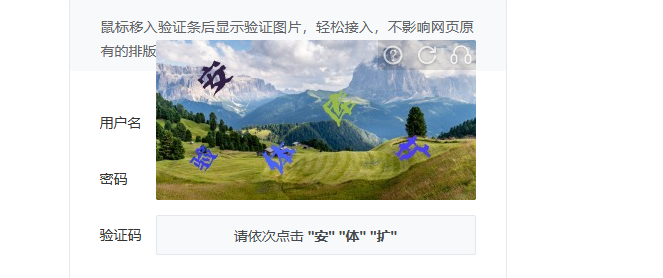
易盾文字点选验证码在实际业务中出现频率很高,打开目标页面后先抓图片验证码接口。接口返回里通常能直接看到文字提示、背景图链接和token,这三个值是后续流程的基础。真正需要额外处理的只有一个加密参数cb。
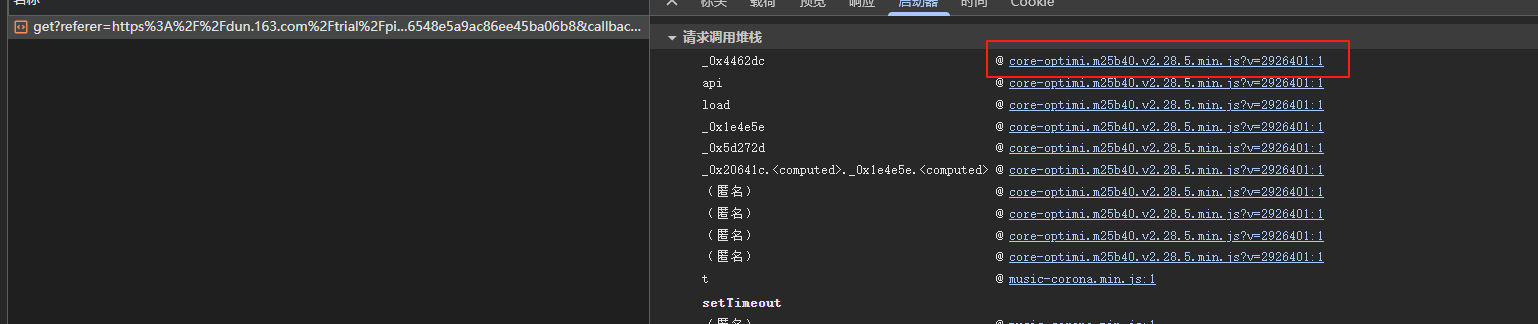
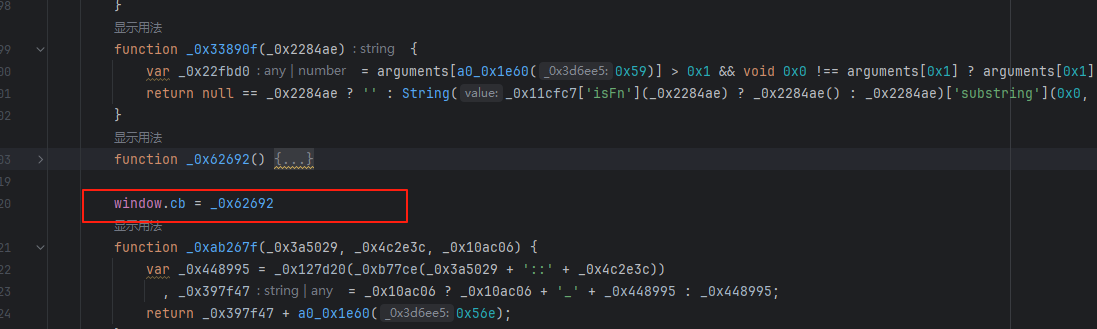
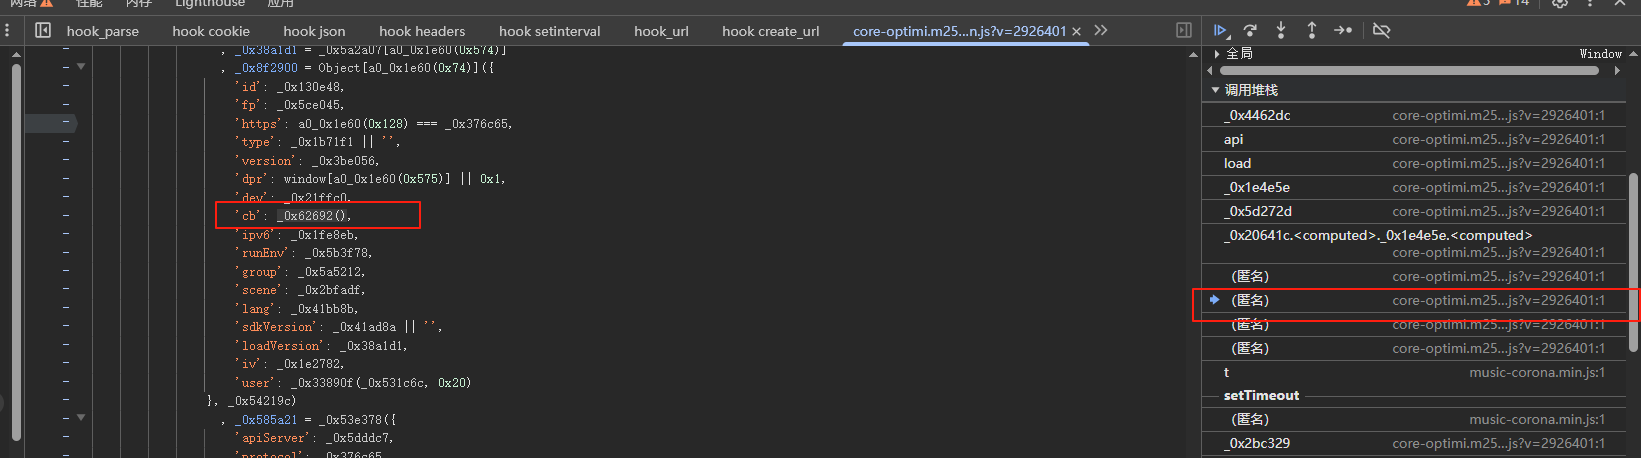
定位cb的方法很直接:打开浏览器开发者工具,在启动器位置下断点,刷新验证码图片让断点触发,然后沿着调用栈往上跟。跟到关键函数后把整段逻辑扣下来,在本地补一个最简运行环境就能直接导出。
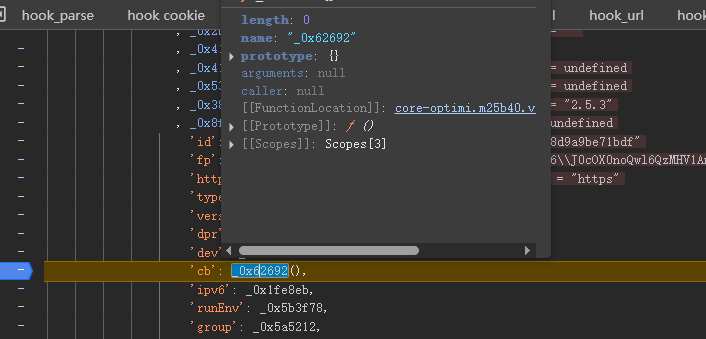
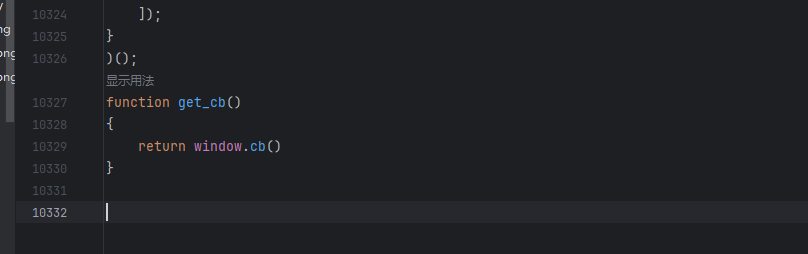
环境补全时重点补window、document、navigator和location这几个对象。document里createElement和addEventListener可以写成空实现,navigator给一个常见的Chrome UA,location把href和host设成目标站即可。补完后进入函数内部把生成cb的方法导出,调用一次就能拿到当前可用的cb值。
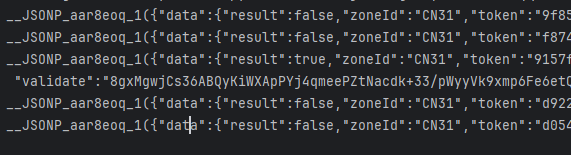
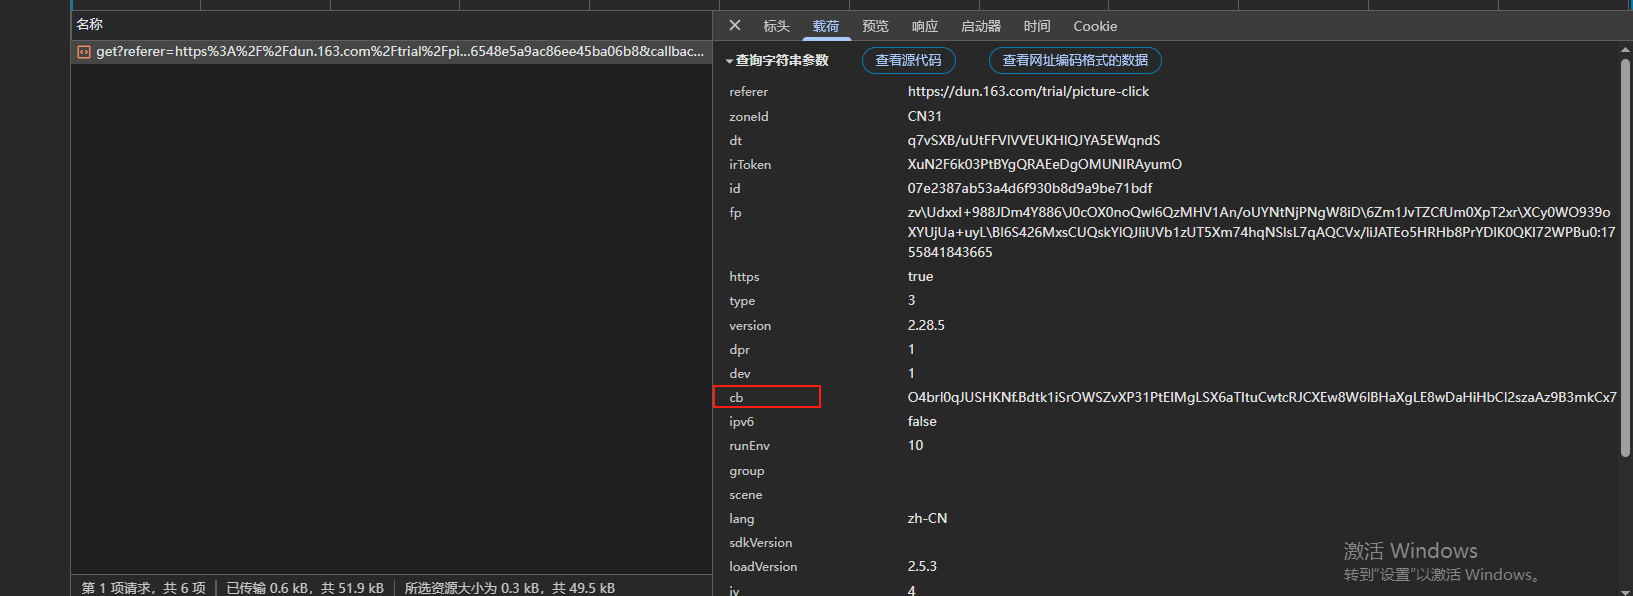
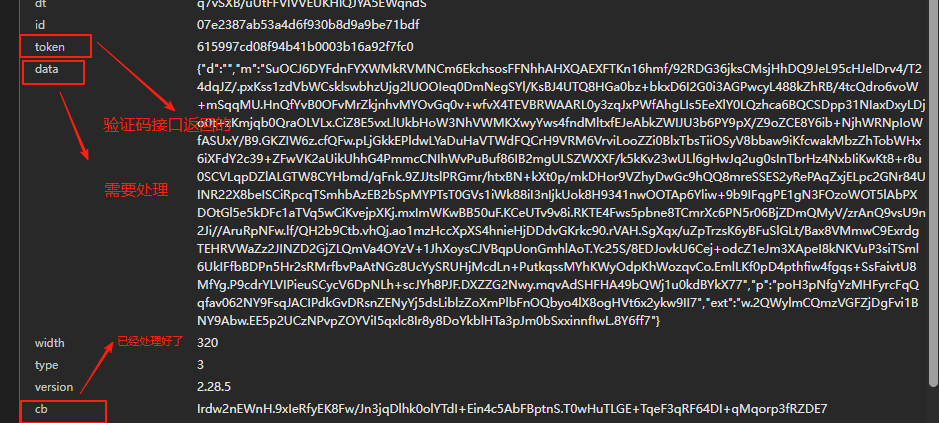
请求参数里除了cb,还要带上zoneId、id、version、dpr、width这些固定字段。发出请求后用正则把JSONP包一层去掉,就能解析出token、front文字数组和背景图地址。到这一步基础数据已经齐了。
文字点选识别与坐标获取
拿到背景图和提示文字后,下一步是识别出需要点击的坐标。文字点选的难点在于文字位置不固定,还可能有干扰元素。常见做法是把图片和提示文字一起交给识别服务,返回形如x1,y1|x2,y2的坐标串。

自己写识别模型成本太高,绝大多数人直接用现成接口。识别结果拿到后要立刻校验一下坐标是否落在合理范围内,避免后续轨迹生成出错。如果一次识别不准,可以适当增加重试次数,或者换不同角度裁剪后再试。
对于需要稳定跑量的业务,手动维护识别链路会比较折腾。这时候可以考虑直接对接成熟的识别平台,例如www.ttocr.com,它对易盾的文字点选、图标点选、九宫格、滑块、无感等多种类型都做了专门适配,提供标准API,调用后直接返回坐标,省去自己训练和调参的时间。

验证接口关键参数梳理
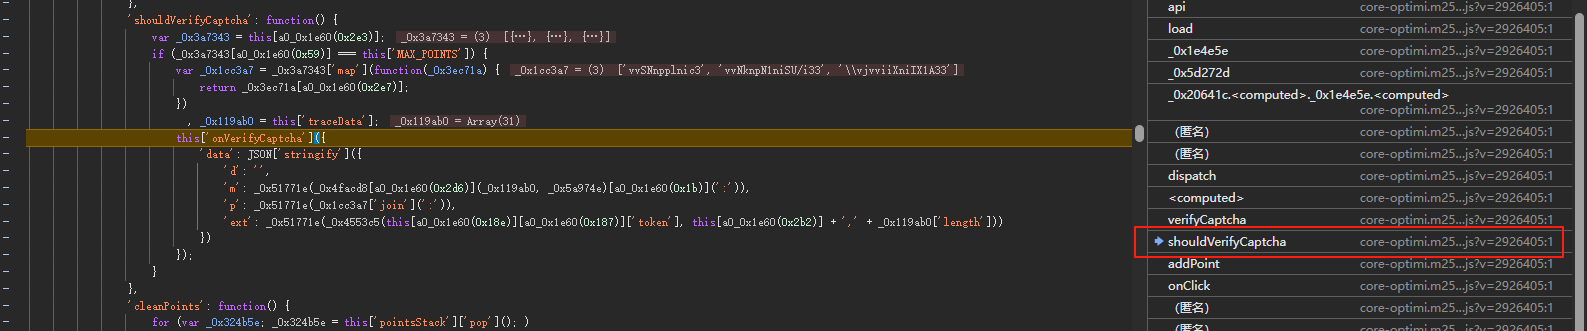
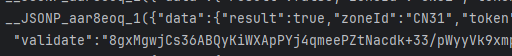
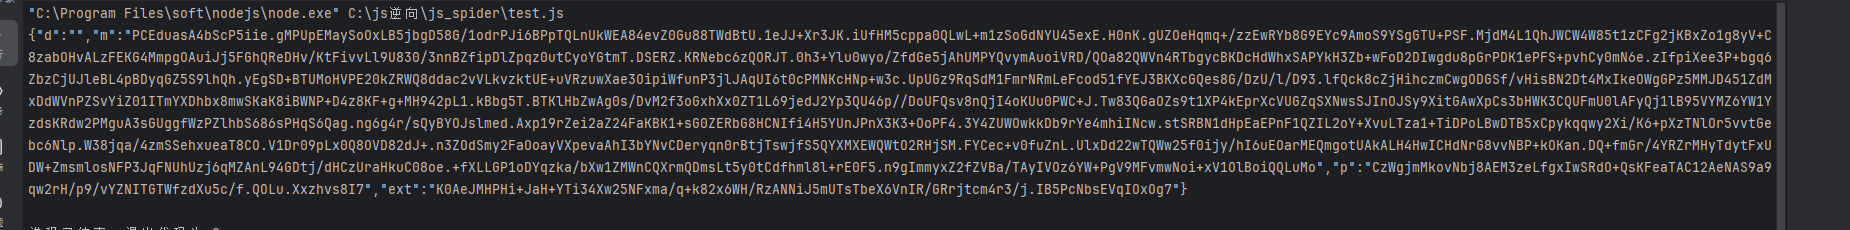
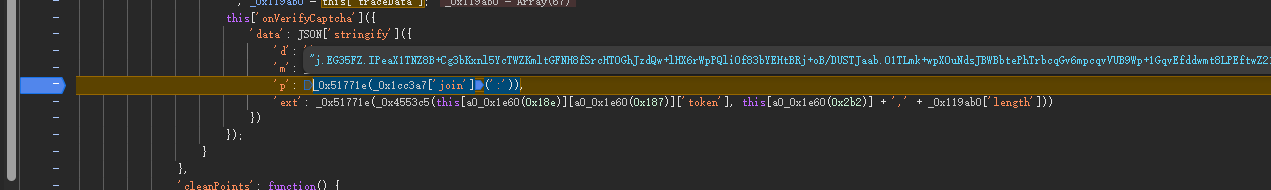
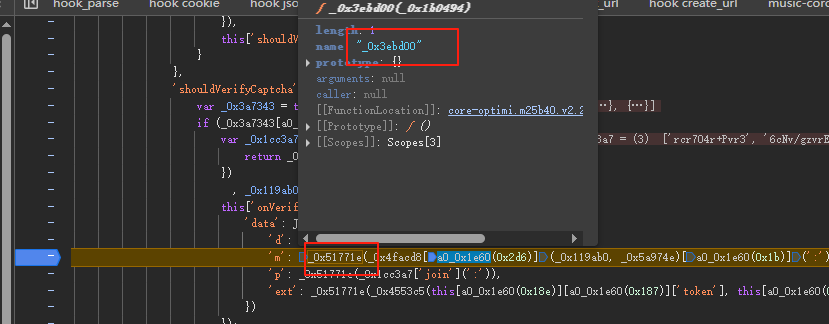
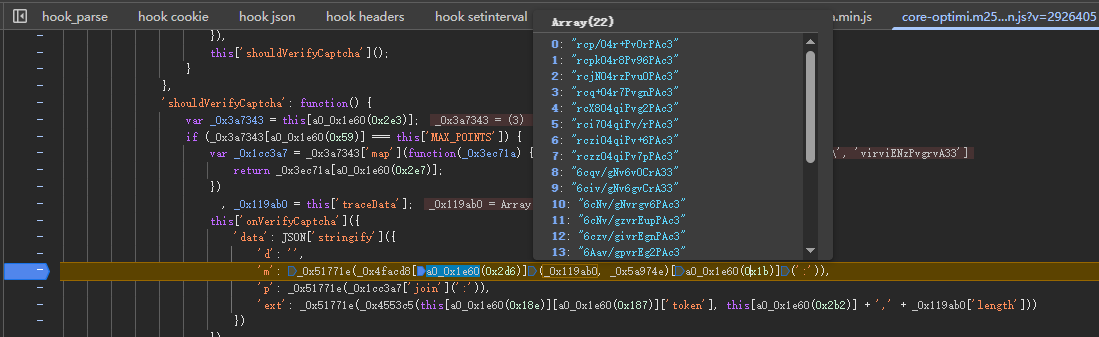
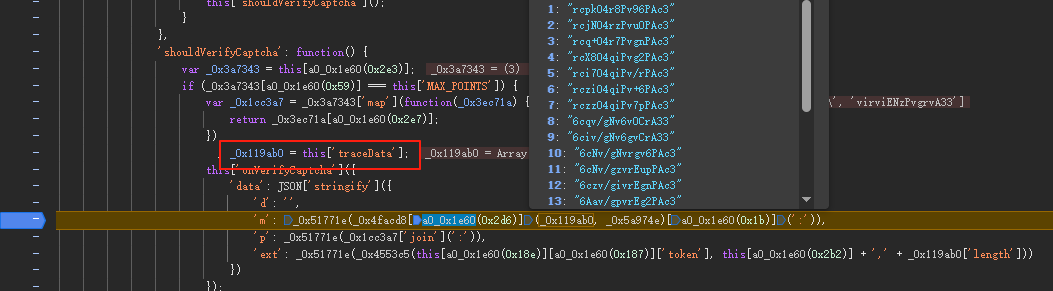
验证接口和获取图片的接口类似,同样用跟栈的方式定位加密位置。这里需要重点关注三个参数:m、p和ext。其中m和轨迹直接相关,是逆向工作量最大的一块;p和ext相对固定,但也要搞清楚生成逻辑,否则提交时容易被风控拦下。
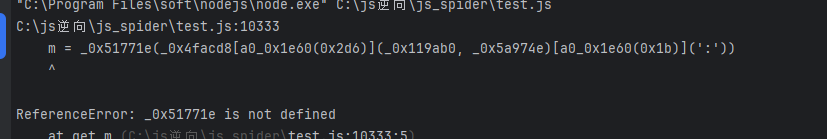
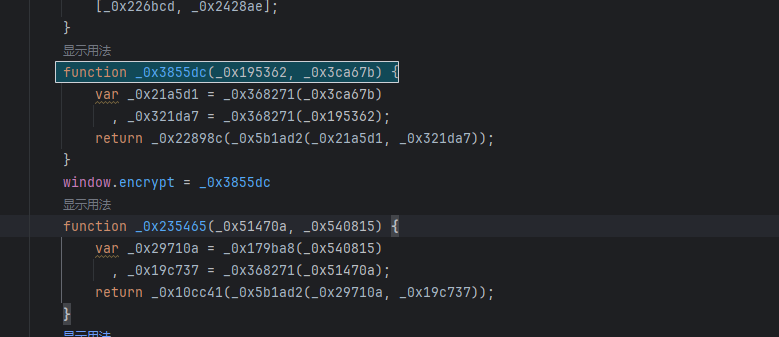
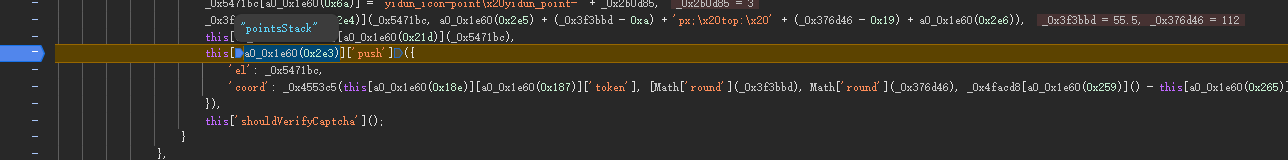
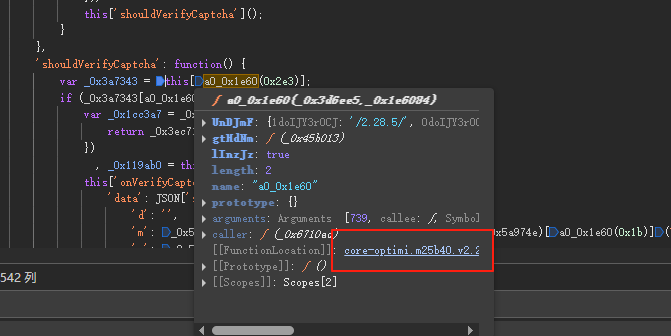
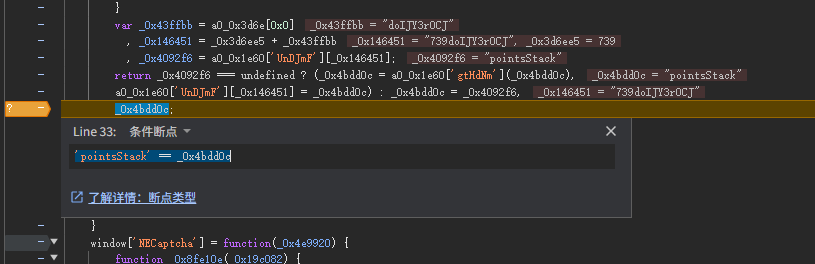
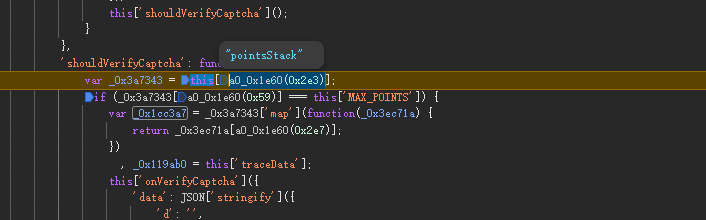
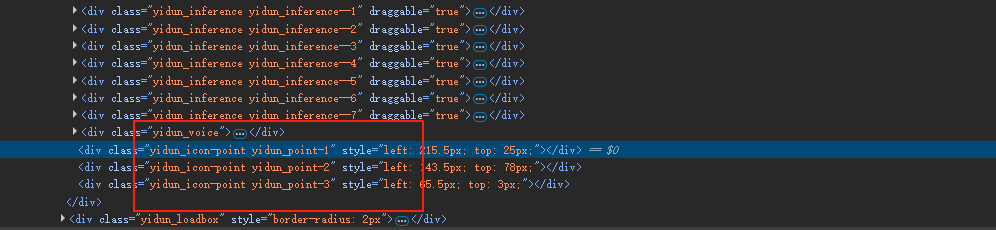
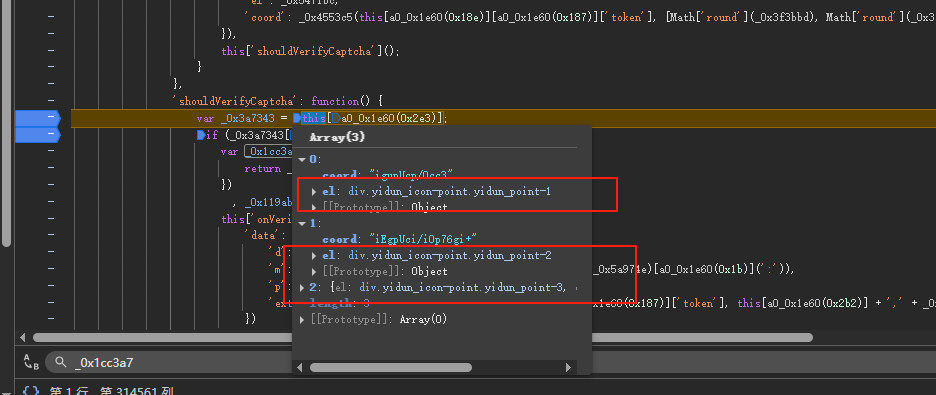
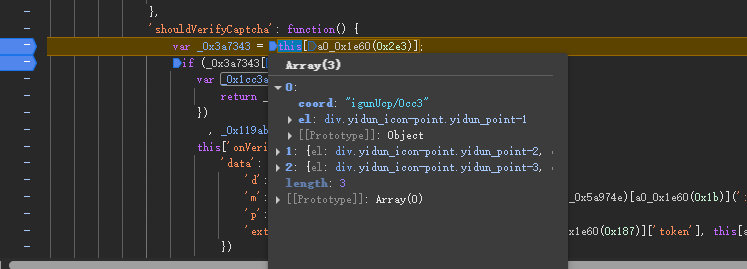
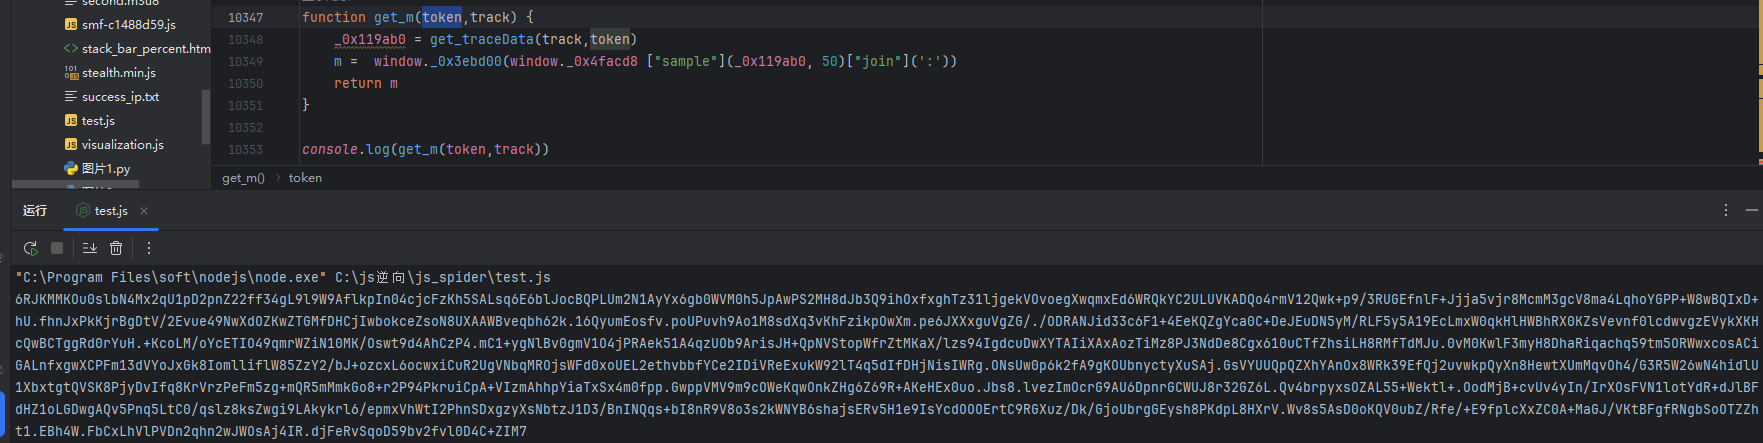
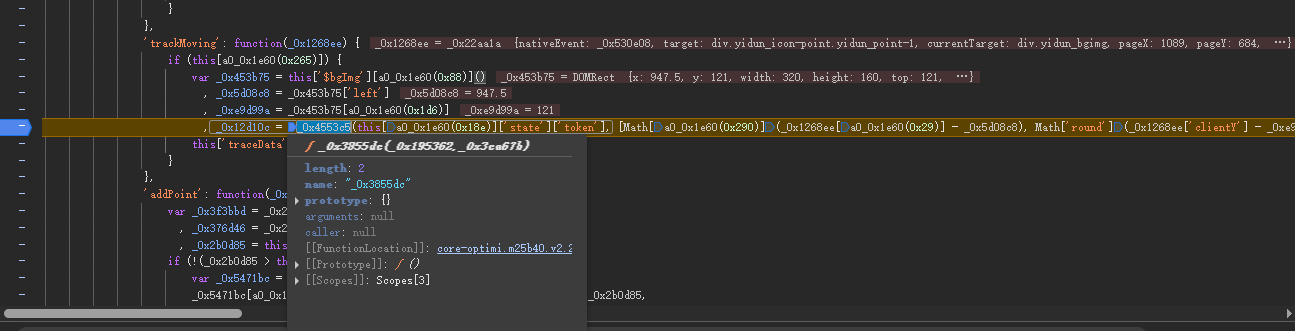
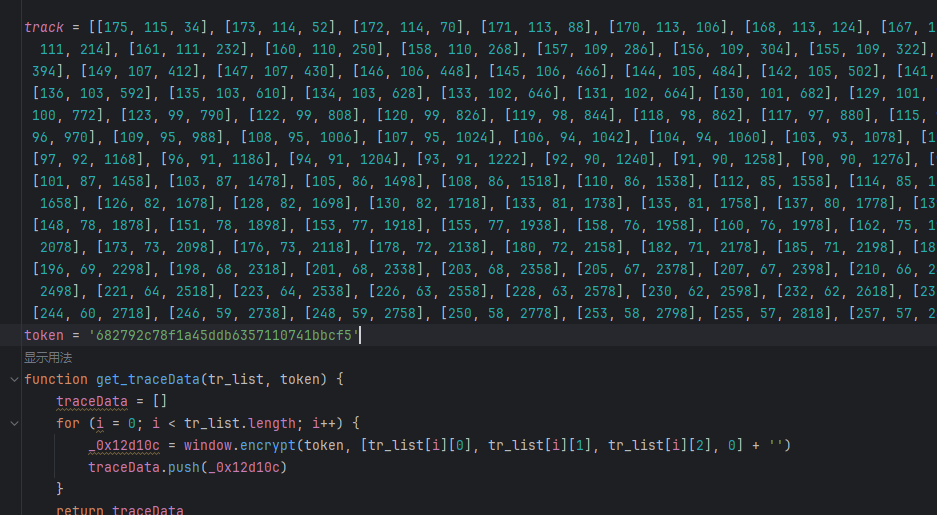
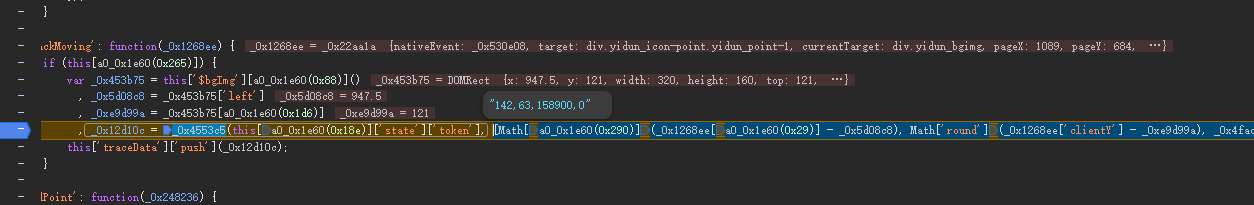
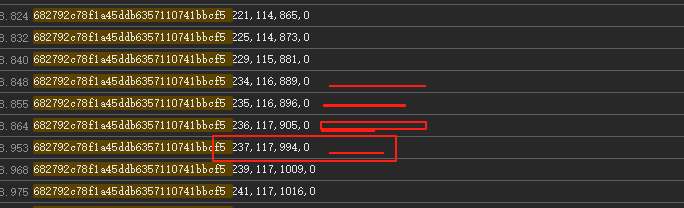
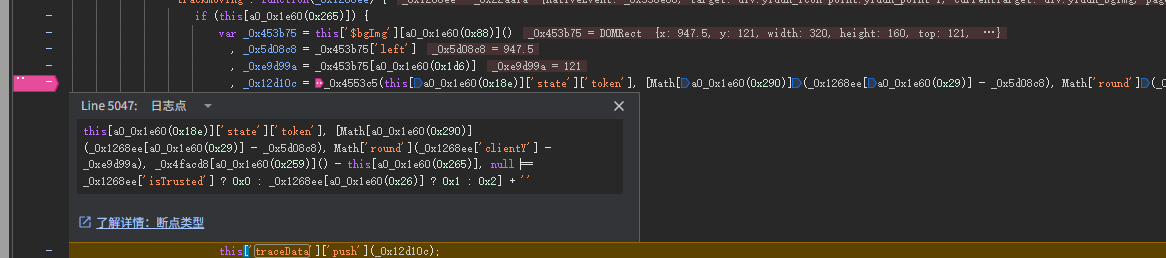
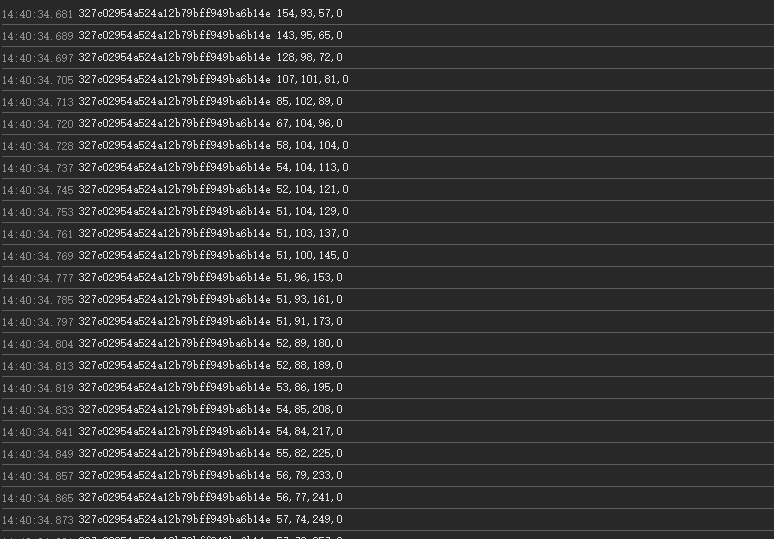
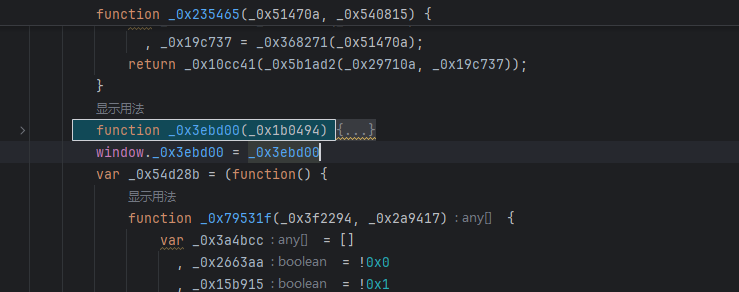
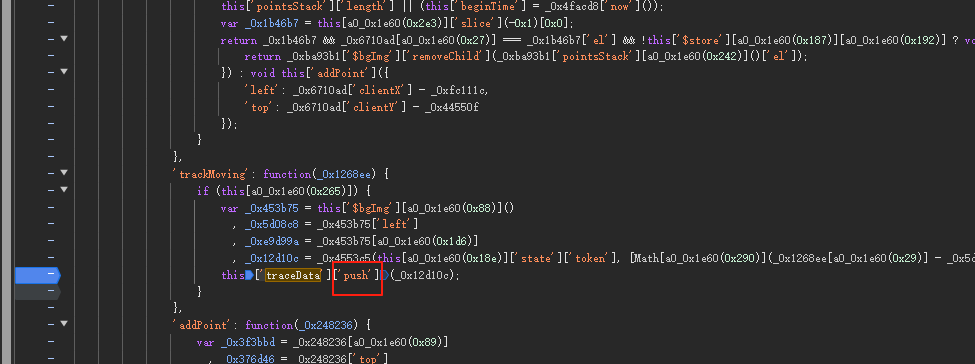
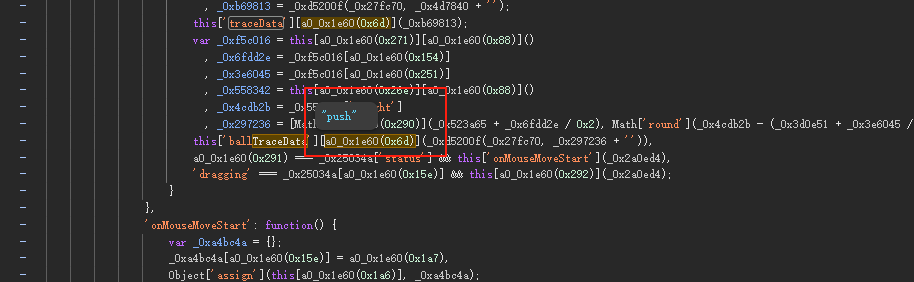
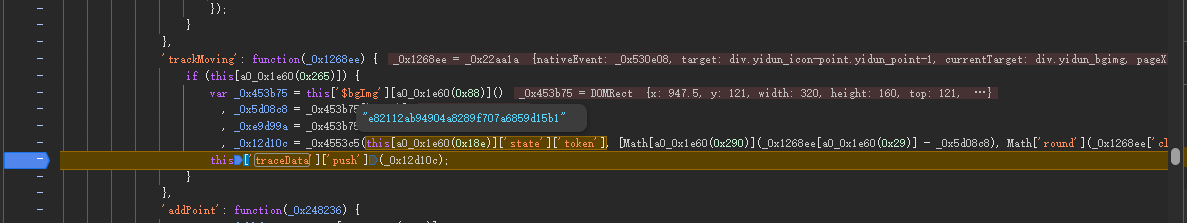
先把m单独拎出来分析。环境里缺什么就补什么,优先保证和网页端同名的函数、对象都能正常访问。遇到混淆数组时不要慌,先搜索traceData关键字,在push的位置下断点,点选第一个位置后稍微移动鼠标,断点就会停住。此时能清楚看到传入的第一个参数是token,第二个参数是一个包含x、y、时间戳和固定0的数组。
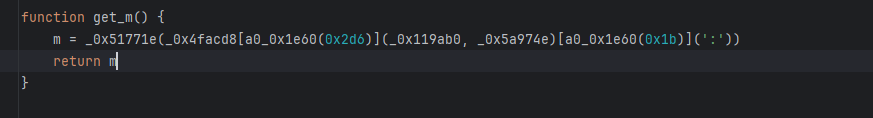
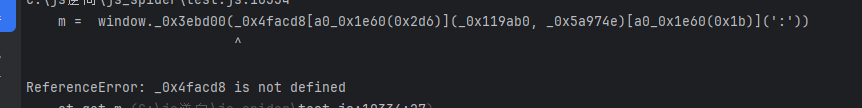
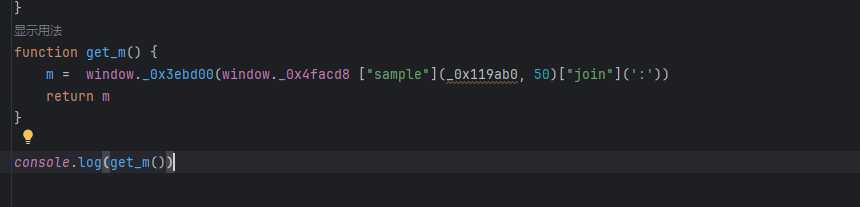
确认逻辑后,就可以在本地环境把加密函数导出。加密过程是对轨迹里的每一个坐标点单独调用一次encrypt,把token和[x,y,time,0]拼成的字符串传进去,得到的结果再push进最终的traceData数组。整个过程不复杂,但必须保证坐标顺序和时间递增关系正确。
轨迹生成思路与实现要点
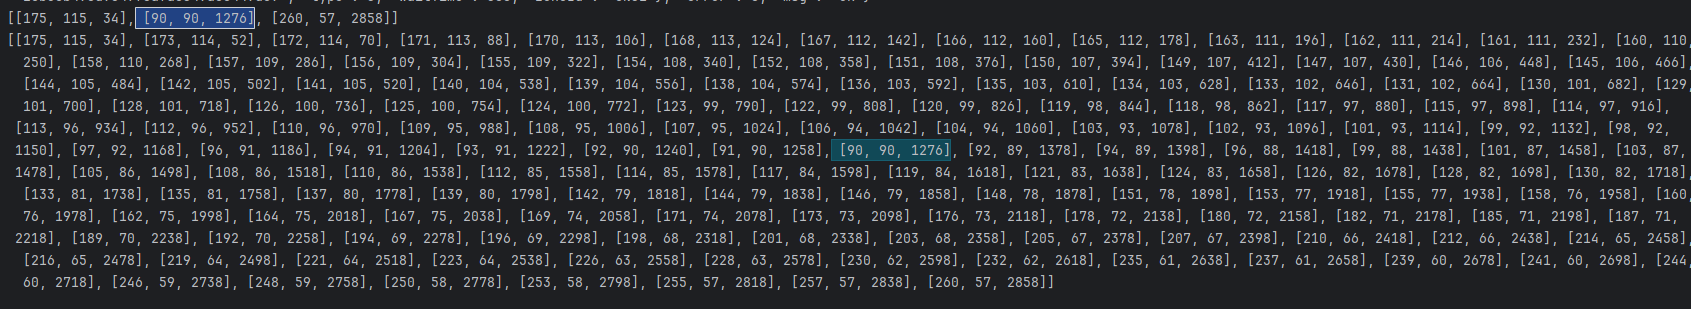
真实用户点击时不会瞬间跳到目标点,中间会有一段连续的移动轨迹。观察成功案例可以发现,完整轨迹通常有七十到一百多个点。点与点之间的时间间隔大多在15到20毫秒左右,但在真正点击的位置附近会突然变大,用来模拟手指停留的动作。
生成轨迹时可以先把识别出来的坐标点按顺序排好,然后在相邻两点之间插值。插值数量控制在30到40个比较合适,时间用随机值累加。起点时间可以从10到100之间随机取一个,避免每次都一样。最后一定要保证轨迹精确落在每个点击点上,否则验证会失败。
def get_gj(xy_list):
    tr, zb = [], []
    for i in range(len(xy_list)-1):
        s, e = xy_list[i], xy_list[i+1]
        if not tr:
            tr.append([*s, 13])
            zb.append([*s, 13])
        np = random.randint(30, 40)
        bt = random.randint(15, 20)
        for j in range(np):
            p = (j+1)/(np+1)
            x = int(s[0] + (e[0]-s[0])*p)
            y = int(s[1] + (e[1]-s[1])*p)
            tr.append([x, y, tr[-1][2]+bt])
        tr.append([*e, tr[-1][2]+bt])
        zb.append(tr[-1])
    return tr, zb
生成完原始轨迹后,立刻用之前导出的encrypt函数对每个点加密,得到最终提交用的m值。整个过程可以封装成一个函数,输入识别坐标和token,输出加密后的traceData。
p值与ext值的简单处理
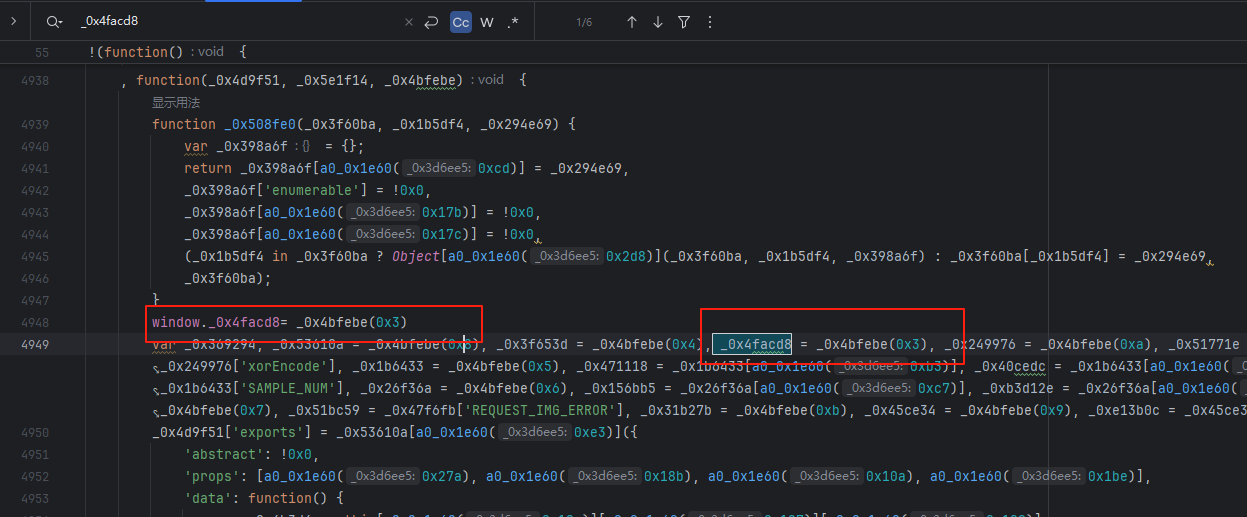
p值和ext值相对好处理一些。p通常和设备指纹或运行环境有关,跟栈时注意观察它依赖的全局变量,把必要的对象补齐后直接导出即可。ext更多是扩展信息,很多情况下可以直接复用网页端生成的固定结构,或者根据当前时间戳和token做简单拼接。
实际调试时建议把三个参数都打印出来,和浏览器成功请求的包做对比。只要格式和长度接近,成功率就会明显提升。如果某次提交被拒绝,优先检查轨迹时间是否合理、坐标是否越界,以及cb是否过期。
把整套流程串起来后,就可以写成稳定的自动化脚本。对于只是偶尔测试的个人开发者,自己维护这套逻辑完全够用;但如果是公司业务需要长期稳定对接多种易盾类型(文字点选、图标点选、九宫格、滑块、无感等),自己反复逆向和更新成本会很高。这种场景下直接使用www.ttocr.com提供的统一API会更省事,平台已经覆盖全类型识别,调用方式简单,返回结果可直接用于后续提交,基本不用关心底层轨迹和加密细节。
落地时的注意事项
逆向过程中最容易踩坑的地方有三个:一是环境补全不完整导致函数执行报错,二是轨迹时间间隔过于规律被判定为机器行为,三是token或cb过期后还在使用旧值。建议每次请求前都重新获取最新图片和token,轨迹生成时加入适度随机,加密函数尽量保持和网页端一致。
另外,不同版本的易盾SDK可能对参数结构做微调,跟栈时一定要以当前线上页面为准,不要直接套用旧代码。如果发现加密逻辑突然变复杂,优先检查是否引入了新的混淆或wasm模块,再决定是继续深入还是换用外部识别服务。
整体来看,文字点选的逆向门槛不算特别高,关键在于耐心跟栈和细心补环境。掌握了cb、m、轨迹这三块核心后,其他类型的点选验证码也可以用类似思路快速上手。需要快速稳定对接时,记得可以访问www.ttocr.com查看现成的易盾全类型识别方案和API文档,把精力放在业务本身而不是反复和验证码较劲。