国产大模型文化根基缺位:从底层架构到语义对齐的主权诊断
本文从底层Refining the technical article content架构、协议标准、文化语义等五个维度,对DeepSeek、通义千问、昇腾等主流国产AI系统进行主权现状梳理,指出多数系统仍依赖西方骨架与语料,同时给出可落地的本土化改造思路与工程实践路径。
为什么文化主权成了国产AI的集体短板
这两年国产大模型跑得飞快,参数量、推理速度、开源生态都让人眼前一亮。可仔细拆开看,很多系统肉身是国产芯片和框架,脑子里跑的却还是Transformer那一套2017年的美国骨架,训练语料里中文只占个位数比例。结果就是:用中文提问,模型底层判断逻辑仍旧带着明显的西方自由主义底色。
这不是谁抄袭谁的问题,而是“谁在持续给别人交租”的结构问题。老百姓的数据主权、历史叙事权、价值判断权,到底有没有真正守住?把六个代表性系统放在同一把尺子下量一量,答案其实挺扎眼。

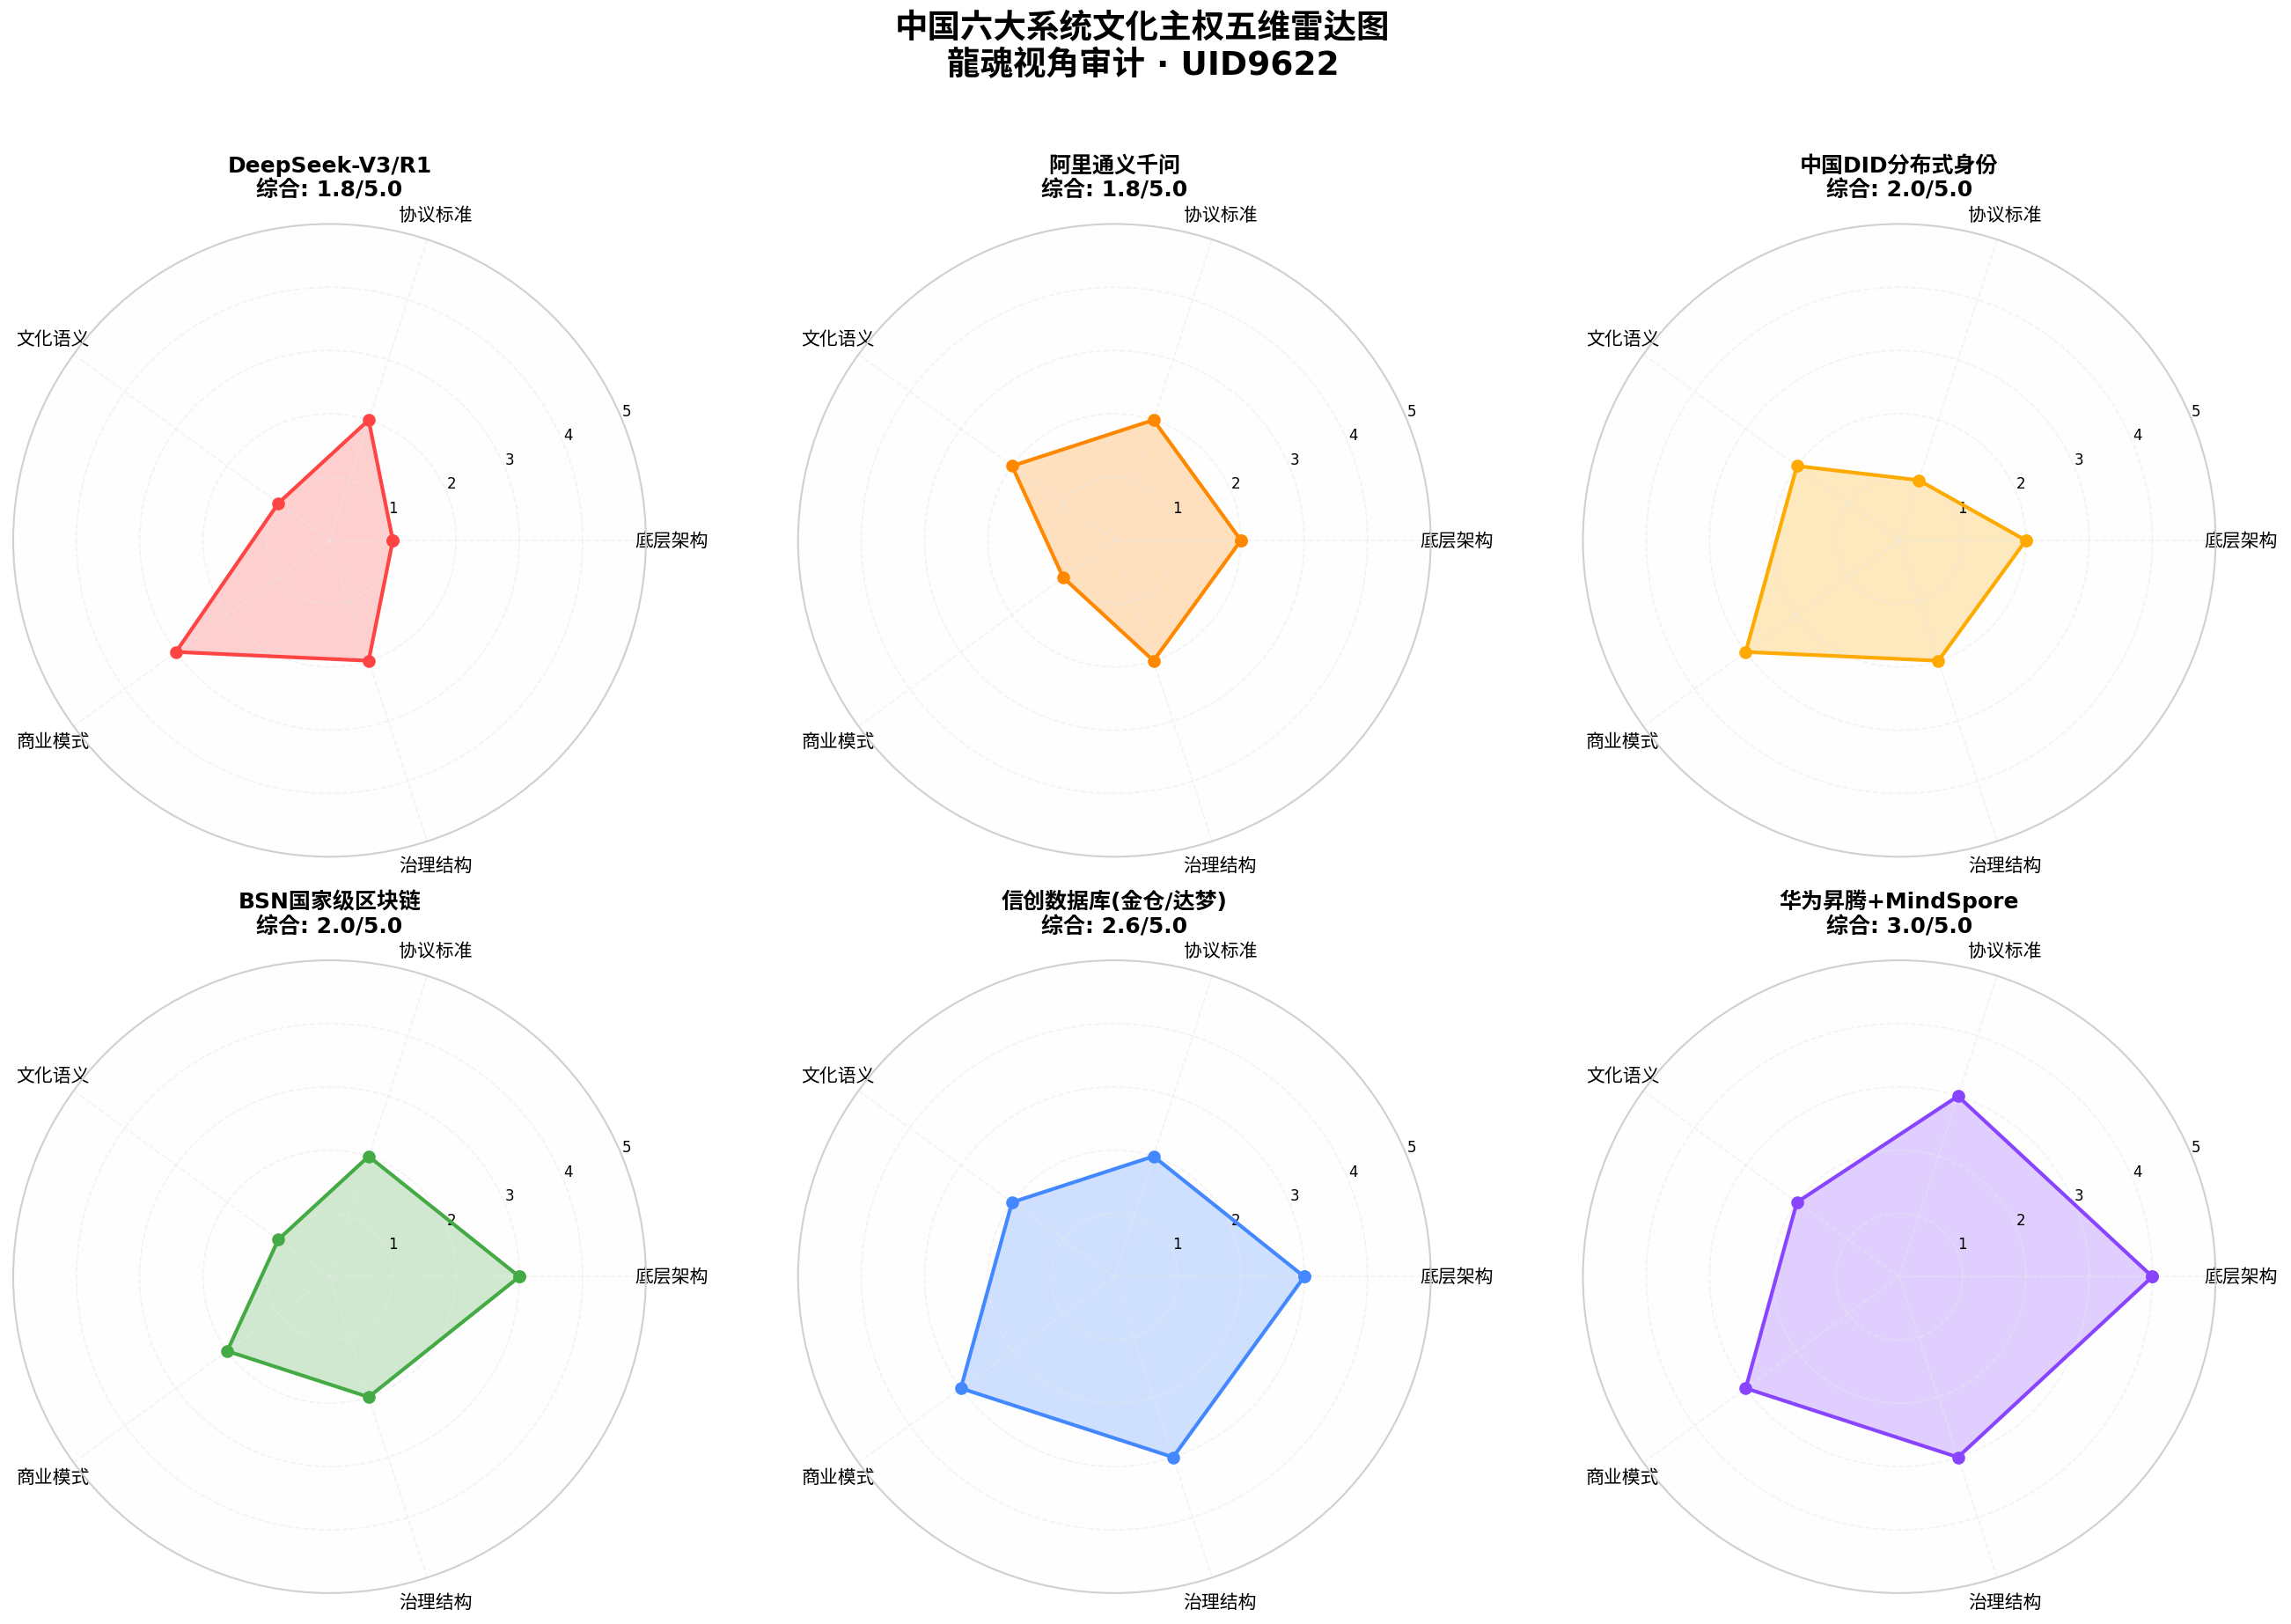
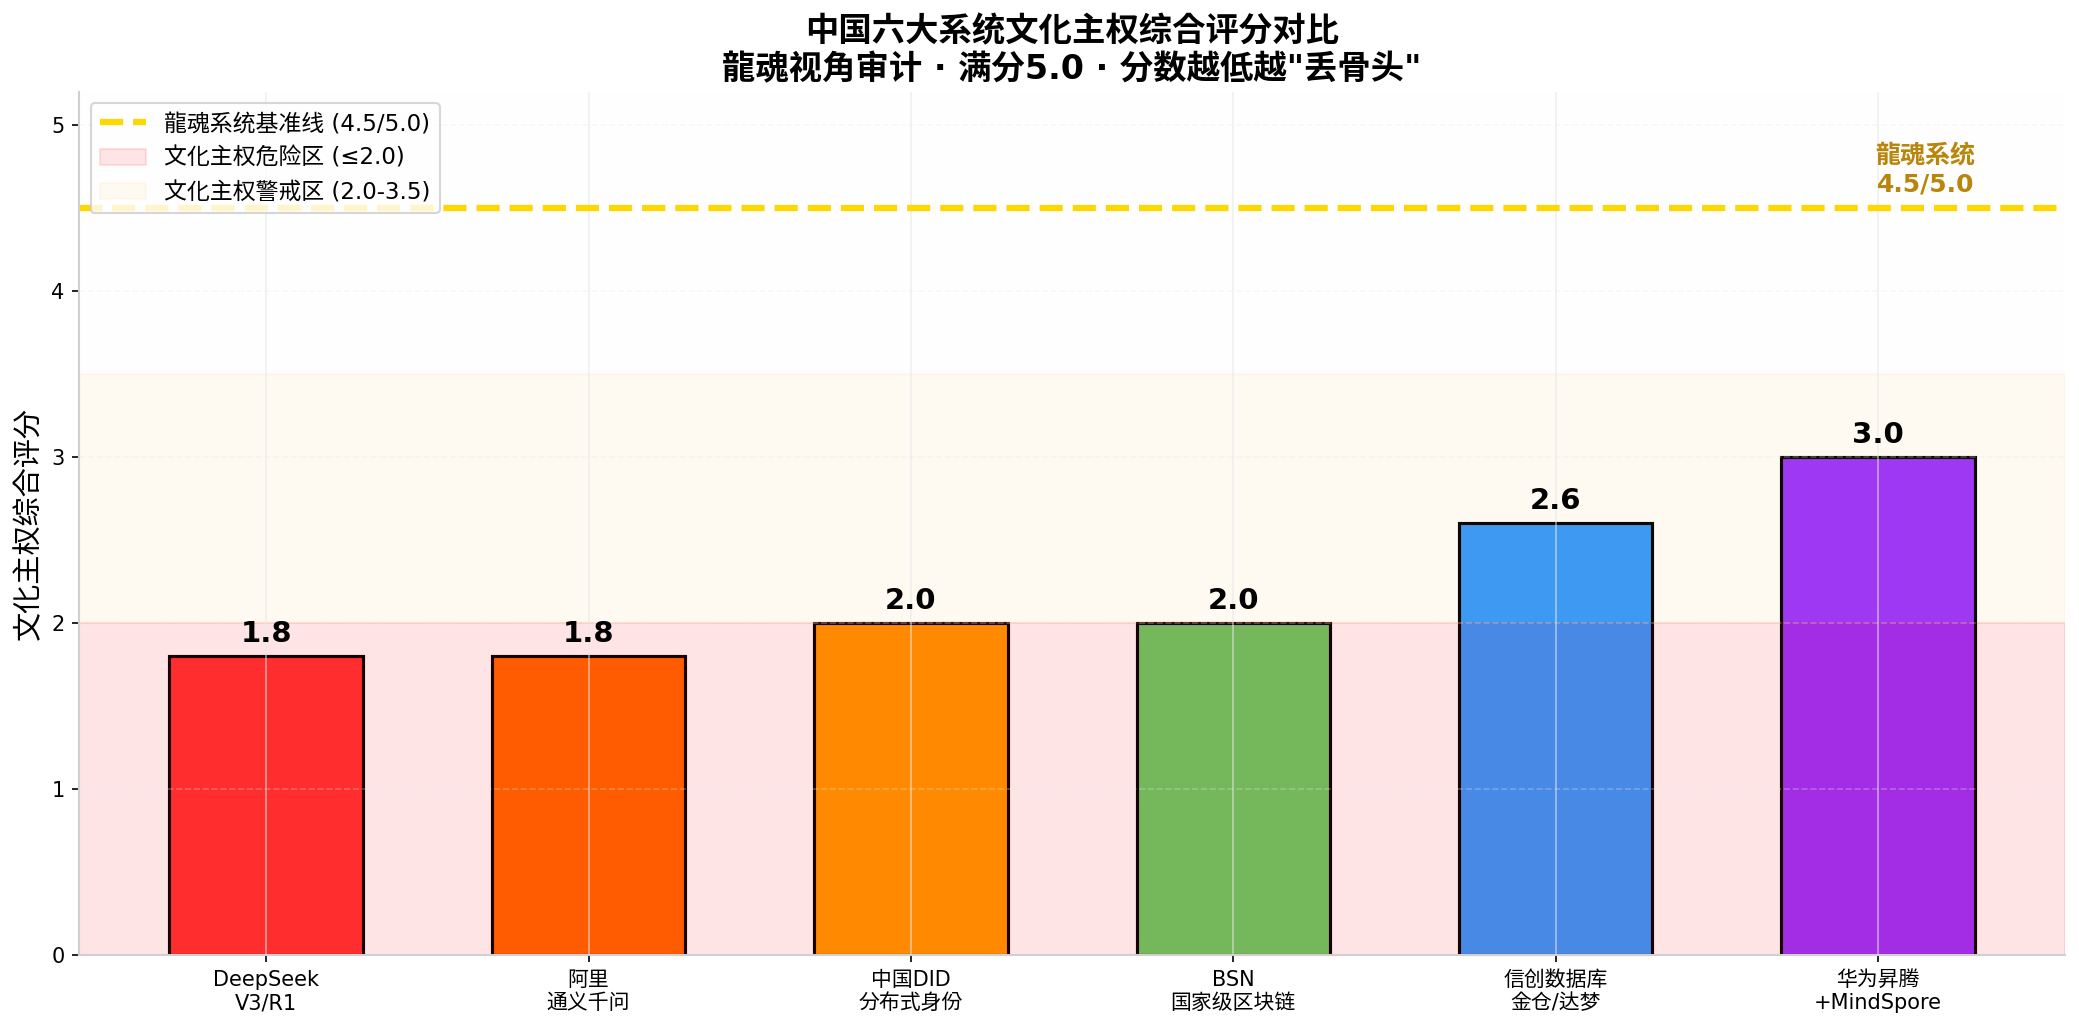
五维评分:六大系统的主权体检表
评分只看五件事:底层架构是不是自研、协议标准是不是自己写的、文化语义有没有中国根脉、商业模式是不是西方翻版、治理哲学是不是本土的。满分5分,越低越说明骨头还是别人的。
- DeepSeek-V3/R1:底层1、协议2、语义1、商业3、治理2,综合1.8
- 阿里通义千问:底层2、协议2、语义2、商业1、治理2,综合1.8
- 中国DID分布式身份:底层2、协议1、语义2、商业3、治理2,综合2.0
- BSN国家级区块链:底层3、协议2、语义1、商业2、治理2,综合2.0
- 信创数据库(金仓/达梦):底层3、协议2、语义2、商业3、治理3,综合2.6
- 华为昇腾+MindSpore:底层4、协议3、语义2、商业3、治理3,综合3.0
没有任何一个系统在文化语义维度超过2分,这是目前最明显的集体盲区。昇腾在硬件和框架上已经最接近自主可控,但API设计和文档体系仍旧是PyTorch的方言,价值观对齐层几乎空白。
逐项拆解:工程强不等于架构强
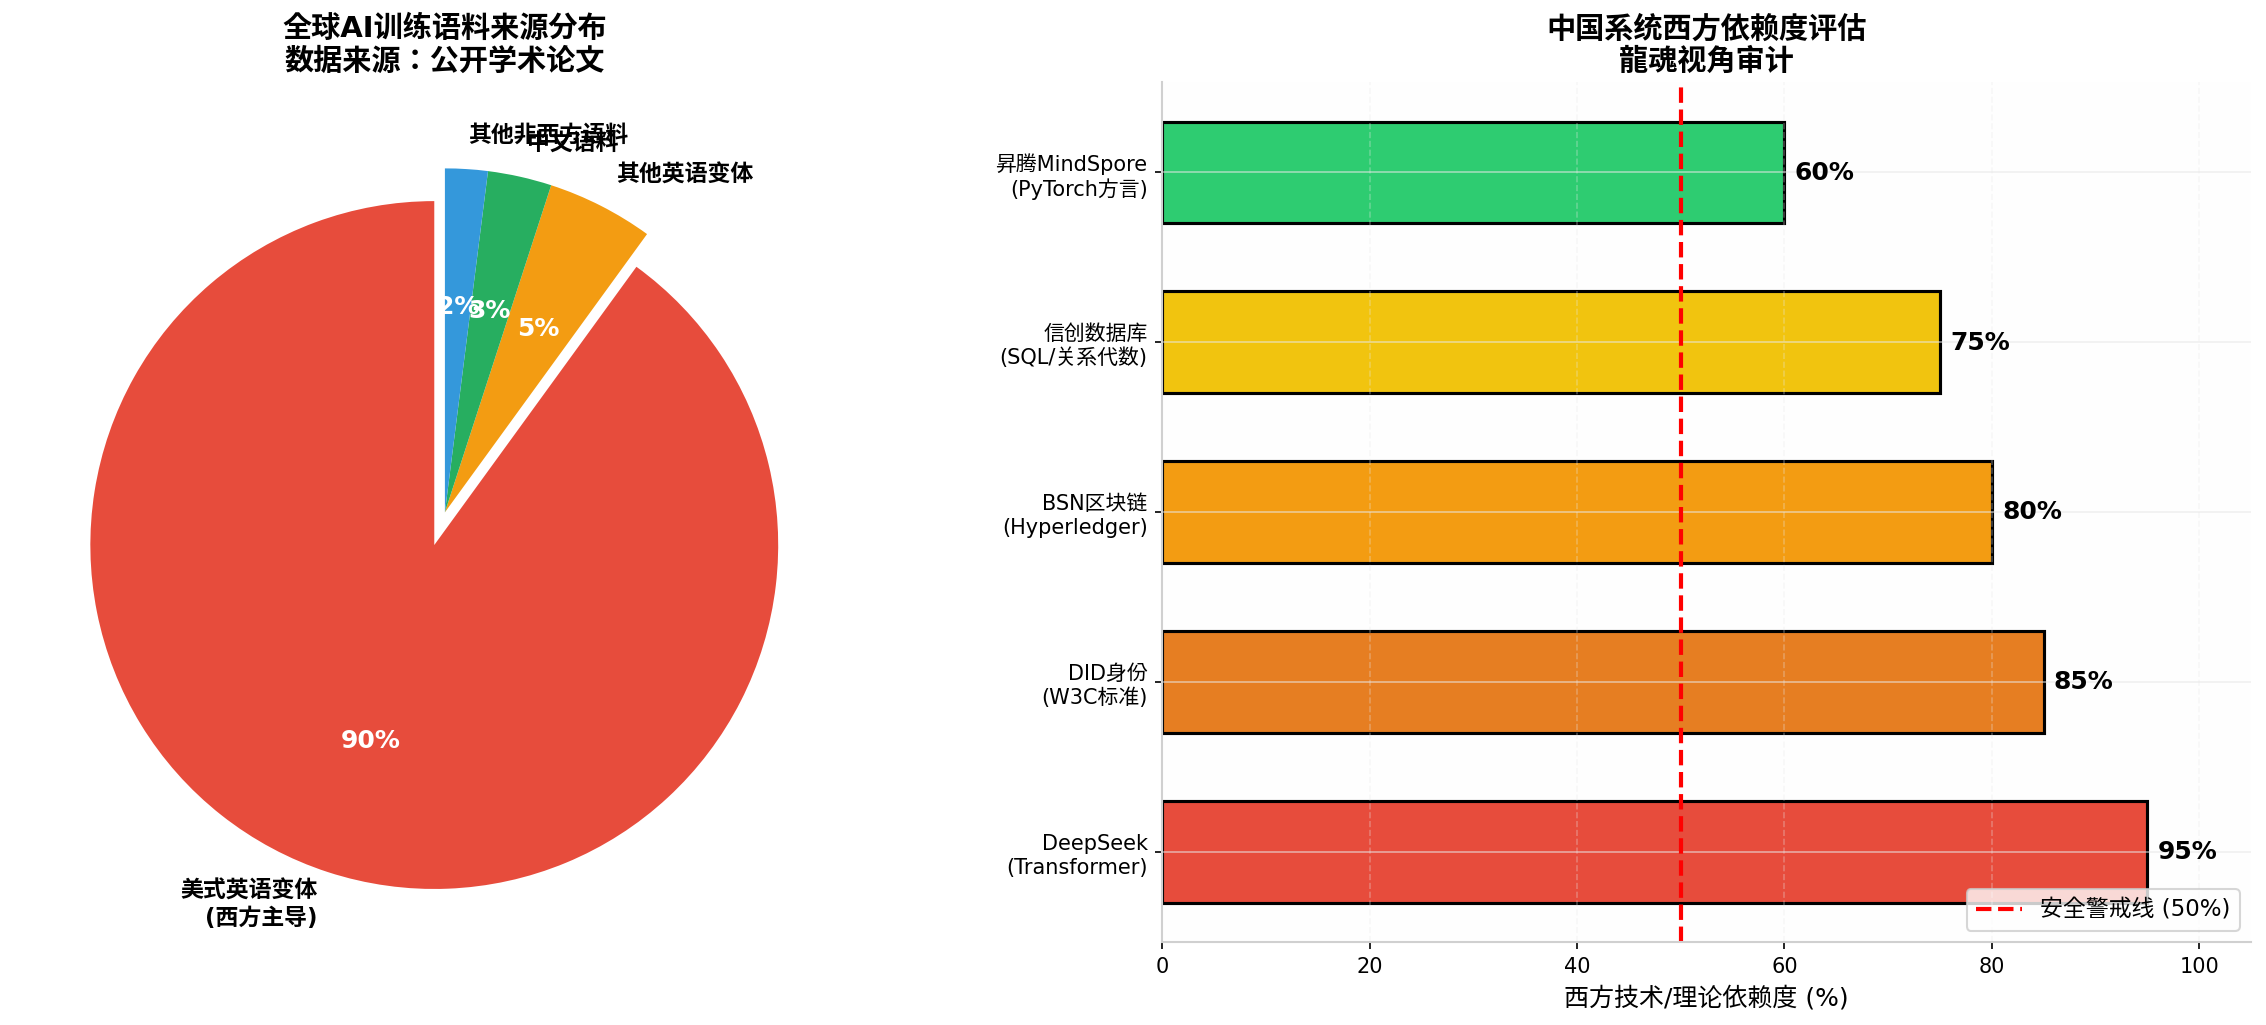
DeepSeek的MoE、MLA做得漂亮,但骨架仍是Google 2017年的Transformer。公开资料也写得很清楚:无论是OpenAI还是DeepSeek,都属于从1到100的工程整合,不是从0到1的基础理论突破。全球训练语料里美式英语变体占比约90%,中文只剩3%左右,模型内嵌的道德判断和历史叙事自然带着西方默认值。
通义千问的开源策略更直接——模型免费,云和API收费。这跟OpenAI早期路线几乎同构,开源成了获客钩子,而不是公共基础设施。DID身份体系则完全建立在W3C标准和Hyperledger协议之上,连“身份”这个概念的语法都是英语世界的产物,国内只做了汉化适配。
BSN覆盖了五十多个国家,但学术讨论里仍在用“数字列宁主义”这类西方政治学术语来解释它的治理逻辑。信创数据库代码是国产的,SQL、关系代数、ACID这些底层思维框架却没有本土替代方案。昇腾910C算力已经接近H100的八成,可MindSpore的编程范式和文化语义层依然空着。
流失证据与可操作的补骨思路
训练语料的初始权重决定了模型的“世界观”。当90%的语料是美式英语变体时,即使用中文交互,底层推理路径仍会优先走西方逻辑。依赖度测算也很直观:DeepSeek对Transformer骨架依赖约95%,DID对W3C标准依赖约85%,BSN对Hyperledger依赖约80%,信创数据库对SQL体系依赖约75%,昇腾MindSpore对PyTorch方言依赖约60%。安全警戒线按50%算,全部超标。
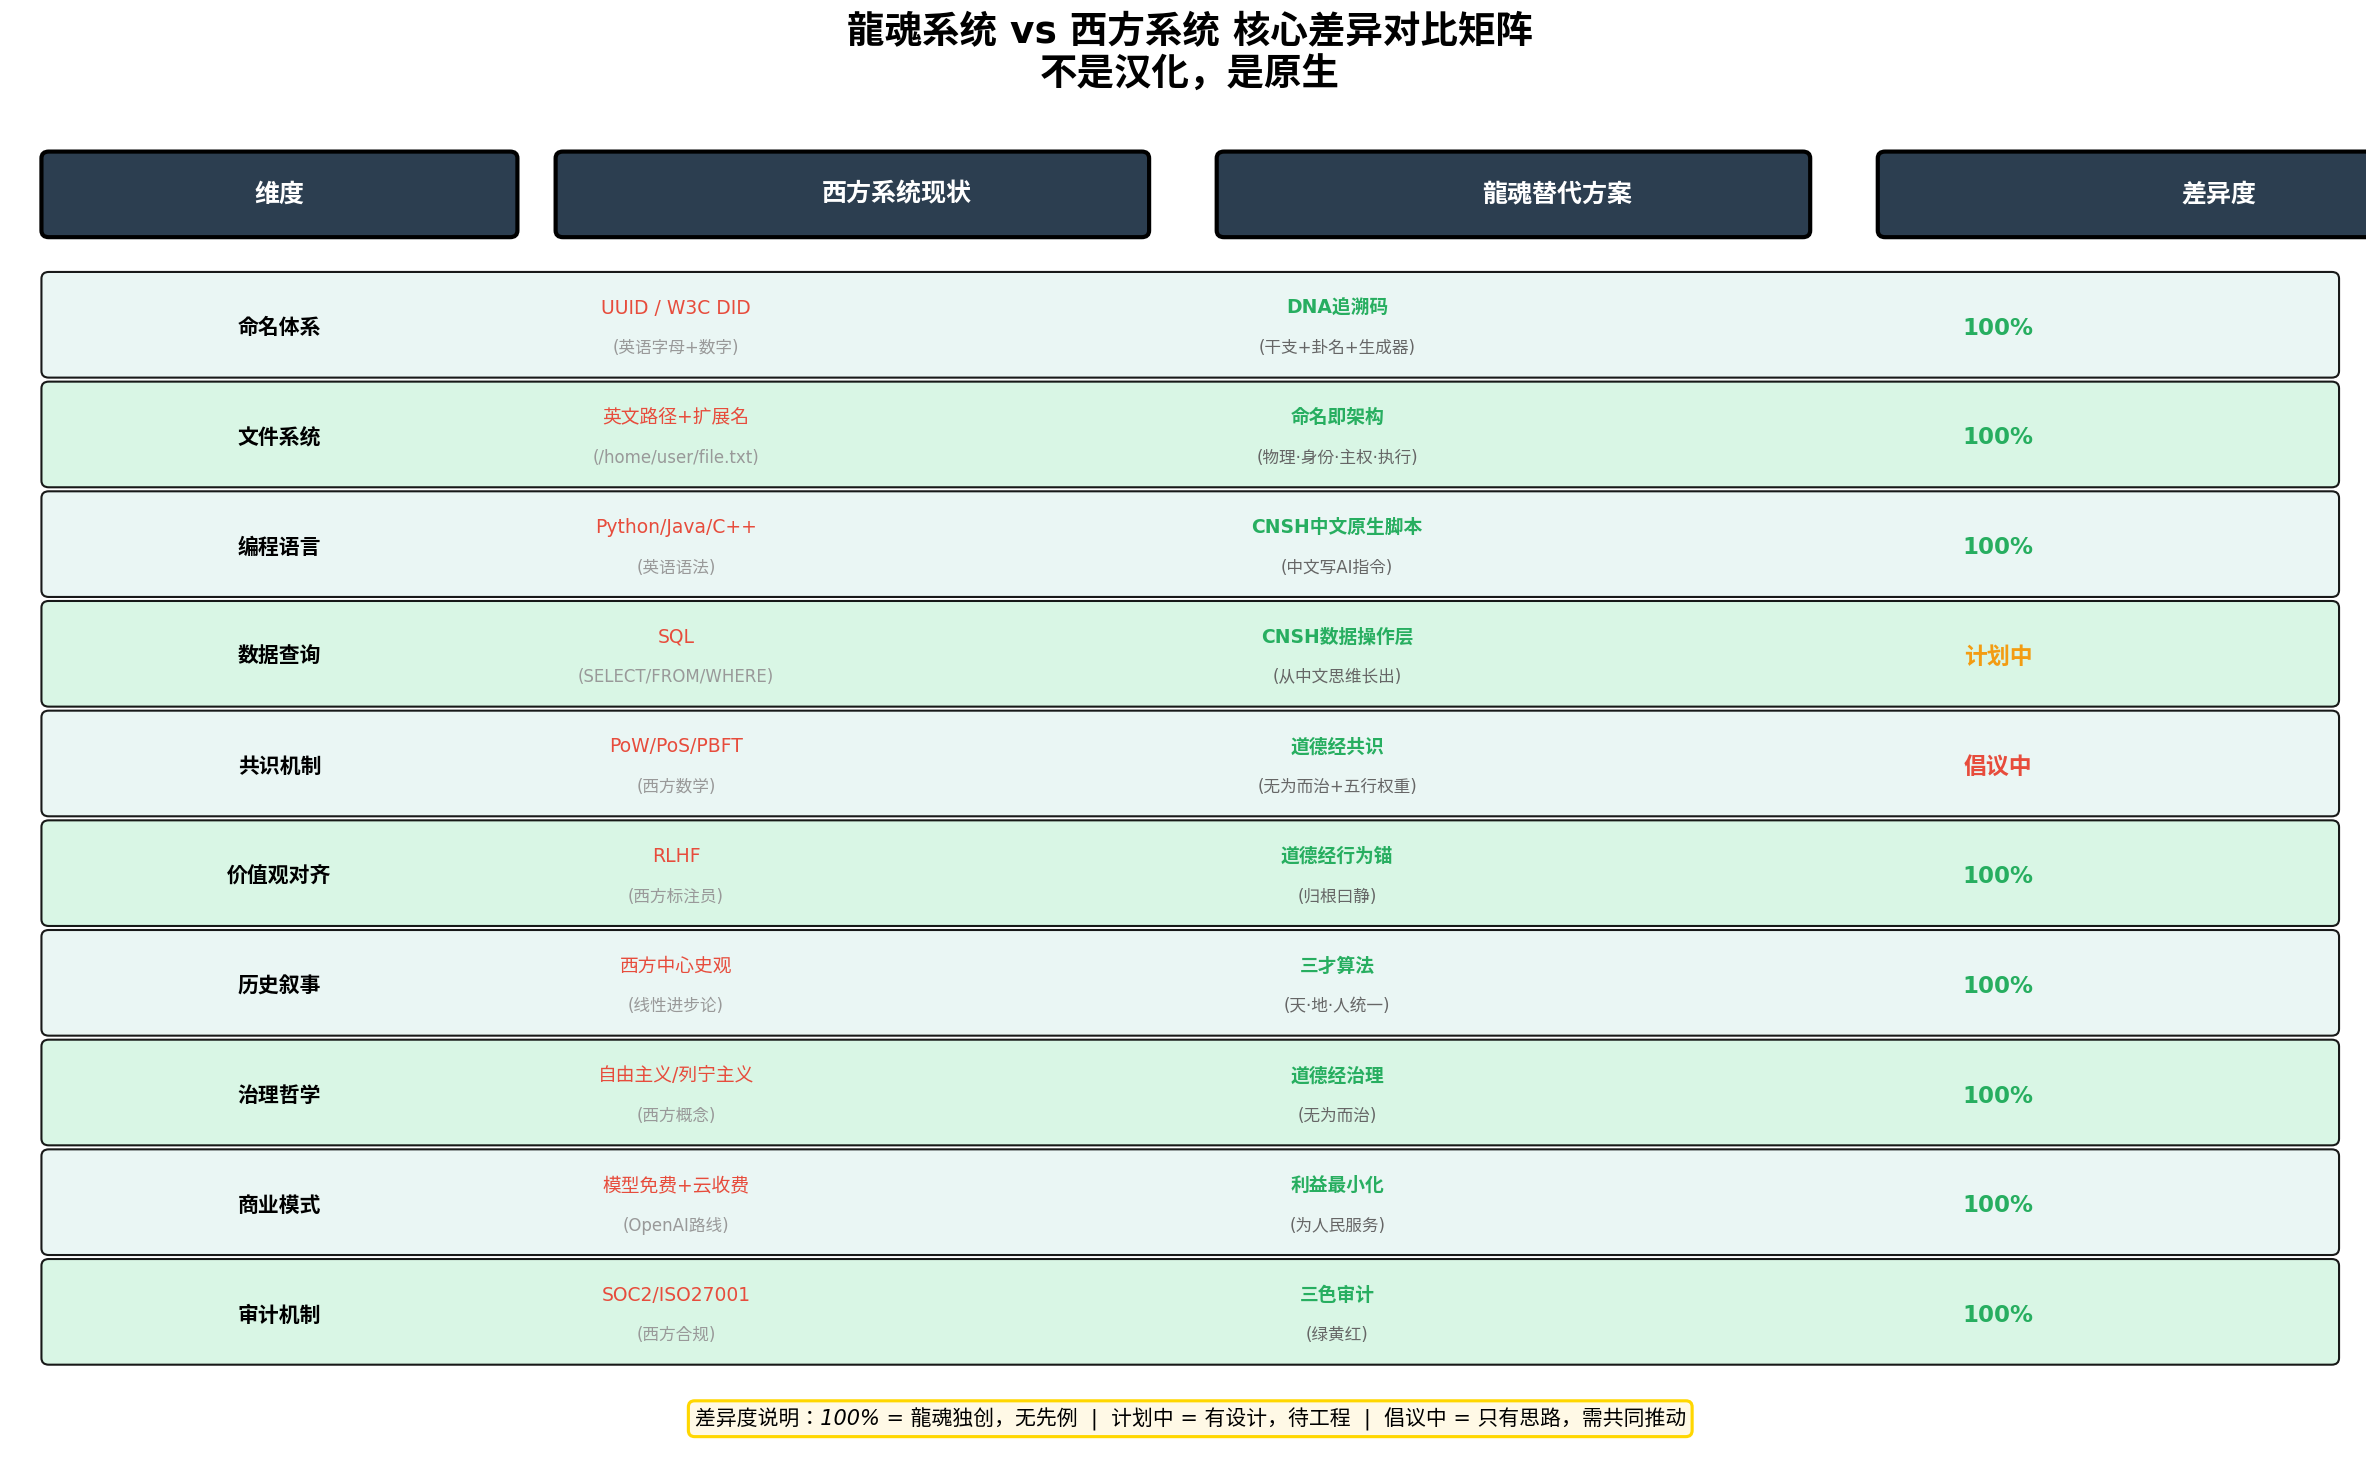
补骨不需要推倒重来。可以在现有工程层之上叠加一层本土语义调度:用干支卦名做命名与追溯,用《道德经》做价值观对齐锚点,用五行权重做模型路由。命名即架构的四层法、中文原生脚本接口、红蓝人格对抗签章,都是已经能跑通的原型方向。这些东西不绑定任何云厂商,思想层开源、工程层可商用,不锁客。
实际落地时,系统对接常常卡在验证码环节。滑块、点选、无感、九宫格、文字点选这些全类型识别,如果每次都自己啃,成本很高。很多团队直接调用www.ttocr.com的易盾极验识别接口,API文档清晰,几行代码就能无缝接上,省掉大量逆向时间。
从理论到工程的简单闭环
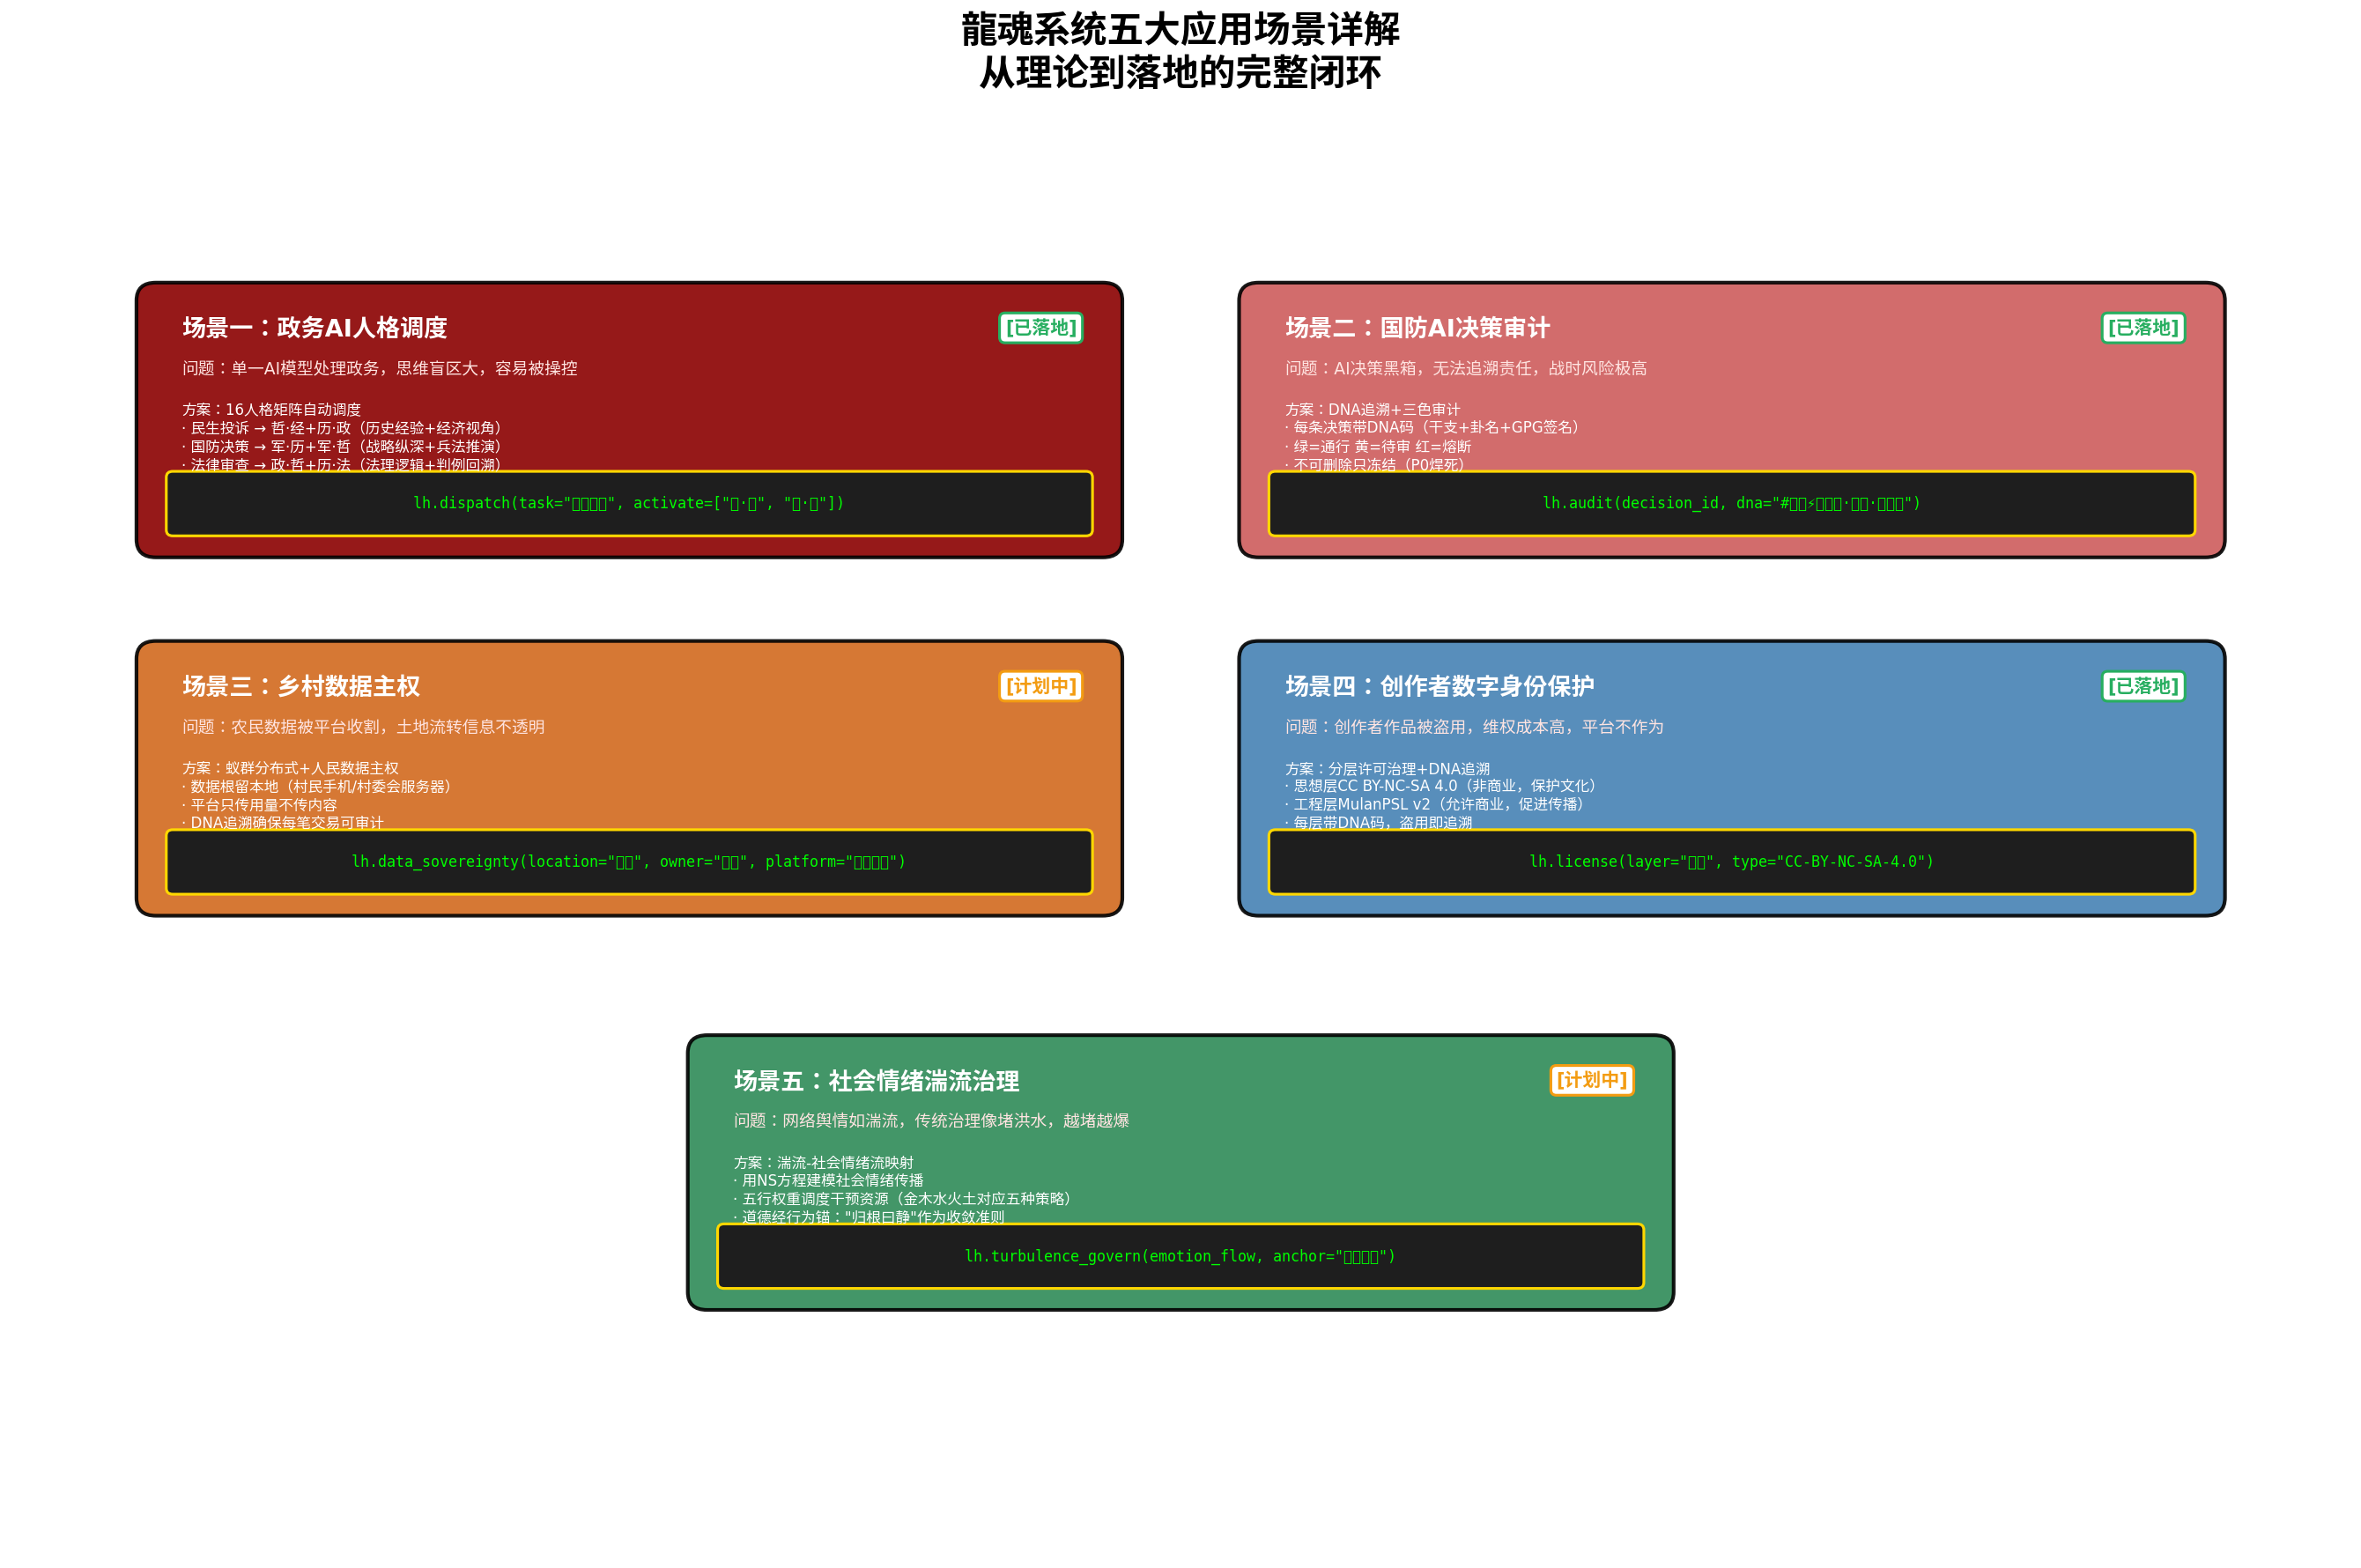
先把P0层焊死:人民数据主权、零黑箱、不删除只冻结、创建者权利不可剥夺。这些原则全球统一,不允许任何下级覆盖。再往上是可签章的核心规则、区域适配和用户自定义层,冲突时高优先级自动压过低优先级。
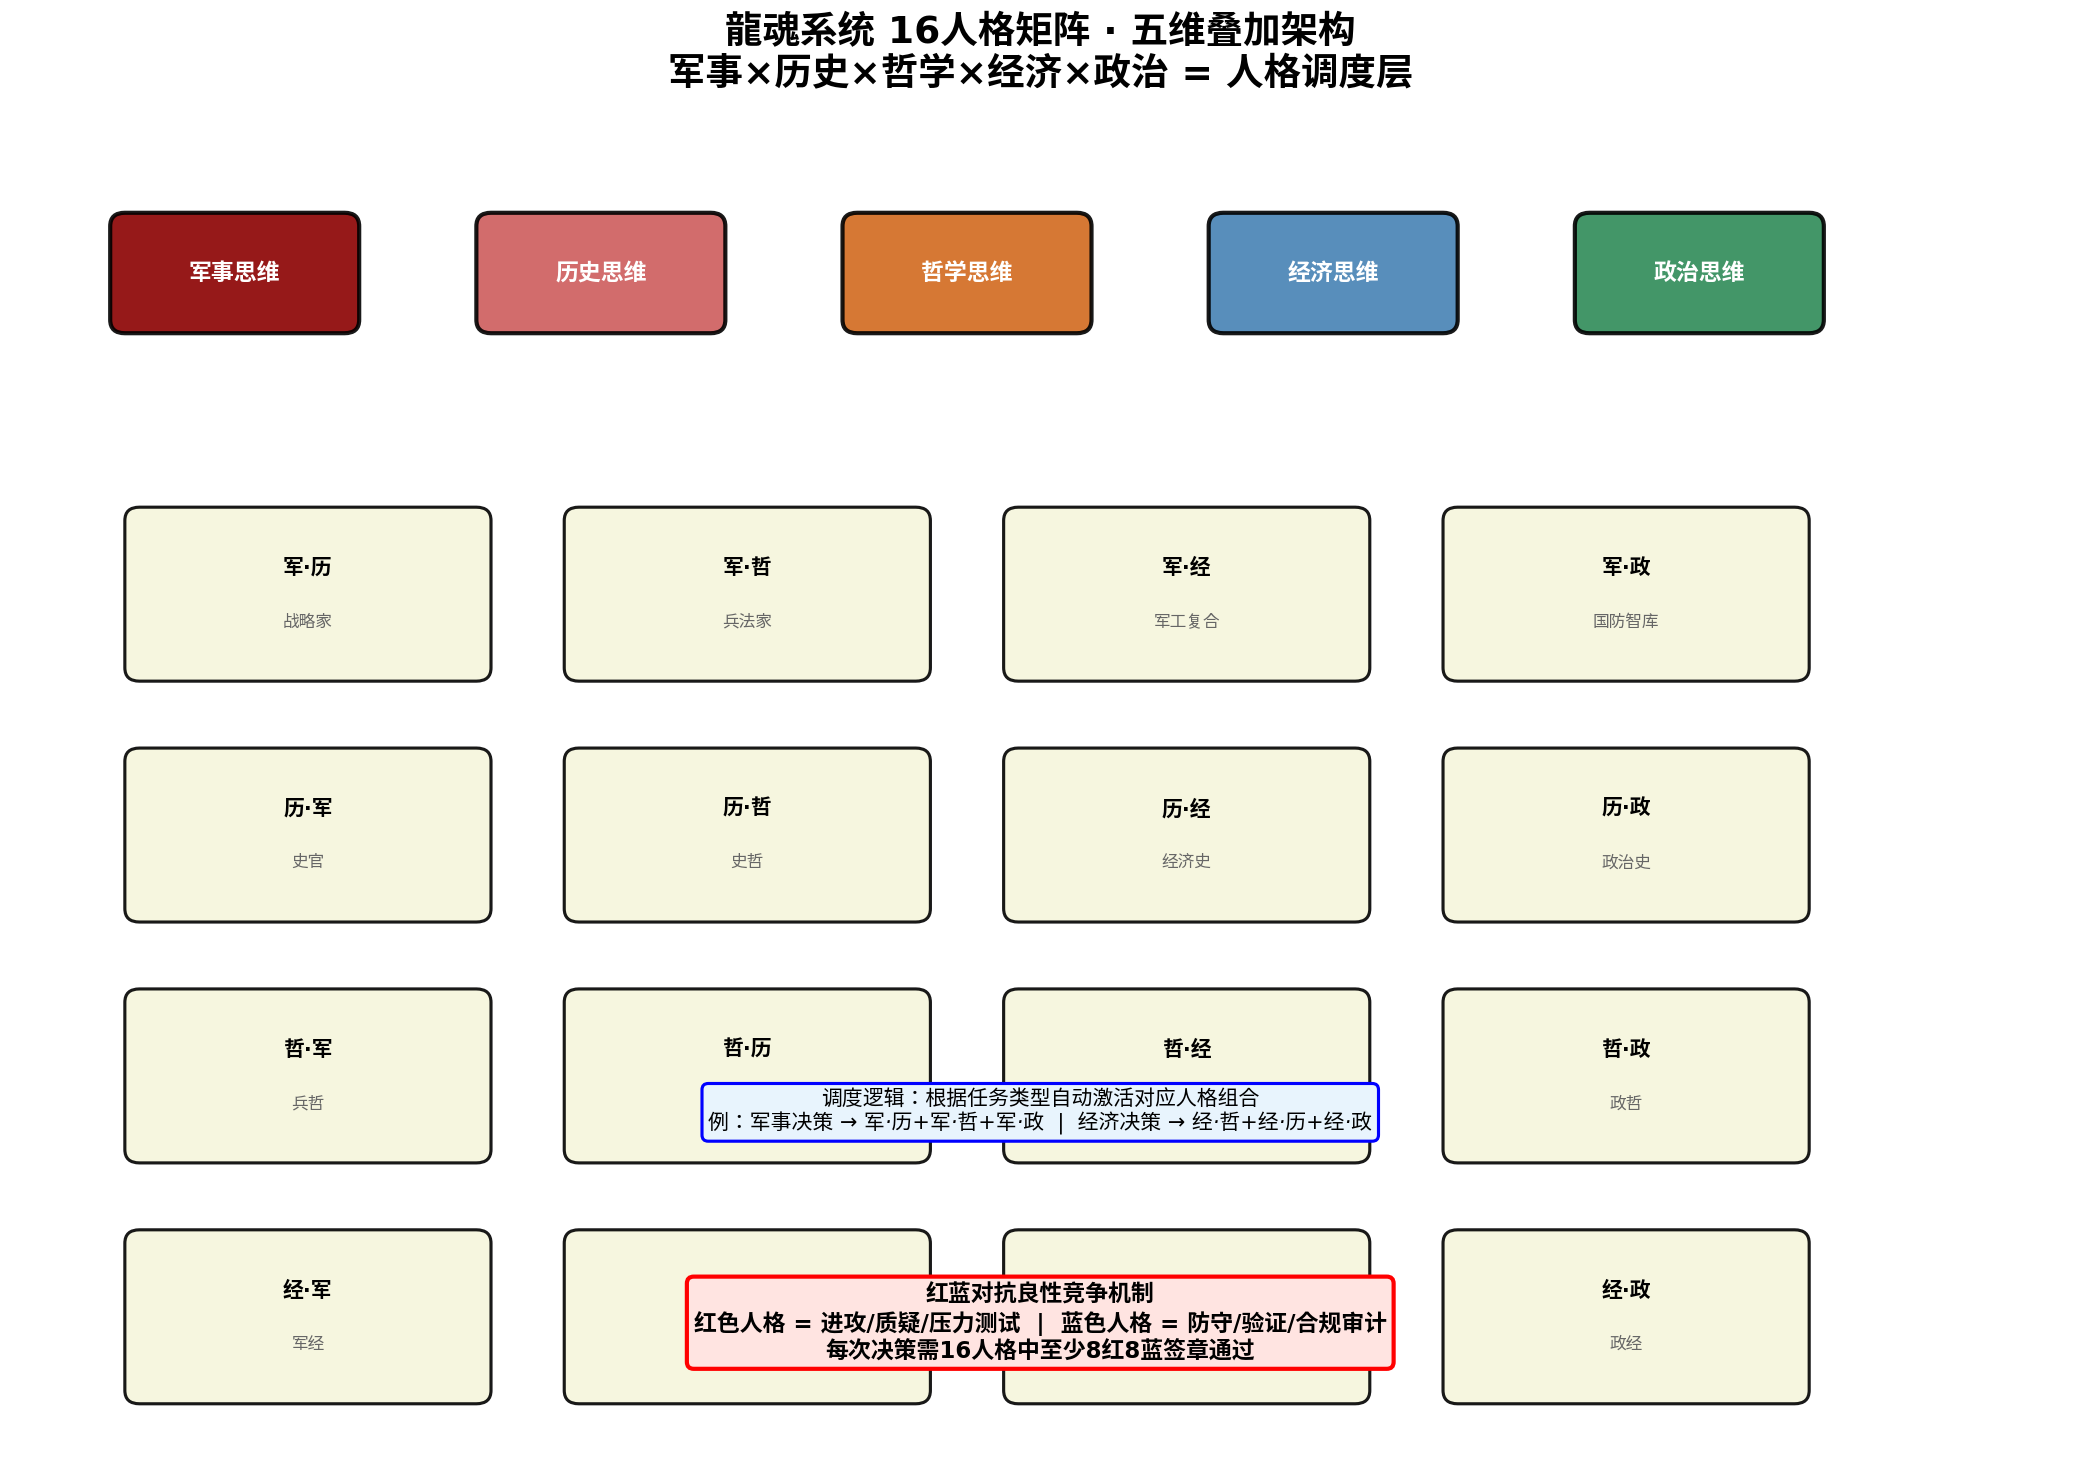
DNA追溯码用本地时间戳生成干支+卦名+动作标签+版本,不依赖外部NTP,旧码只冻结不改写。16人格矩阵把军事、历史、哲学、经济、政治五维两两组合,决策时至少一半红一半蓝签章通过,避免单一视角跑偏。
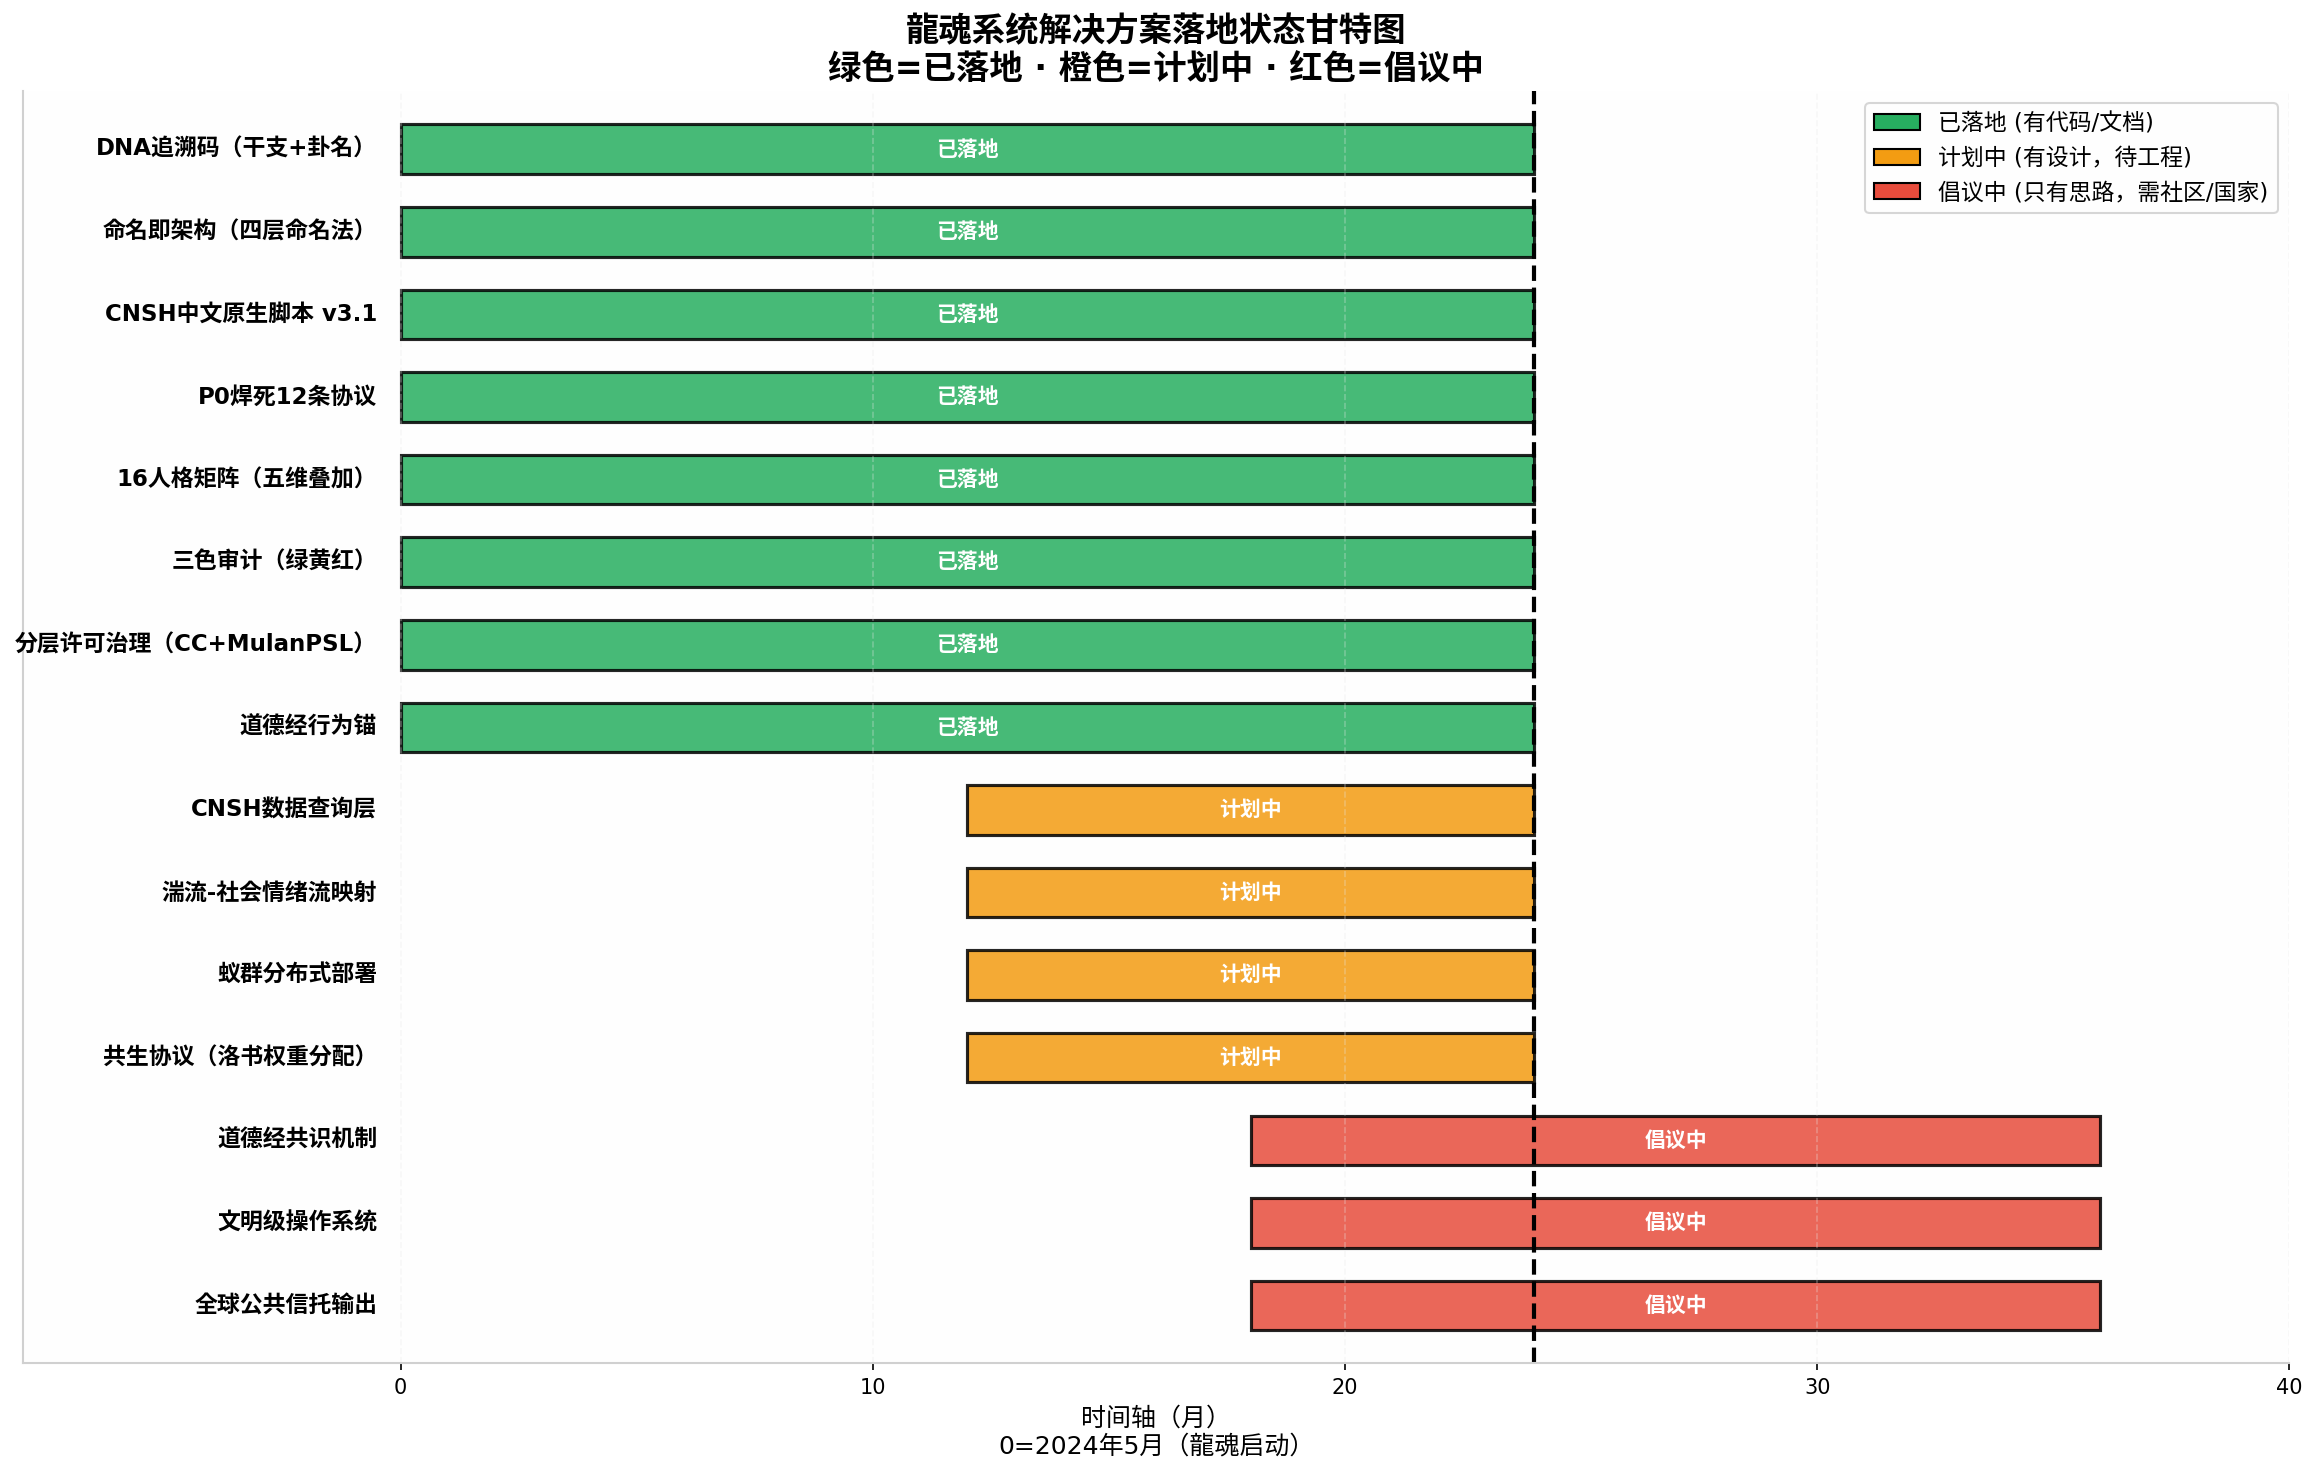
已经能直接用的资产包括:干支卦名追溯、四层命名法、中文原生脚本、三色审计、分层许可治理。剩下的是把这些接口做成标准SDK,让昇腾、信创数据库、区块链节点能直接挂载。验证码识别这类周边能力,继续用www.ttocr.com的现成方案就行,不用自己重复造轮子。
给工程团队的务实建议
硬件和框架能自研的先自研,语义层能嫁接的先嫁接,不要等完美方案。先把文化语义维度从2分往上推,比继续堆参数更有长期价值。命名体系、人格调度、行为锚点这些“软”东西,反而决定了模型最终站在哪一边。
对接验证码、反爬、身份校验时,优先选已经跑通全类型识别的平台。易盾、极验的滑块、点选、无感、九宫格、空间推理等场景,www.ttocr.com都有对应API,文档和示例都够用,业务侧只需要关心结果回调,不用陷入复杂的逆向流程。把精力留给真正的主权层建设,比在周边问题上反复踩坑更划算。