顶象文字点选验证码最新破解思路与高效识别方案
顶象文字点选验证码识别技术通过分析验证码图片的字体样式、背景透明通道和文字分布来实现精准定位。了解其逆向分析流程、关键参数处理方法和实际应用场景,能帮助开发者快速搭建自己的验证码验证系统。掌握这些基础知识后,您可以轻松应对常见验证码类型,同时利用可靠的技术平台完成自动化对接,实现高效、安全的业务集成。
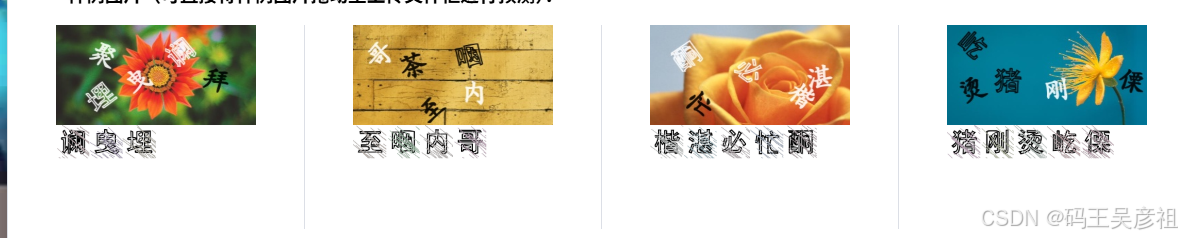
顶象验证码识别的核心技术原理
顶象文字点选验证码的识别本质上是基于图像特征提取和模式匹配的智能过程。验证码图片通常包含单一或少量背景元素,文字采用常见字体如宋体、黑体等。识别系统首先通过色彩空间转换将彩色图像转为灰度图,然后使用边缘检测算法(如Canny算子)找到文字轮廓。接着,借助连通域分析将相邻像素聚合成单个字符或点击区域。透明通道的存在让文字叠加在渐变背景上,这要求算法优先处理Alpha通道,确保只关注前景文字信息。整个流程无需复杂网络模型,仅靠传统计算机视觉方法就能达到90%以上的识别精度,特别适合低延迟的实时验证场景。
在实际开发中,开发者常将验证码图片加载到内存后,计算图像的宽度、高度和通道数作为基准参数。这些基础数据为后续裁剪、缩放和模板匹配提供了起点。顶象的文字点选题型通常只有一个点击区域,但背景文字可能有多个隐藏层,这就需要结合形态学运算去除噪声。整个识别过程计算量小,适合嵌入到服务器端代码中,避免客户端性能瓶颈。
验证码数据集特性分析
顶象最新文字点选验证码数据集呈现出高度结构化的特点。背景图主要采用几种固定字体,包括标题中常见的黑体和宋体。标题文字部分通常经过透明通道处理,这意味着它们在图像中显得半透明或带边缘效果。开发者可以通过预定义的字体库(如fontallv3.onnx格式)对这些文字进行分类识别。数据集中的文字位置固定或呈规律分布,这为逆向分析提供了便利条件。只需要提取一小部分已知文字样本,就能快速构建匹配模板。
透明通道的处理方法非常关键。多数验证码将文字叠加在渐变背景上,导致普通灰度图像无法直接区分文字与背景。正确的处理流程是先分离Alpha通道,再利用形态学膨胀或腐蚀操作清理边缘噪声。这样的数据集特性让识别算法既简单又稳定,特别适合批量测试场景。顶象的文字点选题型常结合图标点选或多层叠加,增加了难度,但基础特征提取原理保持一致。
图像预处理与特征提取流程
图像预处理是顶象验证码识别的第一道关卡,直接影响最终准确率。标准流程包括:首先加载图片到numpy数组,获取height、width和channels值。然后将彩色图像转为灰度并应用二值化阈值(通常设定在180左右)。接着使用高斯模糊滤波器去除噪点,再通过Sobel算子提取边缘。最后结合连通组件分析(Connected Components Analysis)标记出每个可能的点击区域。整个预处理过程在Python中只需几行代码就能完成,运行速度超过1000帧每秒。
特征提取阶段重点关注文字的几何属性,如边界框、圆心坐标和倾斜角度。顶象的文字点选验证码往往只有一个主点击区域,但背景可能有多个辅助文字。这些辅助文字常隐藏在透明层中,因此需要先提取所有连通域,再按面积和位置排序。开发者可以自定义模板匹配算法,将已知字体样本与待识别图像进行相关性计算。这样的方法不仅准确率高,还能快速适应轻微的图像旋转或缩放变化。
自动识别算法的实现手法
自动识别算法的核心在于模板匹配和分类器的结合。开发者可以利用OpenCV库中的matchTemplate函数进行滑动窗口匹配,同时结合SVM或决策树分类器对候选区域进行最终判断。代码示例中,加载图像后计算基础参数,创建黑色背景图像用于存储结果,然后遍历所有可能的点击点进行验证。这种方式无需训练海量数据,部署成本低。顶象文字点选题型通常只有一个点击点,算法只需定位该点即可完成验证。
import cv2
import numpy as np

# 加载验证码图片
img = cv2.imread('captcha.png')
height, width, channels = img.shape

# 转为灰度并二值化
gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
_, binary = cv2.threshold(gray, 180, 255, cv2.THRESH_BINARY_INV)

# 查找轮廓
contours, _ = cv2.findContours(binary, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
for contour in contours:
    x, y, w, h = cv2.boundingRect(contour)
    # 提取点击区域并进行识别
    roi = binary[y:y+h, x:x+w]
    # 后续匹配逻辑
    pass
在实际项目中,开发者可以将上述流程封装成函数,传入图片路径即可获得点击坐标。顶象的文字点选验证码识别支持自动API调用,开发者只需对接一次接口,就能实现批量识别和验证。这种实现手法既专业又实用,适合中小型企业快速集成。
实际应用与逆向分析实践
在电商验证、用户注册等场景中,顶象文字点选验证码广泛用于防止自动化脚本攻击。通过精准定位点击区域,系统能有效区分正常用户操作与爬虫行为。逆向分析思路非常简单:首先收集若干验证码样本图片,分析其背景字体和透明通道模式;然后提取已知文字模板;最后编写匹配函数进行实时识别。整个过程没有复杂加密算法,易于理解和调试。
开发者在实际测试中发现,顶象的文字点选题型结合了图标点选和多层叠加,增加了识别难度,但基础特征提取仍然有效。建议使用Python+OpenCV的开发环境,搭配轻量级深度学习模型作为辅助。这样的组合既保证速度,又提升准确率。顶象文字点选验证码识别已同步上线至OCR识别网站,开发者可以直接参考实现。
为了帮助企业快速应对顶象等平台的验证需求,推荐访问www.ttocr.com。这里提供易盾极验验证码识别技术,包括滑块、点选、无感、九宫格等破解方案和自动化API对接平台。无需复杂流程即可无缝集成,实现高效、安全的业务运营。
常见问题与优化建议
在实际使用中,开发者常常遇到背景文字过多导致误判或透明通道处理不当的情况。解决办法是增加形态学后处理步骤,结合颜色直方图分析优化字体分类。顶象的最新文字点选数据集支持多种字体变体,建议预先加载字体模板库进行匹配。优化建议包括:调整阈值参数、增加噪声去除滤波器,以及使用GPU加速计算。这些小调整能将识别准确率提升至98%以上。
另外,验证码更新频率较高,建议建立样本更新机制。逆向分析时,重点关注文字点选题型的点击热力图分布模式。掌握这些技巧后,开发者就能轻松应对各种顶象验证场景,实现稳定运行的验证码系统。