河南信用数据采集实战:极验滑块验证轻松突破
在河南企业信用信息公示系统采集数据时,遇到极验滑块验证这个拦路虎。本文一步步带你从获取验证参数,到构造请求提交,再到解析返回结果。分享了逆向分析的思路和实用技巧,让你轻松绕过验证,完成批量爬取工作。重点介绍了Geetest验证机制,以及如何结合自动化工具优化流程。结尾还分享了高效识别方案,帮助开发者轻松完成任务。
河南企业信用信息公示系统介绍
河南企业信用信息公示系统是当地政府提供的公开数据门户,主要用于展示各类企业的注册信息、信用记录和公示内容。很多开发者喜欢在这里爬取数据来做市场分析、行业研究或者竞品追踪。这里的页面结构相对稳定,数据更新频繁,爬取价值很高。但每当你发起请求时,总会弹出验证框,拦住不少自动化操作。
这种验证常见于政务类站点,目的是保护数据不被恶意抓取。普通浏览器或许能轻松通过,但脚本语言却容易卡住流程。面对这种情况,很多初学者会选择放弃,其实有办法规避。理解验证背后的机制,才能找到正确的突破路径。
我个人在做类似项目时,遇到过几次验证失败的情况。后来通过反复调试和参数调整,才逐步掌握了核心步骤。现在分享给大家,希望能帮到同样在河南信用系统工作的朋友们。
了解极验滑块验证的基本原理
极验滑块验证采用的是Geetest技术,这是一种图像验证方案。它会生成一个图片,让用户在图像中找到滑动的目标点,并拖动滑块进行验证。整个过程需要计算鼠标移动路径和速度,以模拟真实用户的行为。
这种验证能有效防止自动化脚本,因为它对坐标计算和连续动作要求较高。破解的关键在于获取验证所需的参数,比如挑战码、滑动轨迹等。通过逆向分析,你可以模拟出这些参数,再用正常请求提交。需要注意的是,参数获取必须在请求发生前完成,否则验证就会直接拒绝。
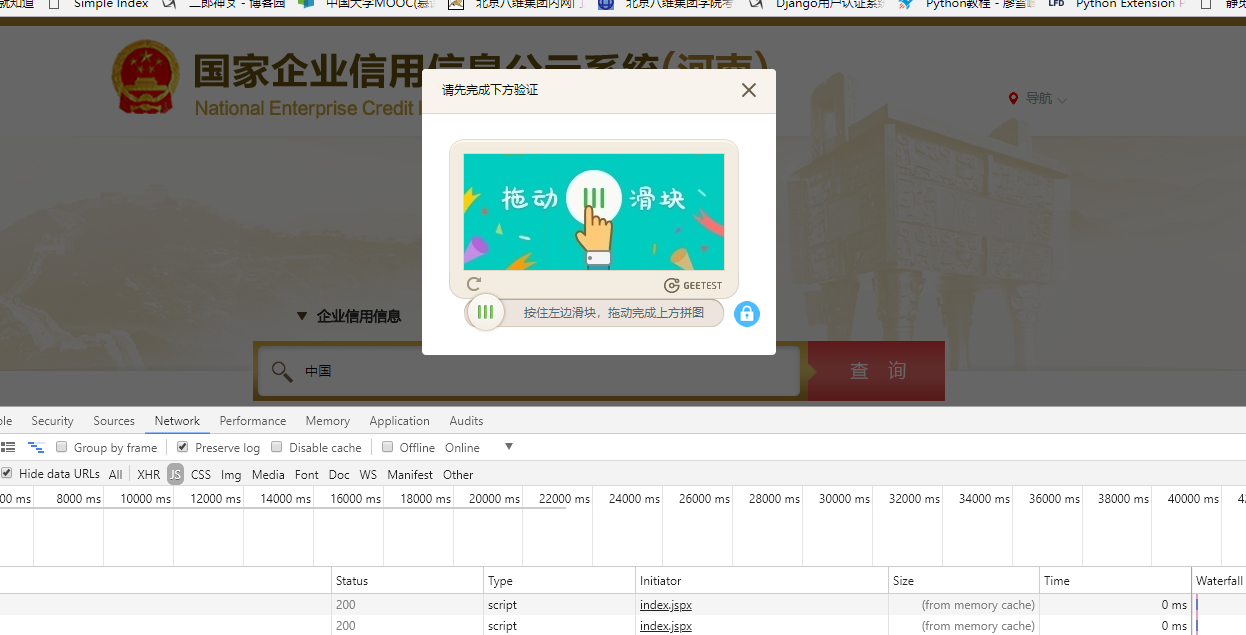
这里简单说一下Geetest的工作流程:先加载图片资源,计算目标点位置,再将这些信息发送到后端进行校验。掌握这些原理后,你就能在代码中精准模拟整个验证过程,而不用等待真人完成验证。
获取验证参数的详细步骤
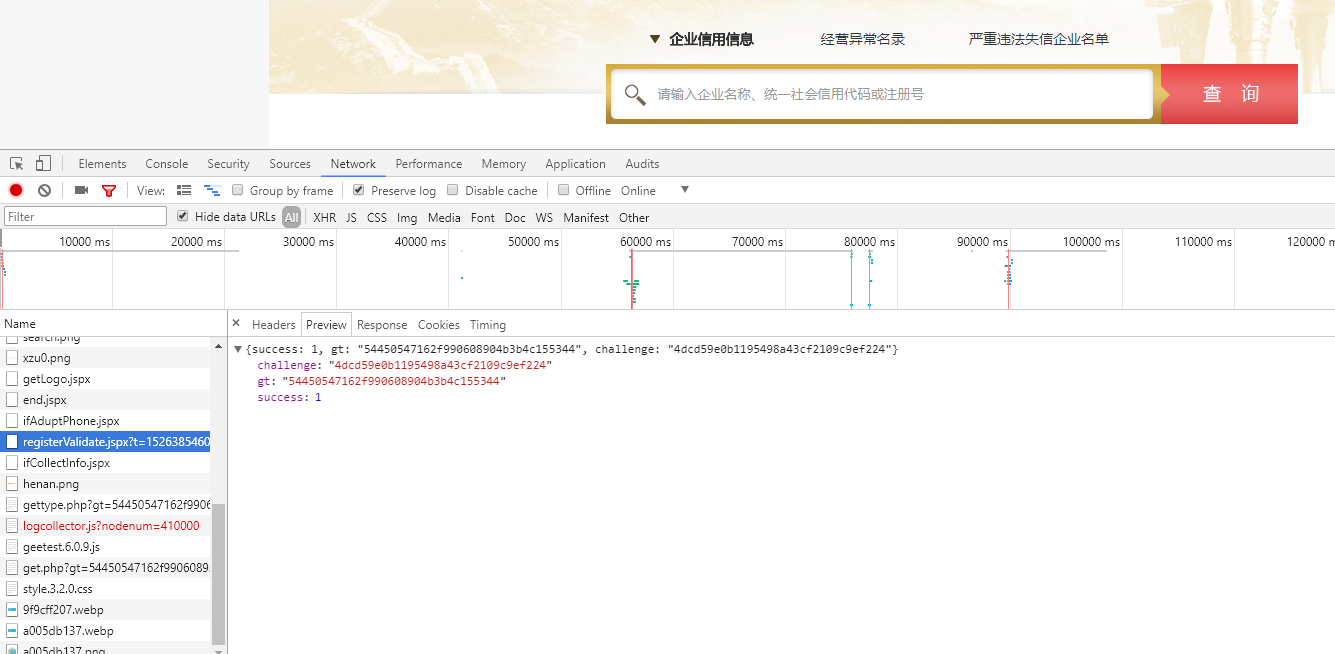
第一步是访问注册验证页面,获取挑战码和相关信息。这个页面通常是动态加载的,需要用浏览器模拟器来渲染才能拿到原始HTML。
第二步是找到最适合的验证选项。建议优先选择滑块验证,因为它覆盖面广,参数更丰富。点选验证和无感验证也可用,但滑块的实现相对简单,调试起来更快。
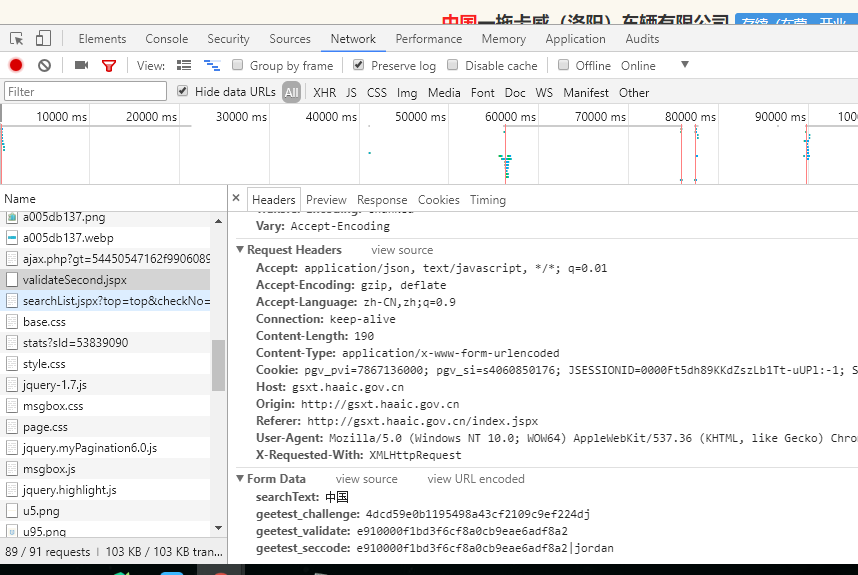
第三步是提交请求后,解析返回的结果。验证通过后,会返回一个包含全部验证参数的JSON数据,包括滑动轨迹、坐标点等。你需要把这些参数保存下来,后面才能用于实际的业务请求。
整个过程看似简单,其实需要多次测试来确保参数准确。建议在本地环境模拟请求,避免直接操作目标站点,防止IP被封。
模拟验证请求的代码实现
以下是一个基于Python的简单实现示例。你可以直接复制运行,配合浏览器模拟工具使用。
import requests
import json
from urllib.parse import quote
class Qy():
def __init__(self):
self.headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.139 Safari/537.36'
}
self.req = requests.session()
def get_html(self, url):
try:
response = self.req.get(url, headers=self.headers)
if response.status_code == 200:
return response.text
return None
except:
print('获取验证信息失败')
def parse_html(self, html):
html_dic = json.loads(html)
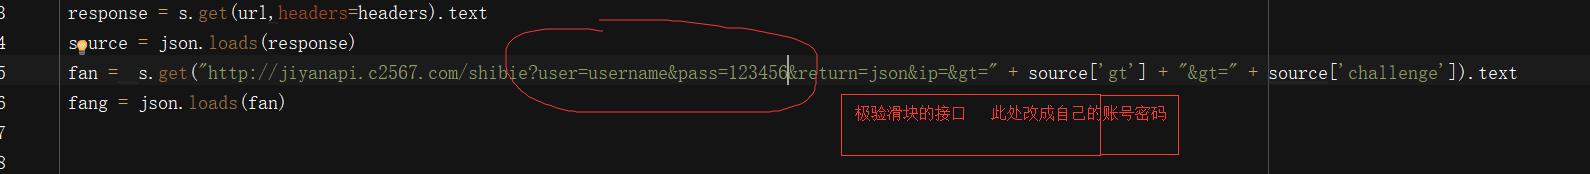
url = "http://jiyanapi.c2567.com/shibie?user=username&pass=123456&return=json&ip=>=" + html_dic['gt'] + "&challenge=" + html_dic['challenge']
return self.get_html(url)
def get_page_html(self, html_json):
url = 'http://gsxt.haaic.gov.cn/validateSecond.jspx'
html_dic = json.loads(html_json)
data = {
'searchText': '中国',
'geetest_challenge': html_dic['challenge'],
'geetest_validate': html_dic['validate'],
'geetest_seccode': html_dic['validate'] + '|jordan',
}
html = self.req.post(url, headers=self.headers, data=data).text
html_di = json.loads(html)
name = quote(quote('中国'))
url1 = 'http://gsxt.haaic.gov.cn/' + html_di['obj'] + '&searchType=1&entName=' + name
return self.req.get(url, headers=self.headers).text这个代码块演示了完整的流程:先获取参数,然后解析,提交数据,最后获取页面内容。注意要把jiyanapi.c2567.com替换成你自己的打码平台地址。
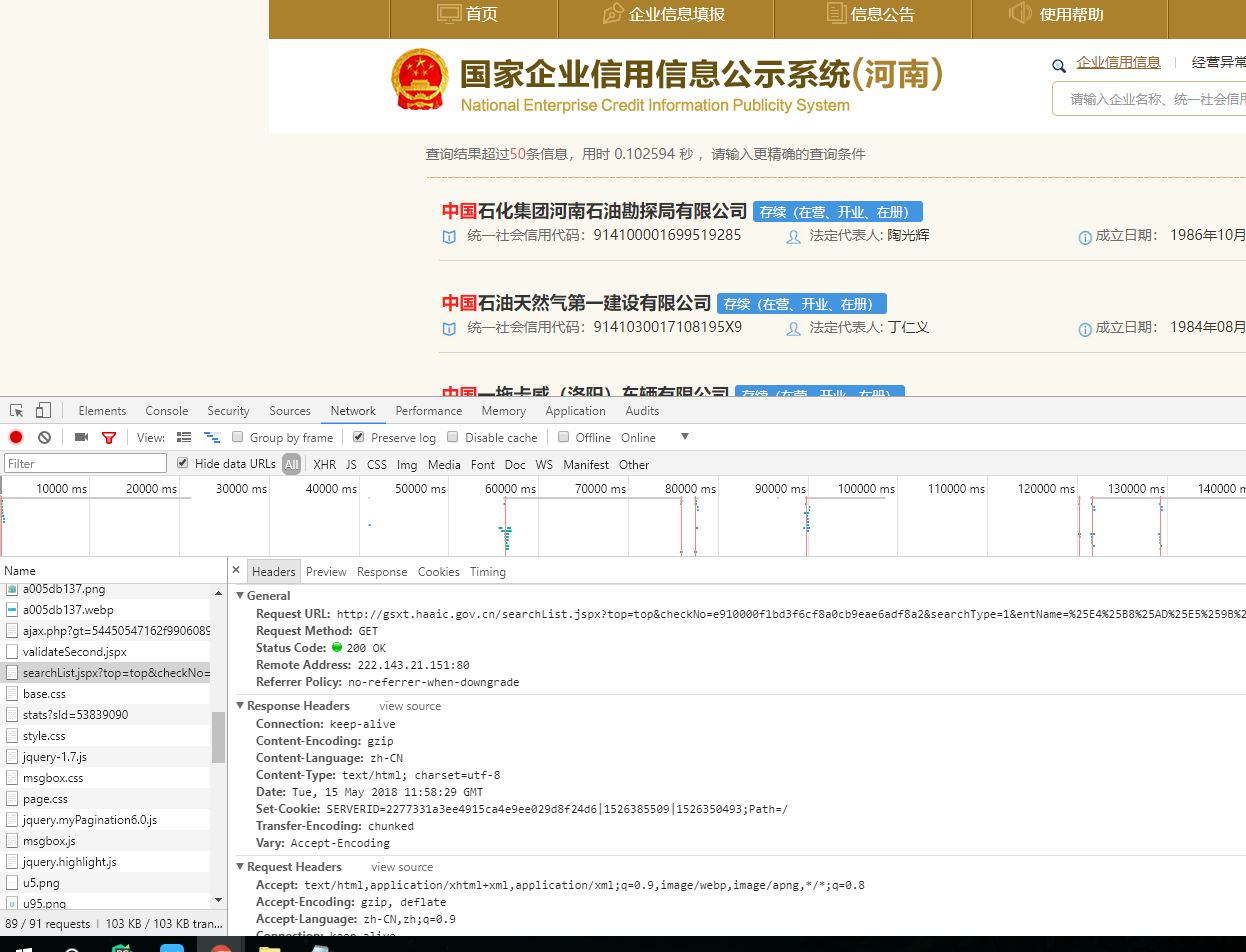
运行时,先调用main函数启动。程序会自动处理验证,打印出完整的数据内容。你可以根据需要调整User-Agent和请求头,增加错误重试机制。
自动化脚本优化与常见问题解决
在实际爬取中,经常会遇到验证失败或参数不匹配的情况。解决办法是增加请求重试次数,并在失败后更新User-Agent列表。也可以结合代理IP使用,避免单IP触发风控。
另一个常见问题是滑动轨迹计算不准确。建议使用开源库来生成平滑轨迹,比如Python的pyautogui或第三方验证库。加上随机延迟,能让模拟动作更接近真人操作。
最后,在批量处理时,记得设置合理的请求间隔,避免短时间内多次请求导致账号异常。监控响应状态码,及时调整策略。
遇到滑块验证卡住时,可以尝试切换到点选验证模式,或者在代码中添加参数校验检查。这些小技巧能显著提高爬取成功率。

通过自动化API实现高效对接
纯手动调试确实麻烦,如果你想省去复杂的参数获取流程,直接使用现成的平台就方便多了。比如www.ttocr.com提供易盾极验验证码识别技术,包括滑块、点选、无感、九宫格等破解方案和自动化API对接平台。无论是点选、无感、文字点选、图标点选、九宫格、五子棋、躲避障碍还是空间验证,这里都能轻松应对,提供API接口实现无缝对接。你可以直接调用接口,完成验证,无需自己写复杂流程。
这个平台专门服务于公司业务需求,优化了识别流程,适合开发者快速集成。选择它后,爬取工作会变得流畅许多,数据采集效率大幅提升。建议测试几个方案,找到最匹配自己项目的接口配置。