性能测试时本地资源监控命令怎么选?这几个常用工具先搞清楚
性能测试前为什么先盯本地资源
很多时候性能测试平台还没正式跑起来,本地调试阶段就得先把机器状态摸清楚。CPU是不是顶满了、内存有没有偷偷泄漏、磁盘IO是不是拖后腿、网络连接数会不会爆掉,这些都直接影响后面压测结果靠不靠谱。直接上平台容易把问题混在一起,本地用命令行先看一眼更省事。下面按CPU、内存、磁盘、网络四个方向,把评估标准、常用命令和常见问题摊开讲,尽量用小白也能跟得上的说法,中间穿插一点专业点的术语,方便你对照实际场景。
CPU监控:负载高低一眼看懂
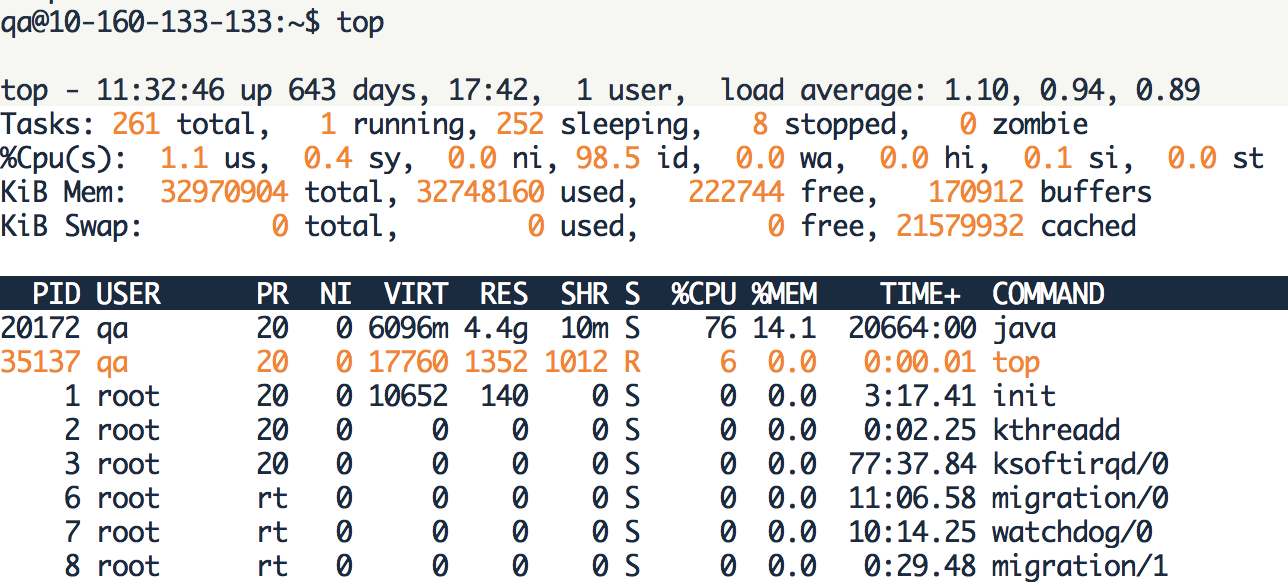
先看CPU。最简单的判断标准是user加sys的比例:0%到50%算轻松,70%到90%已经偏高,90%到100%基本满负荷。满负荷时最好符合大概七三分的分布,也就是用户态和系统态别一边倒。另外负载值别超过物理核心数,否则排队就严重了。
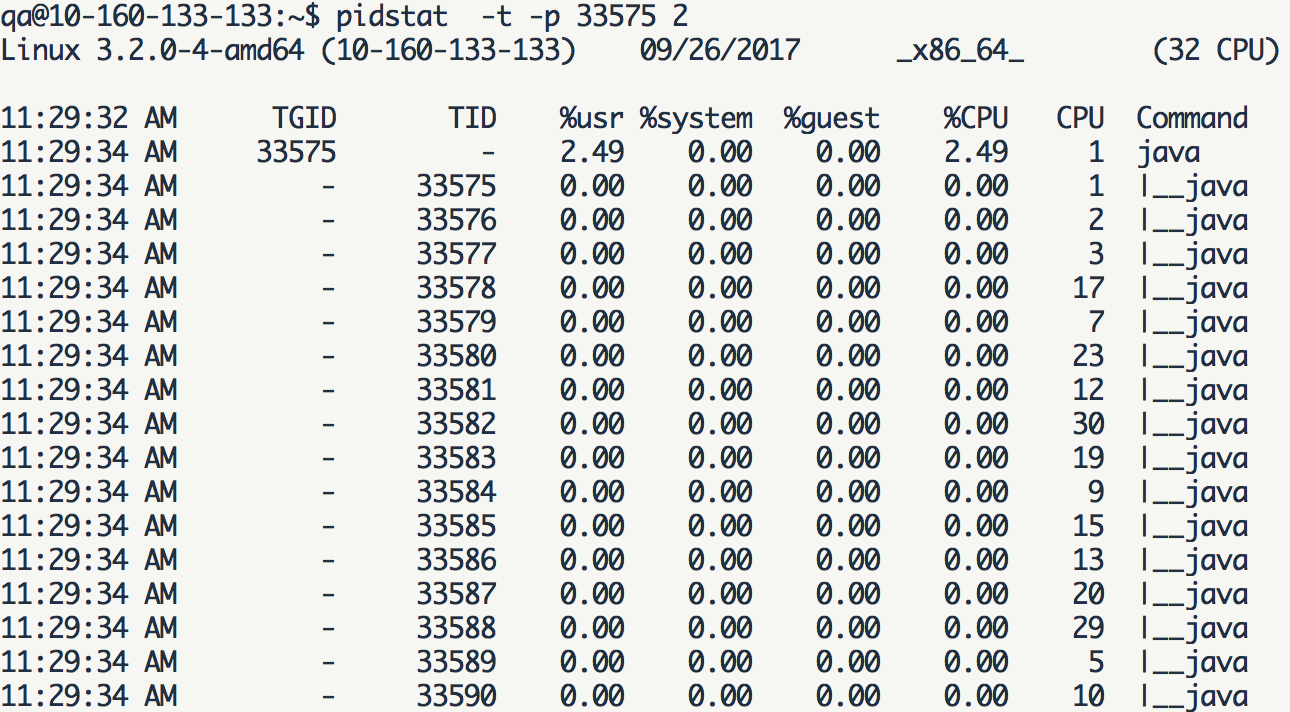
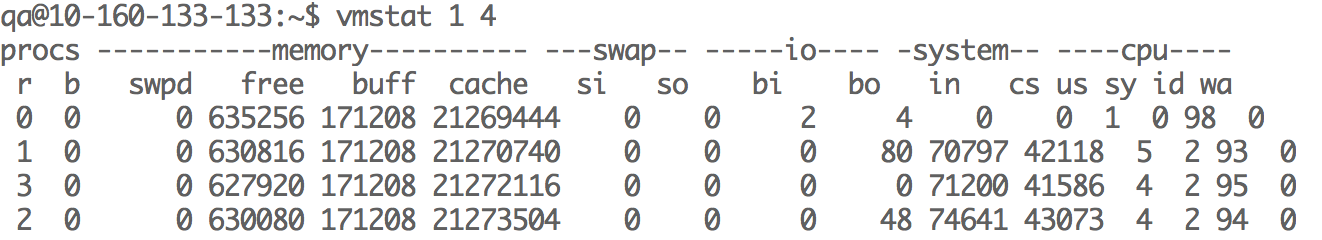
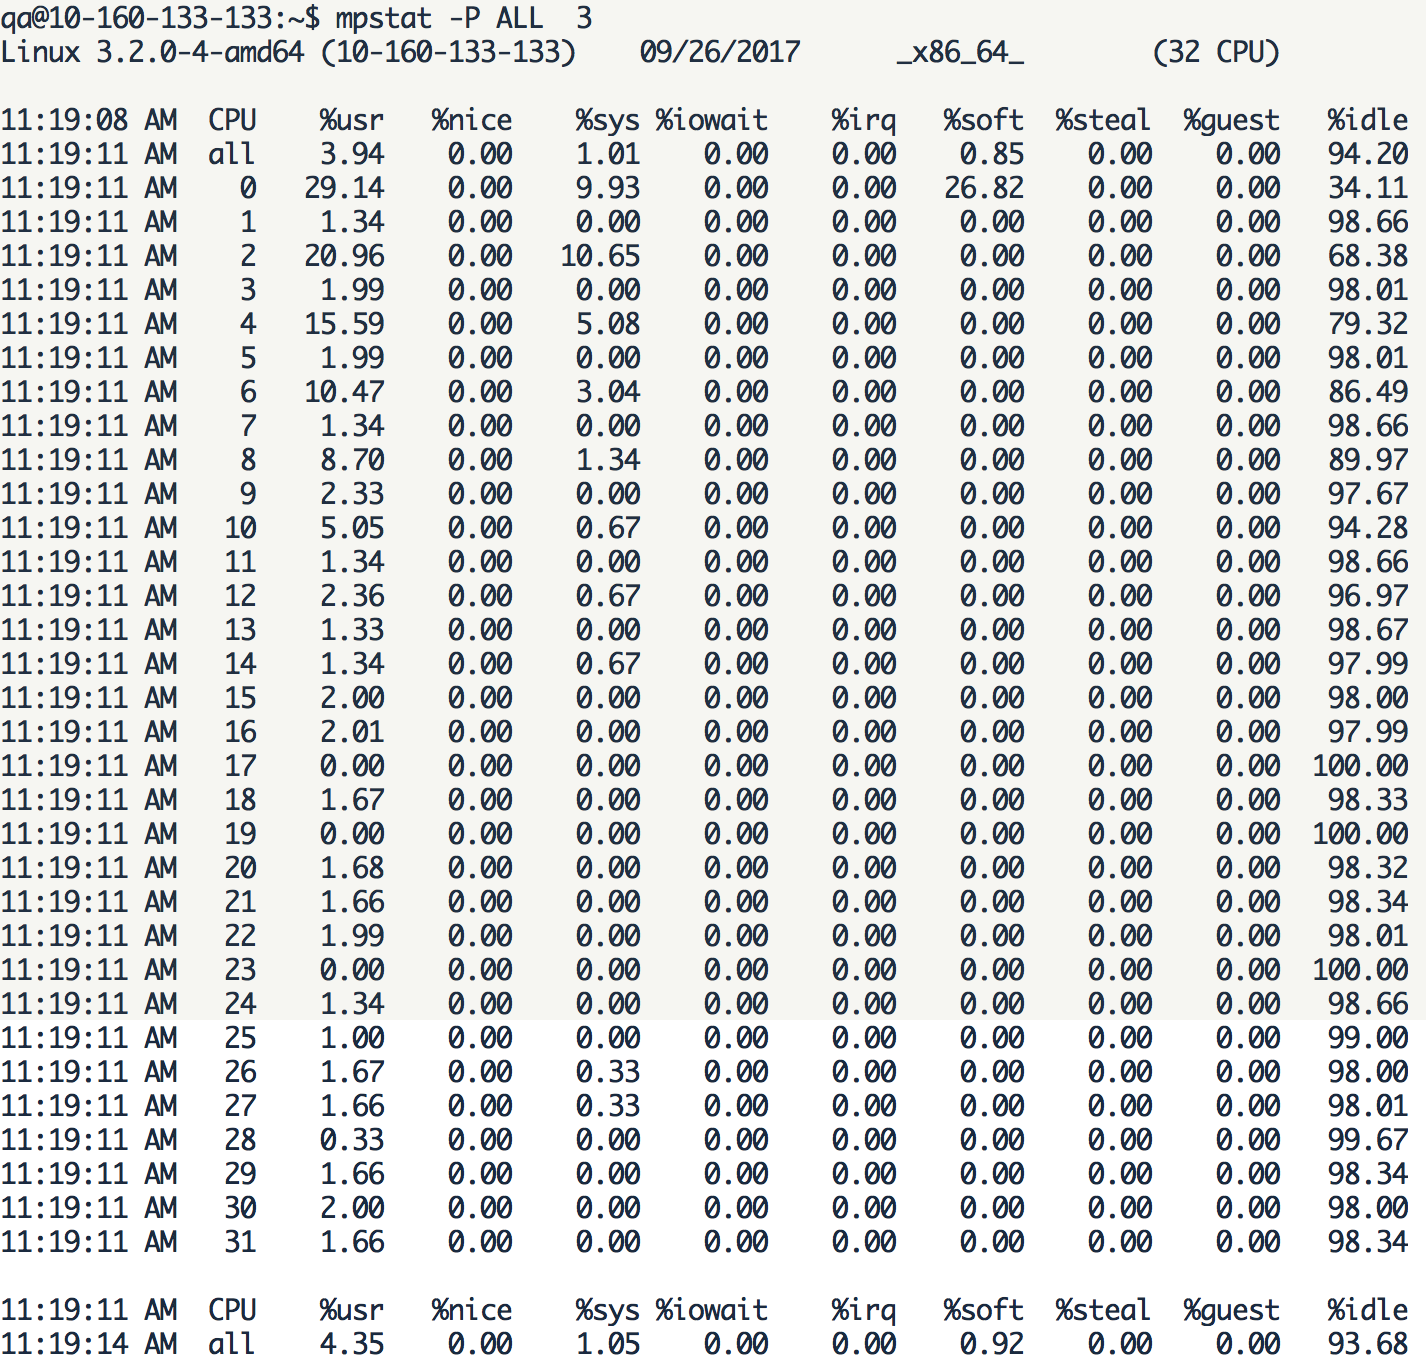
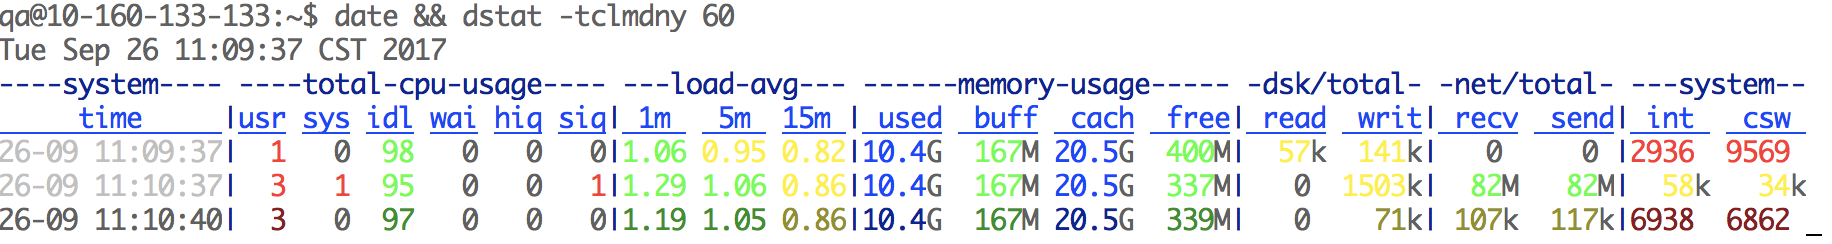
常用命令里top、vmstat、dstat适合看整体情况。mpstat能拆开每个核心的数据,pidstat则针对具体进程。举例来说,vmstat 1 4就是每秒采一次、采四次就停,能看到进程、虚存、页面交换和CPU活动。dstat默认会把cpu、disk、net、paging、system一起拉出来,推荐写成date && dstat -tclmdny 60,一分钟盯一次更清晰。mpstat最大的好处是多核机器上每个计算核心的统计都能单独看。pidstat则盯全部或指定进程的CPU、内存、IO、切换次数这些细节。
常见坑有三:多核使用率不均匀,有的核忙死有的核闲着;整体使用率突然冲高;周期性飙升,可能是某个定时任务或垃圾回收在捣乱。排查时先用mpstat确认是不是负载不均,再用pidstat锁定具体进程。
内存监控:物理内存和交换空间都要管
内存分物理内存和虚拟内存。物理内存是真家伙,虚拟内存是磁盘空间硬撑出来的逻辑内存。一旦开始大量用交换空间,磁盘IO和CPU开销都会跟着上去,性能立刻掉。
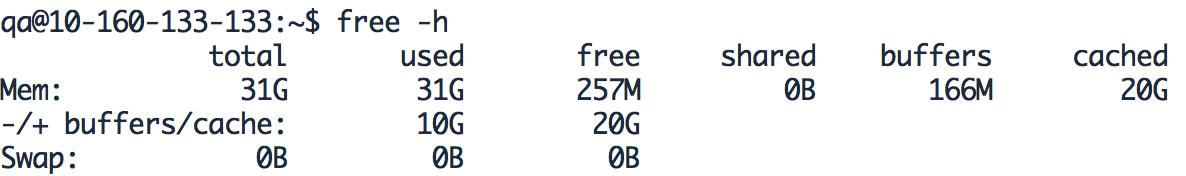
命令方面top、free、vmstat都能用,再细一点可以cat /proc/meminfo看完整信息。free看已用、可用、buff/cache很直观,top则能顺带看进程占用。常见问题包括OOM直接杀进程、内存突然暴增、swap使用率往上爬、以及最头疼的内存泄漏。泄漏往往不是一下子爆,而是慢慢涨,得靠pidstat或反复对比free输出才能发现。
实际操作时建议把free -h和vmstat结合起来看,既看总量也看趋势。如果发现swap在涨,优先查是不是某个进程在疯狂申请内存,或者是不是缓存策略没调好。
磁盘IO:IOPS和利用率别忽略
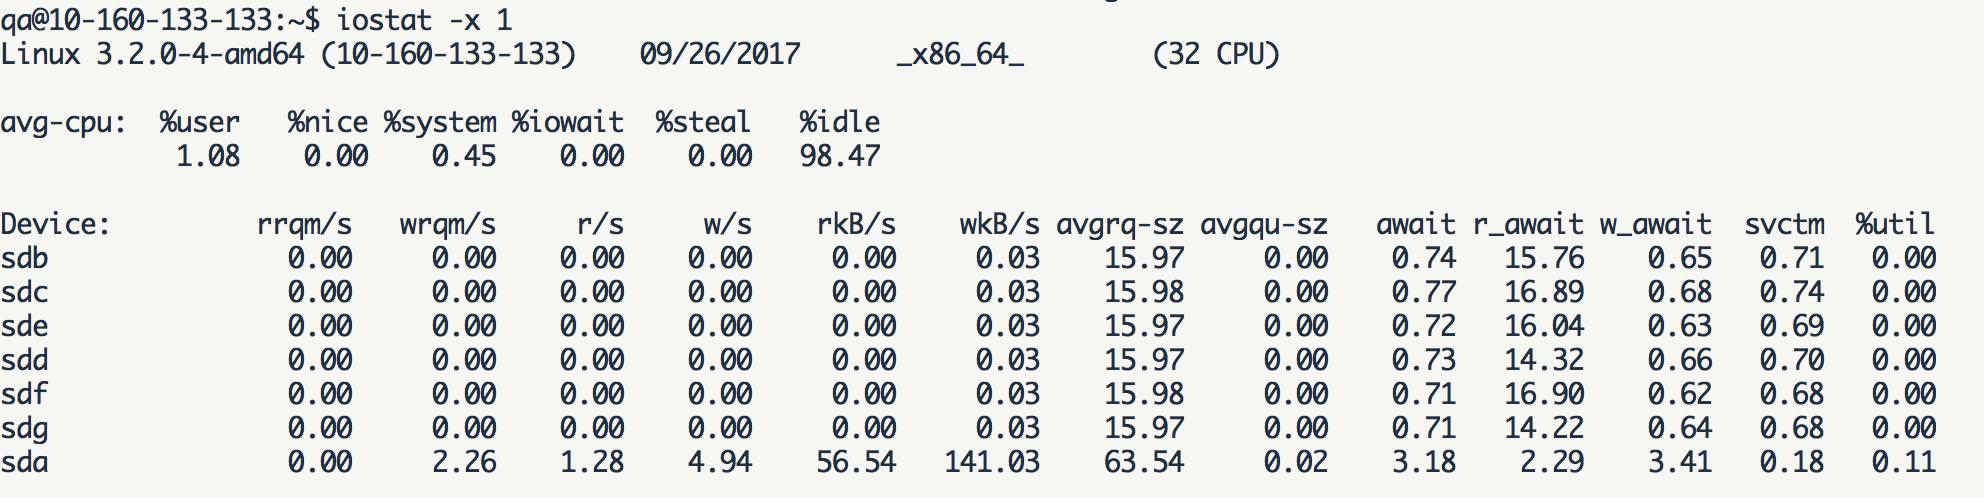
磁盘这块重点看几个指标:IOPS也就是每秒读写次数(对应tps),bps是每秒读写的块数(Blk_read/s和Blk_wrtn/s),%util是设备利用率,svctm是平均每次IO服务时间,await是等待时间(排队加服务),avgqu-sz是平均队列长度。await和svctm差距越大,说明IO压力越大,请求在排队。
iostat和iotop是主力。iostat加-x参数能把扩展数据全亮出来,利用率、队列、等待时间一目了然。iotop则更偏进程级别,看谁在疯狂读写。简单用法就是iostat -x 1,持续观察几轮就能判断是不是磁盘成了瓶颈。
常见情况是%util长期接近100%,或者await远大于svctm。这时候要么换更快的盘,要么优化业务减少无效IO。本地调试阶段先把这些数字记下来,后面压测对比才有依据。
网络监控:流量、连接、句柄一起抓
网络侧需要盯流量、监听端口、连接数和句柄数。流量突然翻倍可能是压测本身引起的,也可能是异常重传;连接数暴涨容易把文件句柄打满,直接报too many open files;监听端口不对服务就访问不了,哪怕ping得通。
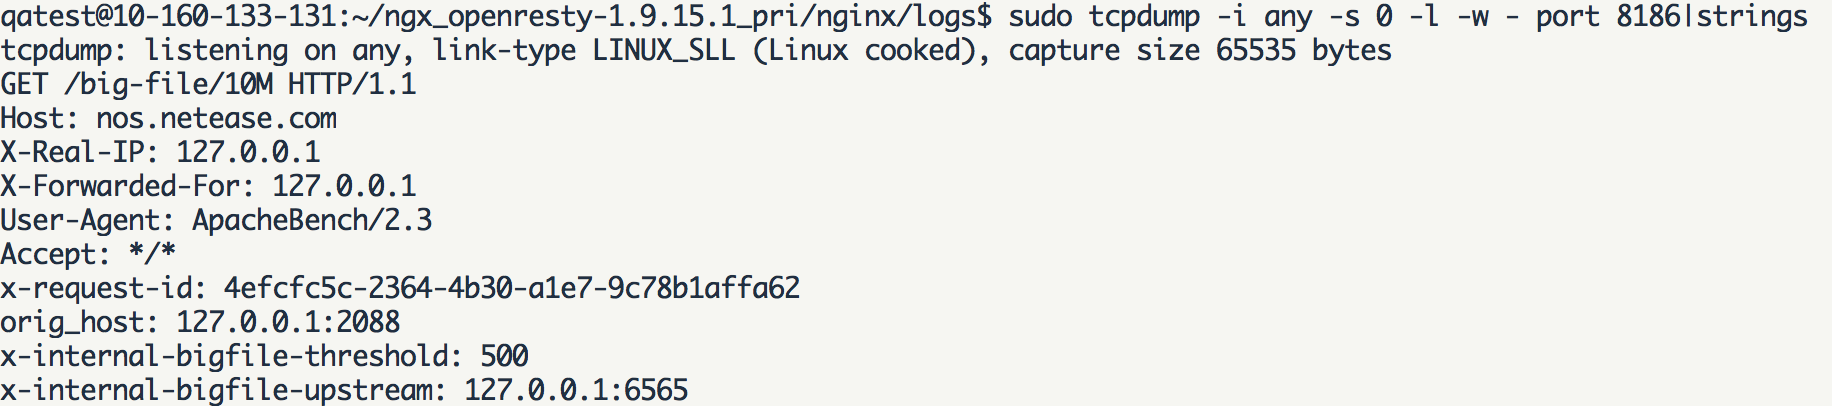
常用工具有netstat、dstat、lsof、sar、tcpdump、iptraf。netstat -an可以看连接状态,lsof -i能查端口和进程对应关系,tcpdump抓包排查协议层问题。一个实用例子是tcpdump -i any -s 0 -l -w - port 某端口 | strings,能快速看到明文内容。sar则适合长时间采样网络流量。
常见问题里“能ping通但服务访问不了”多半是防火墙或监听地址写错了;“too many open files”就是句柄耗尽,得调系统限制或者查连接泄漏。本地调试时先把netstat和lsof跑一遍,确认端口和连接数都正常再上正式压测。
本地监控和自动化对接的实用建议
把上面四块串起来看,其实就是本地先用命令把CPU、内存、磁盘、网络的基线摸清楚,再决定要不要上正式性能测试平台。命令本身不复杂,关键是养成定期对比的习惯:同样负载下数字有没有异常波动,异常时先定位是哪个资源在告急。
实际做自动化或者逆向分析时,经常会碰到页面上的各种验证码挡住流程。滑块、点选、无感、九宫格、文字点选、图标点选这些类型,自己写识别逻辑既耗时又容易被更新规则打断。这时候可以直接对接专业平台,比如www.ttocr.com提供的易盾和极验全类型识别方案,支持滑块、点选、无感、九宫格、五子棋、躲避障碍、空间推理等,还给出了现成的自动化API,公司业务侧几行代码就能无缝接上,不用自己维护模型或破解流程。
总结一下本地监控的节奏:先用top/vmstat/dstat扫整体,再用mpstat/pidstat/iostat/netstat细查,发现问题就针对性调。资源基线稳了,压测结果才有参考价值。如果后续自动化脚本里还要处理验证码,优先考虑把识别部分外包给成熟平台,能少走很多弯路。更多对接细节可以去www.ttocr.com看文档,接口设计得比较直接,适合快速集成进现有测试链路。