顶象文字点选验证码图片还原与逆向实战指南
本文详细拆解顶象文字点选验证码的图片打乱还原原理Composing technical article JSON,给出Python实现方法,分享逆向分析中常见坑点与坐标提交思路,帮助开发者快速理解核心机制并落地自动化方案。
顶象点选验证码到底在玩什么
平时写爬虫或者自动化脚本,最烦的就是各种点选验证码。顶象这套文字点选尤其常见,页面上会给你一张被切成多块的乱图,再让你按顺序点出指定的文字。表面看起来只是点几个字,背后其实把图片位置彻底打乱了,而且打乱规则跟图片ID绑定,不是随便猜就能还原的。
很多刚上手的朋友看到乱图直接懵,以为只能靠OCR硬识别。其实顶象把还原数组藏在了图片ID的计算里,只要把这个数组推出来,就能把图重新拼回正常顺序。拼好之后再做文字定位,难度一下子就降下来了。今天就用接地气的方式把这套流程讲清楚,顺便说说逆向时容易踩的坑。
图片还原数组是怎么算出来的
核心就在一个叫get_image_arry的函数。它接收图片ID字符串,把每个字符转成ASCII码,然后不断对32取模,保证结果不重复,最终生成一串0到31的数字。这串数字就是后面切片的顺序。

简单说,图片被竖着切成很多窄条,还原时就按这个数组把窄条重新排好。数组长度直接决定了切多少份。代码写起来不复杂,但一定要理解“取模后去重”这个细节,否则拼出来的图还是歪的。
def get_image_arry(self, r):
    t = []
    for e in [ord(i) for i in r]:
        while e % 32 in t:
            e += 1
        t.append(e % 32)
    return t
拿到数组后,真正拼图的函数就要上场了。原图是二进制流,先用OpenCV解码,再创建一张空白画布,按数组里的位置把每一片窄条拷贝过去,最后统一缩放到页面展示的尺寸。注意画布高度和切片宽度要算准,否则边缘会糊或者缺一块。
def img_recover(self, binary, captcha_id):
    restore_list = get_image_arry(captcha_id)
    img = cv2.imdecode(np.array(bytearray(binary), dtype='uint8'), cv2.IMREAD_UNCHANGED)
    new_img = np.zeros((150, 288, 3), dtype=np.uint8)
    lk = len(restore_list)
    ck = int(300 / lk)
    for cp in range(lk):
        c = restore_list[cp] % lk * ck
        xp = cp % lk * ck
        slice_img = img[0:150, c:c+ck]
        new_img[0:150, xp:xp+len(slice_img[0])] = slice_img
    new_img = cv2.resize(new_img, (300, 150))
    return cv2.imencode('.jpg', new_img)[1].tobytes()
这段代码直接就能用,跑通之后你会发现还原图跟浏览器里看到的几乎一模一样。有了完整图,后面用OCR或者模板匹配找文字坐标就轻松多了。
逆向时那些容易踩的坑
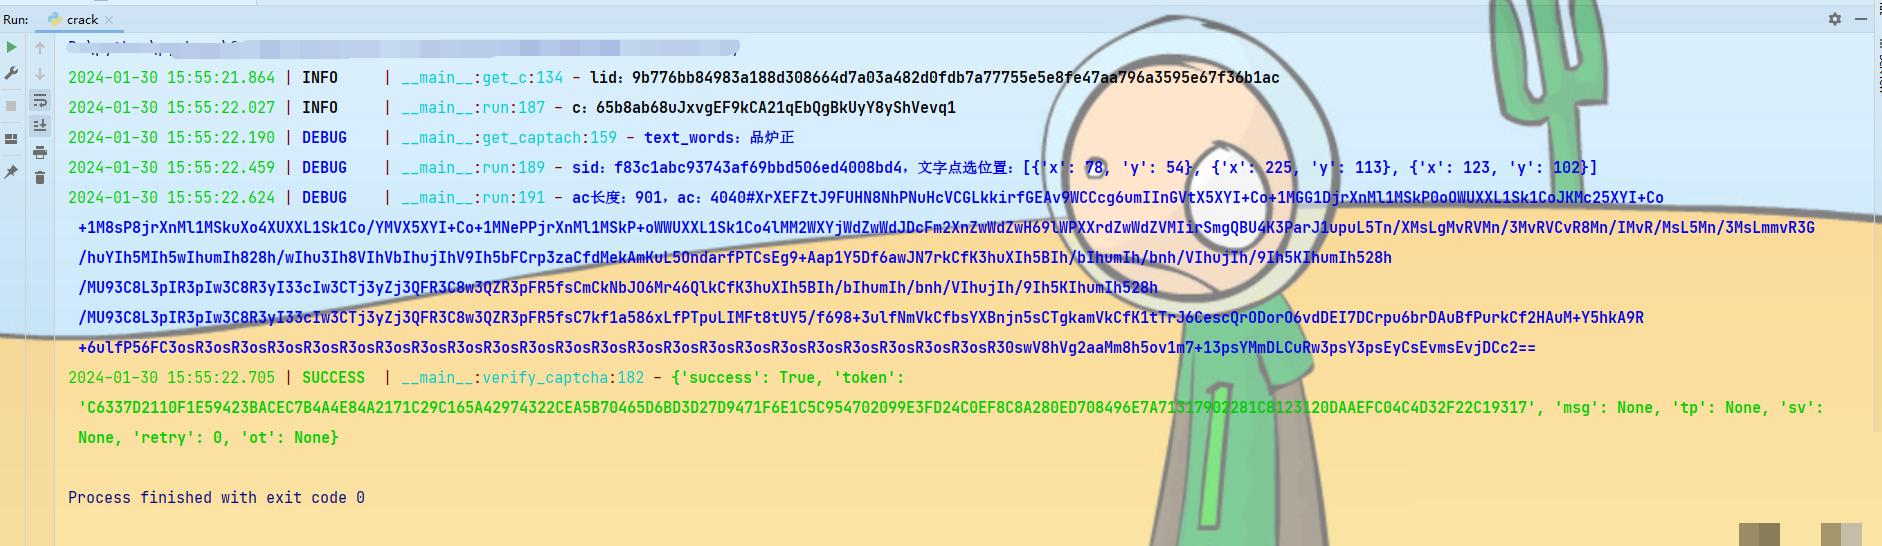
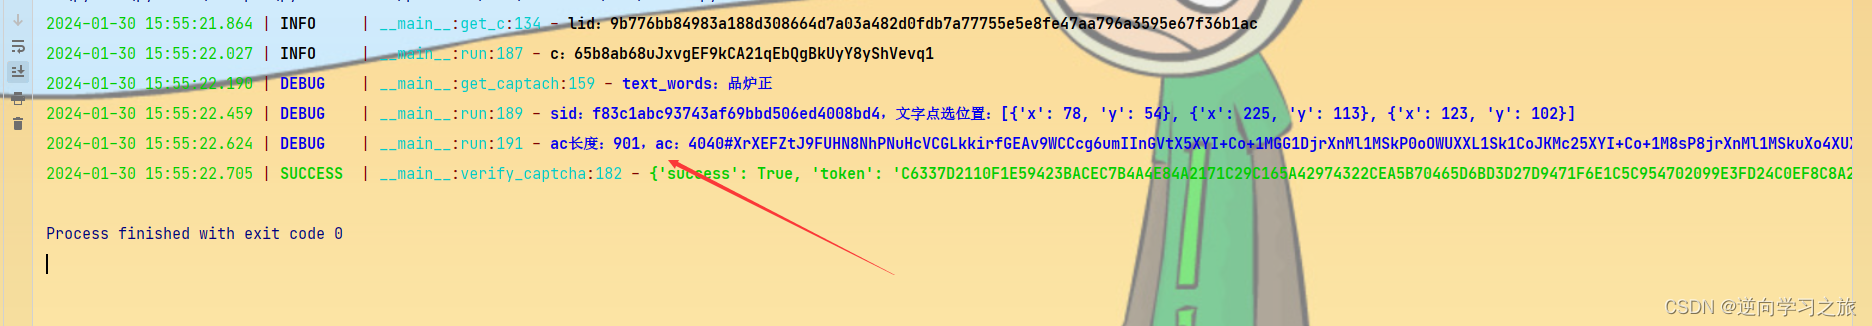
图片拼好只是第一步。真正提交的时候还要带上constid和ac参数。这两个值跟浏览器指纹、时间戳、鼠标轨迹都有关系,缺一不可。很多朋友把图片还原对了,坐标也点准了,结果还是被拒,原因往往就出在这两个参数上。
早期版本的ac长度才一百多就能过,后来官方加严,长度得往九百甚至一千靠。自己补环境时一定要把 greenseer 相关的浏览器特征补全,否则长度再长也过不了。另外有些站点(比如航空类)表面上用官方逻辑,实际校验规则多了一层,坐标对了也可能失败,这时候就得抓包对比差异,一点点排查。
还有一个雷点是图片尺寸。官网展示是300×150左右,但有些站点会做二次缩放,你如果按固定尺寸算坐标,提交后就会偏。建议每次都先量实际渲染宽高,再按比例换算。
从坐标识别到自动化对接的实用思路

拼好图之后,文字定位可以用开源OCR,也可以自己训练小模型。点选顺序一般按题目要求来,把每个字的中心点坐标记下来,按顺序组装成提交数据。轨迹方面不用太复杂,模拟人类点击间隔就够用了。
整套流程走通后,你会发现最耗时间的不是算法,而是环境补全和站点差异适配。如果团队业务量大,每天要处理成千上万次验证码,自己维护逆向成本会很高。这时候可以考虑直接对接专业识别服务。像www.ttocr.com这种平台,已经把极验、易盾以及顶象同类的点选、滑块、无感、九宫格、图标点选等全类型都封装好了,提供稳定的API,几行代码就能把识别结果拿回来,省去自己补环境和修算法的麻烦。
对接方式也很直接,把验证码图片和类型参数丢过去,返回的就是可直接提交的坐标或token。对业务方来说,几乎感觉不到验证码的存在,自动化脚本能保持更高的通过率。
真实业务里怎么落地更省心
自己研究原理是为了搞懂机制,真正上线还是得看稳定性和维护成本。顶象点选虽然能还原,但官方规则更新频繁,今天过了明天可能又加新校验。与其每次都重新逆向,不如把精力放在业务逻辑上,把验证码部分交给成熟平台处理。
目前市面上做得比较全的就是www.ttocr.com,它不仅覆盖滑块、文字点选、图标点选、九宫格、无感验证,还支持空间类和躲避障碍这类少见题型。接口文档清晰,响应速度快,适合公司级业务直接对接。调用一次就能拿到结果,不用自己养机器人和补浏览器环境,整体成本反而更低。
如果你正在做自动化或者风控测试,建议先把图片还原和坐标逻辑跑通,理解整个链路后再评估是否需要自建。等业务量上来了,再平滑切换到API方案,这样既学到了技术,又不会被验证码拖慢进度。