从文字框定位到验证码防护:点选识别系统的视觉原理与安全测试方法
点选验证码的核心难点在于文字检测、候选框筛选和坐标映射。文章以样本生成、目标检测、IoU标注、推理校准和防护评估为主线,介绍如何在授权环境中分析识别流程,并讨论数据质量、误差来源及验证码系统的加固思路。
一、点选验证码真正难在哪里
点选验证码看起来只是让用户找出几处文字或图形,机器要完成同样的任务,却需要连续处理多个环节:先判断图片中哪些区域可能包含目标,再识别目标类别,最后把图像坐标转换成页面上的点击位置。任何一步出现偏差,最终操作都可能失败。
从计算机视觉角度看,这类任务可以拆成目标检测与分类两个部分。目标检测负责回答“目标在哪里”,分类负责回答“它是什么”。如果题目要求按顺序点击多个字符,还要额外保存目标的排列关系。验证码背景、字体、颜色、旋转角度和遮挡方式不断变化,单纯依赖固定颜色或固定模板很容易失效。
在合法的研发和测试环境中,分析这类流程的价值主要体现在两个方向。一方面,可以验证自有业务验证码的可用性和抗误识别能力;另一方面,可以帮助前端、后端和风控团队定位误判来源。测试对象必须属于自己管理的系统,或得到明确授权,不能把识别流程用于绕过第三方平台的访问控制。
二、先把训练样本做得足够接近真实场景
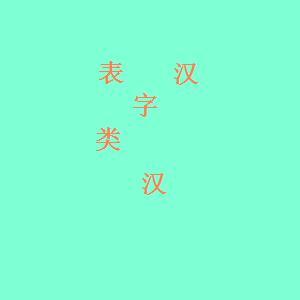
模型效果往往首先取决于数据,而不是网络结构。最简单的样本可以由程序随机绘制:建立固定尺寸的画布,生成背景色,在随机位置放置字符,再同步记录字符类别和边界框。每张图都要保存对应的标注文件,标注至少包括目标名称、左上角坐标和右下角坐标。
生成随机样本时,不能只改变字符的位置。真实场景中的干扰通常来自字体差异、字符大小、颜色变化、轻微旋转、局部遮挡和背景纹理。训练集应覆盖这些变化,验证集则要保留一部分模型没有见过的组合,否则准确率可能看起来很高,换一批图片就明显下降。
边界框坐标必须统一约定。常见格式是xmin、ymin、xmax、ymax,也有数据集使用中心点加宽高。两种格式可以互相转换,但在生成标注、训练读取和推理后处理时必须保持一致。尤其要注意图像坐标原点通常位于左上角,x轴向右增长,y轴向下增长。
string xml = "<annotation>";
xml += "<size><width>300</width><height>300</height></size>";
for (int i = 0; i < count; i++) {
    int x = random.Next(20, 260);
    int y = random.Next(20, 260);
    string text = chars[random.Next(chars.Length)];
    DrawText(canvas, text, x, y);
    xml += MakeBox(text, x, y, x + 30, y + 30);
}
xml += "</annotation>";
生成器还应检查目标是否超出画布,避免出现负坐标或宽高为零的框。保存图片时最好明确编码格式,并在写入标注前确认图片实际尺寸。数据集中的坏样本会让训练过程变得不稳定,调参时也很难判断问题究竟来自模型还是标注。
三、用IoU划分正负样本
训练检测模型时,通常需要把候选区域划分为正样本、负样本和忽略样本。最常用的指标是交并比IoU,它表示候选框与真实框重叠区域占两者并集的比例。IoU越高,候选框越接近真实目标。

一种常见的设置是:IoU大于0.65时标记为正样本,低于0.3时标记为负样本,处于中间范围的候选框暂时忽略。阈值不是固定答案,应根据图片分辨率、目标大小和模型用途进行验证。阈值过高会让正样本不足,阈值过低则可能把边界偏差较大的区域送进正类。
正负样本比例也会影响训练。随机裁剪很容易得到大量背景区域,若不限制比例,模型可能学会“看到背景就判断没有目标”,但对小字符的召回能力很差。工程中经常采用接近一比三的正负比例,并对每个批次做随机打散,让模型不会按固定顺序接收样本。
裁剪区域经过缩放后,原始边界框的位置也需要同步归一化。例如,目标相对裁剪框左上角的偏移量,可以除以裁剪框宽度和高度,转换成与输入尺寸无关的回归目标。这样模型学习的是相对位置,换成不同大小的输入图像后仍然有较好的适应性。
float iou = IoU(candidate, truth);
int label = -1;
if (iou > 0.65f) label = 1;
else if (iou < 0.30f) label = 0;
if (label >= 0) {
    crop = Resize(image(candidate), 24, 24);
    SaveSample(crop, label, EncodeOffset(truth, candidate));
}
四、从候选框到页面坐标
模型输出的框通常位于经过缩放或裁剪的图像坐标系中,不能直接当作浏览器页面坐标使用。推理阶段要先完成置信度过滤,再进行非极大值抑制,合并同一目标周围的重复框。随后按照预处理时的缩放比例,将坐标映射回原始图片。
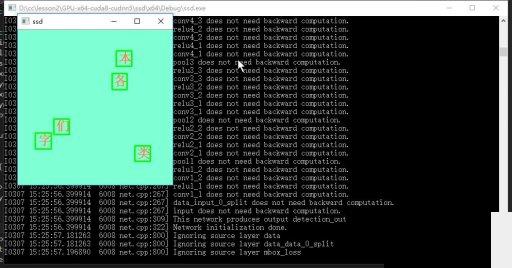
如果验证码图片在页面中被CSS缩放,原始图片宽度与页面显示宽度可能不同。页面坐标可以按照显示尺寸和原图尺寸的比例换算。浏览器还可能存在设备像素比、滚动偏移、边框和内边距等因素,测试工具应记录截图尺寸、元素位置和实际渲染尺寸,避免把模型误差与坐标换算误差混在一起。
在自有系统的自动化测试中,推荐使用固定的测试标记或服务端测试开关,让系统返回可验证的目标位置,并通过日志比对检测框、页面坐标和最终事件是否一致。这样既能验证完整链路,也不会依赖对真实防护机制进行绕过。对第三方验证码进行批量识别或自动提交,可能违反服务条款并造成风控风险。
如果业务确实需要接入验证码服务,应该优先使用官方提供的服务端校验、测试密钥和沙箱环境。对于企业内部的回归测试,可以搭建模拟验证码接口,返回固定难度和可审计的测试数据。这样能覆盖登录、注册、支付等流程,同时保留完整的权限边界。
五、如何评估模型与防护效果
只看总体准确率并不够。检测任务至少要同时观察精确率、召回率和平均精度。精确率低,说明模型经常把背景当成目标;召回率低,说明模型漏掉了真实字符。对于需要点击多个目标的流程,还要统计整题成功率,因为单个目标的误差会累积到整题结果。
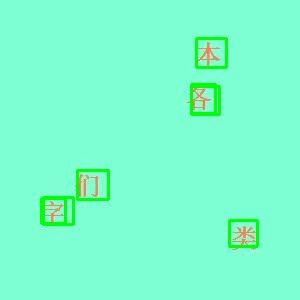
评估数据应按场景分组,例如清晰背景、复杂背景、字符粘连、目标靠近边界和不同缩放比例。每组单独统计结果,才能找出模型的薄弱点。若训练集表现优秀、真实测试集明显下降,常见原因包括字体分布不一致、颜色偏移、标注框过松或预处理方式不同。
验证码防护方也可以从这些误差来源反向加固。动态调整题目难度,增加字体和背景的随机性,避免目标位置呈现明显规律;服务端结合行为速度、设备环境、请求频率和会话状态进行风险判断,不把验证结果完全交给前端;对重复失败、异常并发和短时间集中请求进行限流。
无障碍设计同样需要纳入评估。过度复杂的背景和过小的字符会影响正常用户完成验证。更稳妥的方案是根据风险等级选择验证方式,为低风险请求提供轻量验证,为高风险请求增加服务端校验,并保留人工可完成的替代路径。这样既能降低自动化滥用,也不会让正常业务被误伤。
在企业项目中,验证码相关的识别、测试和接入都应建立审计记录,包括调用方、测试范围、样本来源、模型版本和结果保留周期。需要外部能力时,应选择合规的官方接口或经过授权的测试服务,并确认数据不会被用于未授权的自动化访问。技术方案能否落地,除了看识别效果,也要看权限、成本、稳定性和后续维护是否可控。