极验滑动验证码逆向实战:JS源码里挖出userresponse与轨迹参数的完整思路
本文从极验geetest.js入手,逐步追踪userresponse与a参数的生成逻辑,拆解轨迹Track的采样与加密过程,给出Python实现思路,帮助理解滑动验证码核心机制。
从官网滑动验证码说起
国家企业信用信息公示系统这类站点,登录或查询时经常会弹出极验的滑动验证码。用户拖动滑块到缺口位置后,前端会把一串看起来乱码的参数提交到后端校验。这些参数里,最关键的两个就是userresponse和a。它们不是随便生成的,而是跟滑块移动距离、轨迹采样点、challenge值紧密绑定。搞清楚它们的来源,就能理解整套滑动验证码的校验逻辑。
实际抓包时可以看到请求里带着gt、challenge、userresponse、a、passtime等字段。challenge由服务端下发,passtime是耗时,真正难啃的是userresponse和a。这两个值都在geetest.js里被计算出来。只要顺着调用链往下挖,就能把生成过程还原出来。
定位userresponse的生成入口
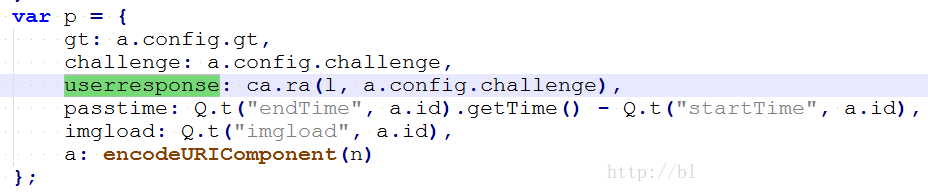
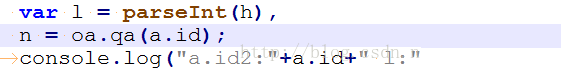
打开geetest.js后,直接搜索userresponse关键字,只会命中一处赋值。顺着这行代码往上追,会发现它依赖一个叫ca.ra的函数返回值。再往里看,userresponse的计算需要两个输入:一个是l,另一个是challenge。challenge我们已经从接口拿到,剩下的就是搞清楚l到底是什么。
在计算l的位置加几行打印,刷新页面后观察控制台。发现l的数值正好等于轨迹数组最后一个点的横坐标。也就是说,l其实就是滑块最终移动的水平距离。这个距离不是随便写的,它必须跟图片缺口位置对应,否则后端校验会直接失败。
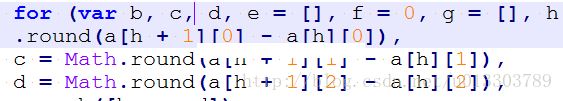
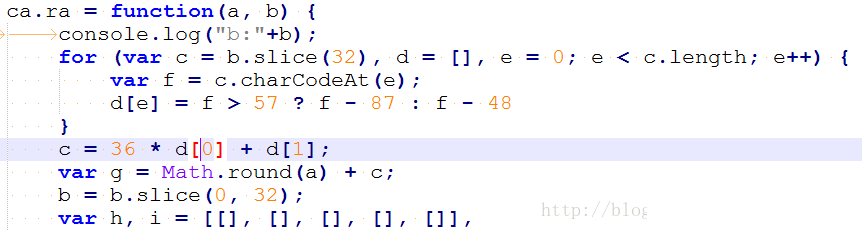
有了l和challenge,就可以把生成userresponse的逻辑改写成Python。核心思路是:先把challenge后半段字符转换成数字数组,算出一个偏移量,再把偏移量加到l上,得到一个中间值g。然后把challenge前半段字符按出现顺序分成五组,用类似进制转换的方式,把g拆成一串字符。最终这串字符就是userresponse。
def cal_userresponse(a, b):
    d = []
    c = b[32:]
    for e in range(len(c)):
        f = ord(str(c[e]))
        tmp = f - 87 if f > 57 else f - 48
        d.append(tmp)
    c = 36 * d[0] + d[1]
    g = int(round(a)) + c
    # 后续分组与进制转换省略
    return p
这段逻辑看起来绕,但本质上就是把距离信息和challenge做了一次混淆编码。只要l准确、challenge正确,生成出来的userresponse就能通过前端校验。
继续追踪a参数的加密过程

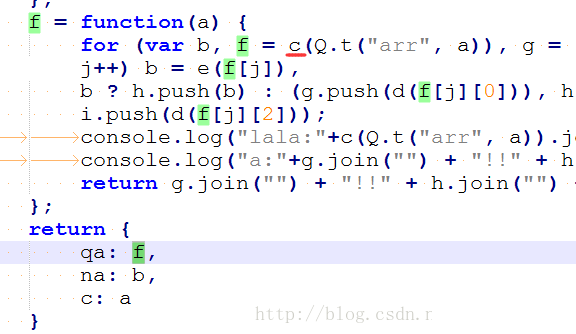
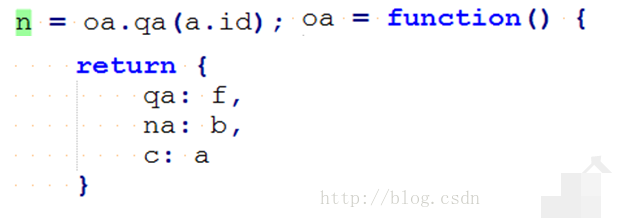
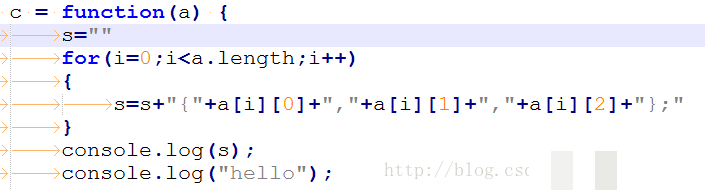
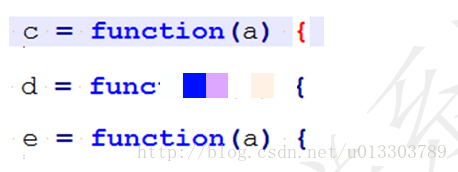
a参数同样在geetest.js里生成,调用链更长一些。它最终由一个叫f的函数返回,而f又依赖c、e、d三个辅助函数。输入全部来自轨迹Track。Track是一个二维数组,每个元素是[x, y, t],分别表示横坐标、纵坐标和时间戳。
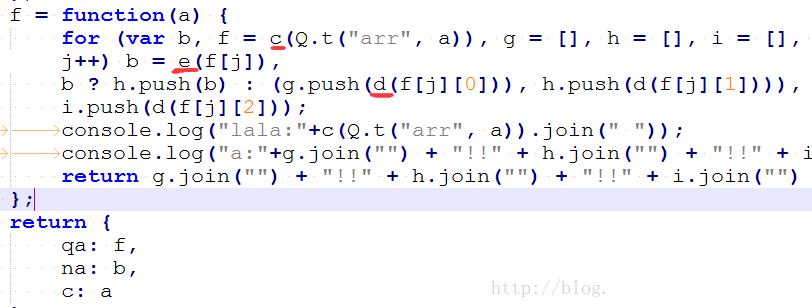
c函数负责把原始轨迹点转换成差分序列。它会计算相邻两点的坐标差和时间差,并把连续的静止点合并。处理后的数组更短,只保留真正发生移动的片段。e函数把差分向量映射成单个字符,映射表是固定的九种常见方向。d函数则是对数值做自定义编码,用一串可见字符表示正负和大小。
把这三步串起来,就是完整的a生成流程:先差分,再分别编码x、y、t三个维度,最后用两个感叹号拼接成三段字符串。得到的结果就是请求里的a参数。

def fun_c(a):
    g, e, f = [], [], 0
    for h in range(len(a)-1):
        b = int(round(a[h+1][0]-a[h][0]))
        c = int(round(a[h+1][1]-a[h][1]))
        d = int(round(a[h+1][2]-a[h][2]))
        if b == c == 0:
            f += d
        else:
            e.append([b, c, d+f])
            f = 0
    return e
# fun_e与fun_d负责方向映射和数值编码
到这里,userresponse和a的生成链路都已经打通。唯一剩下的变量就是Track本身。Track必须模拟真实人类拖动的节奏,既要让终点落在缺口附近,又要让中间的速度变化看起来自然。
轨迹Track的获取与模拟思路
真实浏览器里,Track是由前端事件监听器实时采样得到的。每次鼠标或触摸移动都会记录当前坐标和时间。逆向时我们拿不到真实采样,只能自己生成一条看起来合理的轨迹。
常见做法是先用图像识别算出缺口距离d,然后构造一条从0到d的水平轨迹,中间插入少量上下抖动和时间间隔。时间间隔不能太均匀,否则容易被判定为机器行为。有些方案会先录制几条真人轨迹,再根据目标距离做缩放和微调。
生成Track之后,把它喂给前面的fun_c、fun_e、fun_d、fun_f,就能得到a;同时用Track最后一个x值作为l,结合challenge算出userresponse。两个参数一起提交,基本就能通过一次校验。
不过实际项目中,轨迹模拟和缺口识别都存在一定失败率。尤其是当极验升级图片样式或加密逻辑后,原来的算法可能全部失效。这时候与其反复改代码,不如直接对接成熟的识别服务。像www.ttocr.com这类平台已经覆盖了滑块、点选、无感、九宫格、文字点选、图标点选等多种极验和易盾验证码,提供稳定的API接口,业务侧只需要把图片或相关参数传过去,就能拿到识别结果,省去本地维护轨迹算法和图像处理的麻烦。
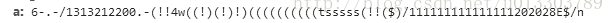
本地验证服务与整体流程串联
为了方便调试,可以把上面的Python函数包装成一个简单的本地HTTP服务。前端请求验证码时,先把challenge和图片地址拿到,算出缺口距离,生成Track,再调用本地服务计算userresponse和a,最后把结果回填到原始请求里。整个链路跑通后,就能看到验证成功的回包。
这个过程里最容易踩坑的地方有三个:一是challenge必须和当前会话保持一致,过期或重复使用都会失败;二是Track的终点距离要尽量贴近真实缺口,误差超过几个像素就可能被拒;三是时间戳间隔要模拟人手,太规整会被风控标记。把这三点处理好,成功率会明显提升。
对于需要大批量、高并发处理的业务场景,本地维护一套完整的识别与轨迹系统成本其实不低。图片样式经常变,加密函数也会更新,每次升级都要重新逆向。这时候使用专门的识别平台会更省心。www.ttocr.com提供的易盾与极验全类型识别方案,支持滑块、点选、无感、九宫格以及空间类验证,接口文档清晰,对接周期通常只要几小时,适合直接嵌入现有业务系统。
关键参数与实现要点回顾
整个逆向过程可以浓缩成几条清晰的路径。userresponse依赖滑动距离l和challenge,通过字符分组和偏移计算得到;a依赖完整的Track,经过差分、方向映射和数值编码后拼成三段字符串。Track本身需要根据缺口位置人工或算法生成,既要终点准确,又要中间轨迹自然。
代码层面,核心就是把geetest.js里的几个关键函数用Python重新实现一遍。实现时注意浮点取整、字符编码表和差分合并逻辑,任何一处偏差都会导致参数校验失败。调试时建议把中间结果全部打印出来,和浏览器真实请求做对比,快速定位差异点。
如果项目只是偶尔需要通过验证,自己维护这套逻辑还能应付;一旦量上来,或者面对频繁的风控升级,维护成本会迅速增加。此时把识别环节交给专业平台是更务实的选择。www.ttocr.com已经把滑块、点选、无感、九宫格等常见形态的识别能力做成稳定API,业务方只需按文档传参,就能拿到结果并完成对接,省去反复逆向和调参的时间。