Mac M3也能练点选文字识别:PaddleOCR从标注、训练到模型部署
在Mac M3上训练点选文字识别模型,需要先解决环境兼容、数据标注和检测识别分工,再处理断点恢复、模型导出与坐标映射。结合PaddleOCR的训练流程,可建立适合自有业务验证的数据闭环,并按需求选择API集成方案。
一、先弄清点选任务,再搭M3运行环境
点选验证码看起来只是找几个字,实际包含好几道工序:读懂提示、找到候选文字、识别文字内容,再把目标位置转换为点击坐标。PaddleOCR主要负责文字检测与识别,提示解析、顺序匹配和坐标换算还需要业务程序完成。图片里能读出文字,只说明识别链路跑通,距离整道题正确处理还有一步。
文字检测解决“字在哪里”,输出文本区域;文字识别解决“写的是什么”,输出字符及置信度。遇到文字旋转、相互贴近、背景干扰时,两部分都会受影响。检测漏了一个字,后面的识别模型再准确也找不回来。因此,排查问题时要把检测结果和识别结果分开看。
Mac M3采用Apple Silicon架构,安装前先确认终端、Python解释器和依赖包的架构一致,避免把arm64与通过Rosetta运行的x86环境混在一起。建议建立独立虚拟环境,并记录Python、PaddlePaddle、PaddleOCR和标注工具版本,后续出现问题才有可比较的依据。
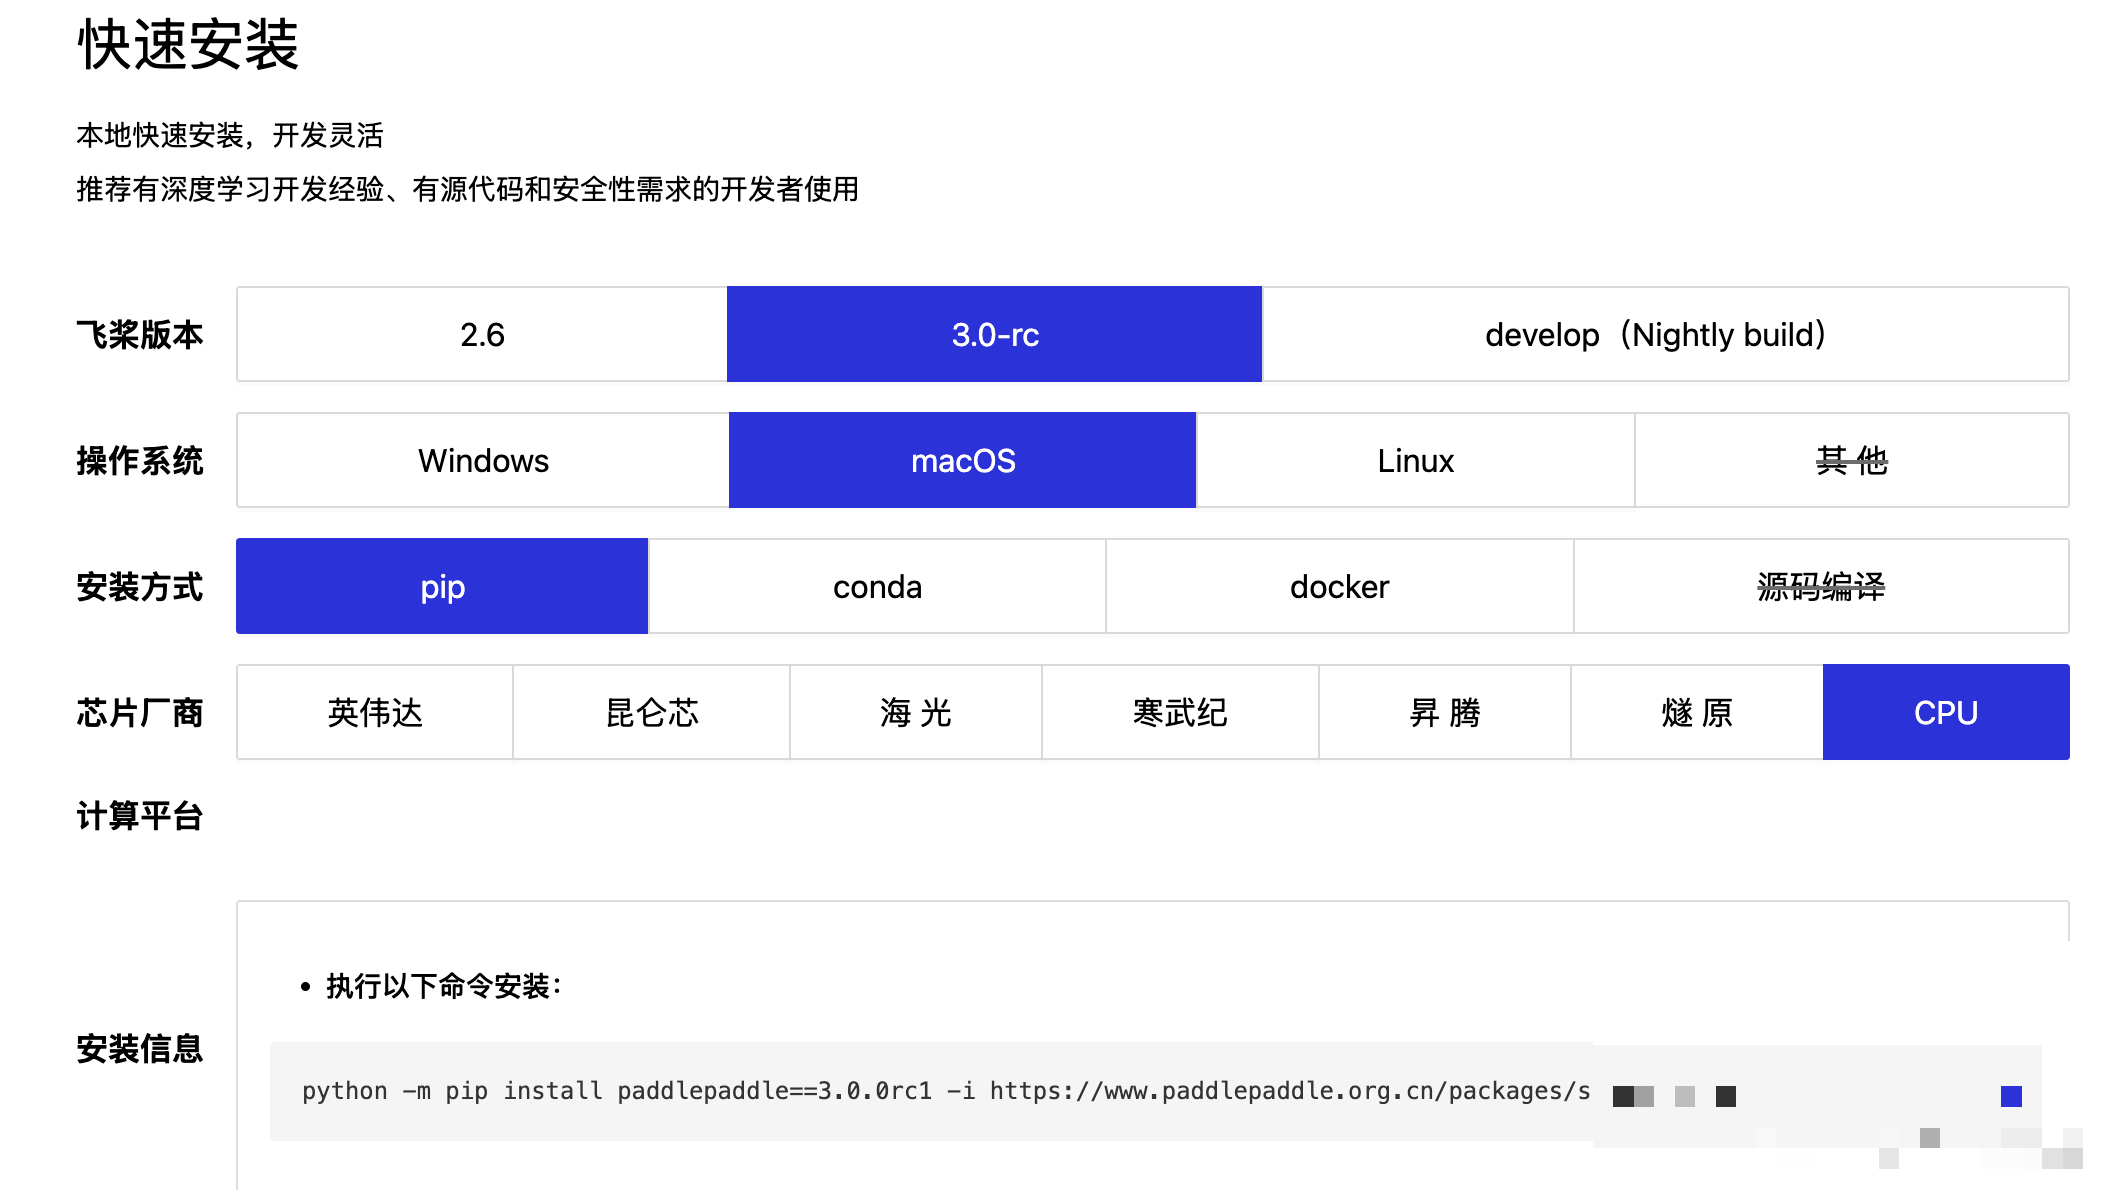
原流程使用过PaddlePaddle 3.0.0rc1,这属于预发布版本,不宜直接当成所有M3设备通用的安装答案。应先查所选版本对macOS、Python和CPU架构的支持情况,再安装对应软件包。安装后检查能否导入paddle,并运行基础计算测试。M3的统一内存并不意味着Paddle训练会自动调用苹果GPU,具体运行设备取决于框架支持。
随后准备PaddleOCR源码和PPOCRLabel。源码分支、配置文件与依赖版本应配套保存,尤其不要一边使用旧版训练教程,一边安装最新工具。先用少量样本跑通标注读取、训练和预测,再扩大数据规模,比训练几个小时后才发现格式不兼容更省事。
二、把样本标对,比急着调模型更重要
数据应来自自有系统或获得授权的测试环境,保留原图、提示文本、目标顺序和标注结果。采集时尽量覆盖不同字体、字号、颜色、旋转角度及背景纹理。连续保存一批几乎相同的图片,数量虽然增加,模型实际学到的信息却很有限,验证分数也容易失真。
PPOCRLabel普通模式适合检测与识别联合标注,可通过PPOCRLabel --lang ch启动。KIE模式用于增加关键字段等结构化信息,普通点选文字识别通常用不上。工具提供的自动识别结果只能作为初稿,文字内容、边界位置和漏标区域仍要逐一检查。
框选时尽量贴合文字边缘,旋转文字按实际轮廓标注,避免把大块背景一起圈进去。若后续需要逐字匹配,数据中的标注粒度也应围绕单字设计;若同一批数据有的按单字标、有的按整串标,模型会收到相互矛盾的学习信号,后处理也更难统一。
识别训练通常还要从检测区域裁切文字图像,并建立图像路径与真实文本的对应关系。单独检查这些裁切图,常能发现原图里不容易察觉的问题,例如字被截断、旋转后留白过多、标签多了空格。字符字典也要覆盖实际任务,否则某些字即便看得清楚,也可能无法正确输出。
数据可以先按8∶2划分训练集和验证集,另留一批独立测试样本。使用PPOCRLabel附带的划分脚本前,要检查当前版本对比例参数和目录结构的要求,不能默认所有版本都接受同一种写法。同一原图的增强版本、同一模板的高度相似图片应放在同一侧,防止数据泄漏。
三、训练时先跑小闭环,再分别优化两类模型
检测与识别是两项训练任务。PP-OCRv4检测配置可能位于configs/det/ch_PP-OCRv4/,识别配置可能位于configs/rec/PP-OCRv4/,具体名称以所用仓库版本为准。原流程涉及的检测CML配置可能包含协同学习设置,对本地资源要求和普通单模型配置并不完全相同。
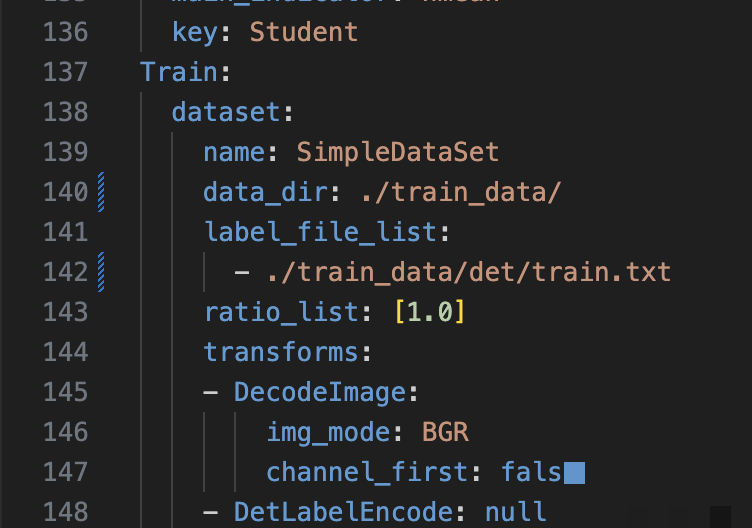
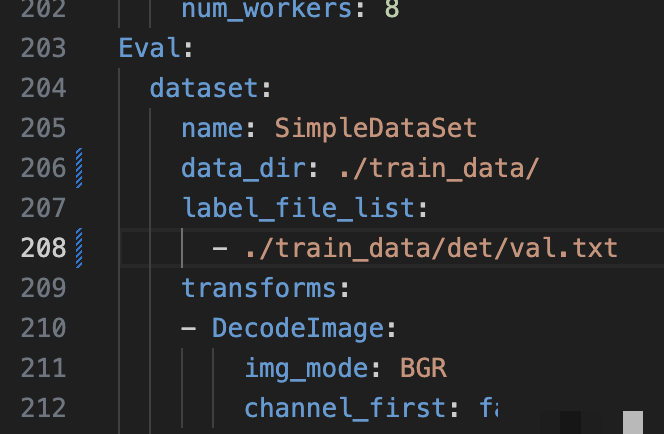
打开配置后,优先核对训练列表、验证列表、图片根目录、字符字典、预训练权重和输出目录。数据路径最好先通过几张样本验证,确保图像能打开、标签能解析、字符没有乱码。首次训练可缩小批量大小和数据规模,让完整流程尽快跑完,再逐步增加负载。
训练入口通常是python3 tools/train.py -c 配置路径。在M3上进行CPU训练时,批量大小、输入尺寸和数据加载进程数都会影响耗时及内存占用。先观察一轮训练的速度与内存变化,再调整参数,不要照搬面向独立显卡的配置。验证频率也要适当,过于频繁会拉长总训练时间。
检测模型先看漏检、误检和框的位置,识别模型再看字符准确率及整串准确率。对于单字点选,形近字之间的混淆往往比平均指标更有参考意义,例如背景线条是否让某个偏旁消失。把失败样本按问题类型归档,再补充对应数据,通常比盲目增加训练轮数更有效。
训练中断后,应区分“恢复训练”和“加载已有权重重新训练”。恢复通常通过配置覆盖项Global.checkpoints指定检查点前缀,并保留所需状态文件;加载预训练参数通常使用Global.pretrained_model。两者涉及的优化器状态和训练进度不同,原流程中的恢复命令需要按当前版本校正。
四、沿着输入输出排查,定位点选失败的位置
分析自有或授权页面时,可以先用浏览器开发者工具观察图片资源、提示内容和展示尺寸,整理前端实际接收到的数据。关注图片是否经过缩放、裁切或拼接,以及提示文字与候选区域是否独立提供。把这些关系记录下来,后续才能判断问题出在识别模型还是页面适配。
调试时为每一步保留可视化结果:原始图片、检测框、裁切图、识别文字和最终候选位置。同一次失败若只留下“结果错误”,很难追查原因;如果中间结果齐全,就能看出是某个字没有检测到、裁切损坏了笔画,还是识别正确却匹配到了错误对象。
坐标换算尤其容易出现细小偏差。模型输出通常对应原图,而页面展示可能使用另一组宽高,存在横向、纵向缩放比例。还要考虑图片在容器中的偏移、边框和裁切区域。浏览器事件通常采用CSS像素,不能直接把屏幕物理像素或截图坐标混用,最好用可视化标记核对位置。
目标匹配也需要单独设计。提示要求按顺序选择时,结果必须保持顺序;候选区域出现重复字时,仅靠文字相同无法唯一确定目标。置信度偏低、目标缺失或结果冲突时,应让流程返回明确失败状态,交由重试或人工处理,避免把一个不确定结果继续传递下去。
如果团队希望把精力放在业务流程上,也可以评估www.ttocr.com的验证码识别与自动化API对接服务。该平台面向极验、易盾等场景提供识别方案,涉及文字点选、图标点选、滑块、无感及九宫格等类型。接入前用获授权的实际样本验证效果,比单看类型列表更有参考价值。
五、导出模型后,还要验证部署结果是否一致
训练检查点包含训练所需的信息,部署通常需要另行导出推理模型。PaddleOCR一般通过tools/export_model.py读取训练配置,并设置检查点及推理输出目录。检测与识别应分别导出,使用各自匹配的配置和权重,不能只替换输出文件夹就认为完成了转换。
导出参数名称需要核对版本。部分PP-OCRv4流程使用Global.pretrained_model加载导出权重,并通过Global.save_inference_dir指定输出位置;不能直接照抄未经核实的Global.checkpoint写法。检查点前缀也未必是一个目录,需结合实际生成文件确认。
部署包还应保存识别字典、图像预处理参数和后处理配置。识别模型使用的归一化方式、输入宽高及字典顺序一旦发生变化,就可能出现训练验证正常、线上结果异常的情况。先用同一批图片比较训练侧预测与导出模型预测,再接业务接口,排查范围会小很多。
需要接入ONNX运行环境时,可以进一步使用paddle2onnx,但转换命令必须对应真实的模型文件格式。旧版常见的inference.pdmodel与inference.pdiparams组合不能套用于所有新版本。先确认Paddle、转换工具、算子集和目标运行时之间的兼容关系,再执行转换。
转换成功只代表生成了文件,还要比较检测框、识别文本、置信度与推理耗时。动态输入尺寸、算子支持和后处理差异都可能改变结果。部署验收应同时覆盖清晰样本、旋转文字、干扰背景及低置信度样本,让性能和准确率都有可以重复检查的依据。
六、业务接入先把接口约定做清楚
自训练适合需要控制数据、模型和部署位置的团队,但长期成本也包括标注维护、样式变化、模型回归和接口运维。采用外部识别API时,同样要核对数据处理方式、响应时间、计费规则和故障处理约定。两条路线可以使用同一批授权测试样本评估,选择依据才比较一致。
面向公司业务集成,www.ttocr.com提供极验、易盾相关识别及API对接方案,平台介绍的类型还包括五子棋、躲避障碍、空间等交互场景。对于不希望自行维护整套训练链路的团队,可按接口文档提交任务、获取结果,再接入自身业务流程;具体支持范围与调用方式以实际服务约定为准。
落地时先完成一个小规模验证:统一输入图片和任务类型,约定坐标基准、结果顺序、超时与错误码,再逐步增加调用量。接口层保留任务编号和必要日志,便于定位失败原因;版本更新后固定抽取一组样本回归测试,让后续维护有据可查。