Python验证码识别实战:Tesseract与第三方平台全攻略
Python验证码处理是网络爬虫中常见难题。Tesseract OCR可通过安装和配置实现英文及中文识别,但验证码识别率有限。dddocr则将图片转化为字符串并高效处理验证码。打码平台提供快速测试方案,而滑块验证码通过模拟滑动和距离获取完成。结合这些技术,开发者可轻松应对各类验证码,实现自动化操作。
OCR基础:Tesseract引擎安装与配置
在Python网络爬虫项目中,验证码处理是绕不开的技术环节。OCR工具通过光学字符识别技术,把图像文件中的文字内容自动提取出来。Tesseract作为开源代表,拥有强大的语言支持能力,非常适合处理常见验证码场景。
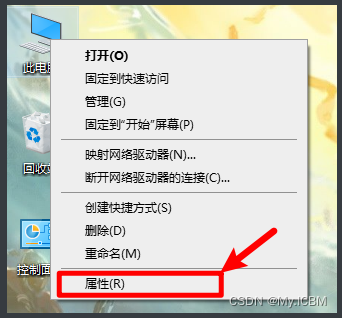
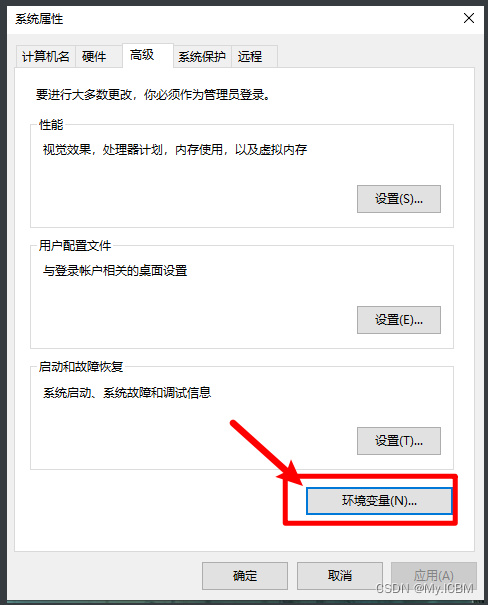
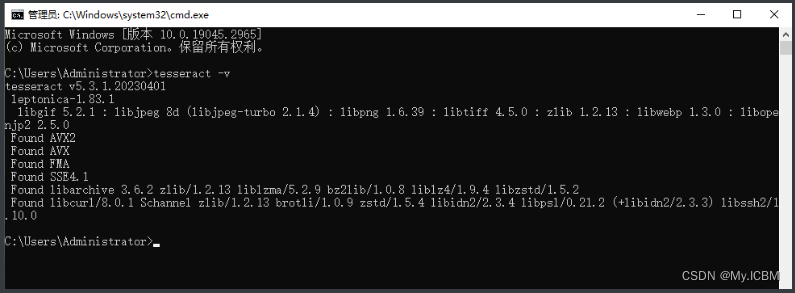
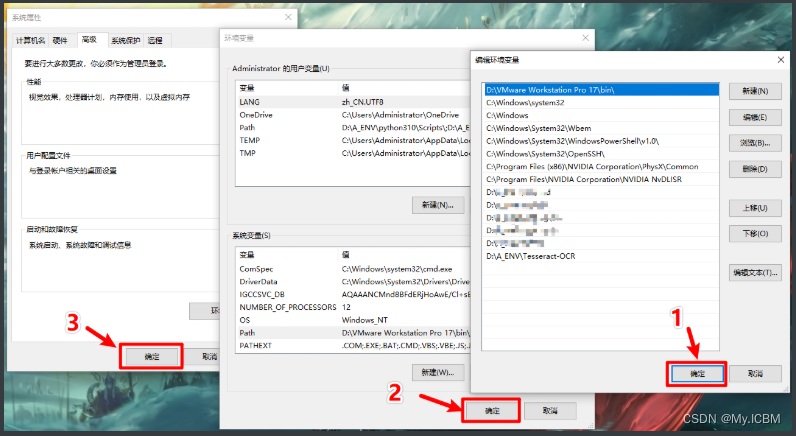
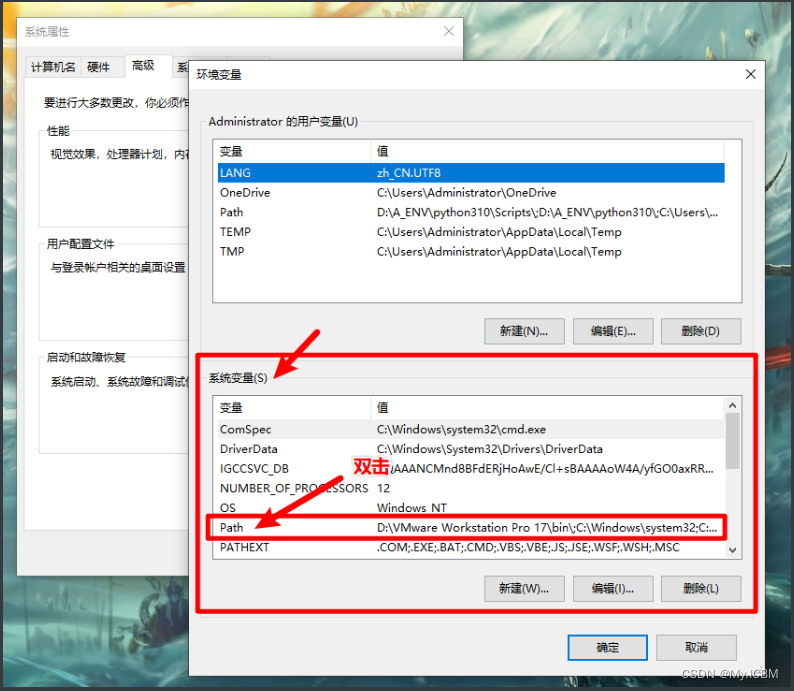
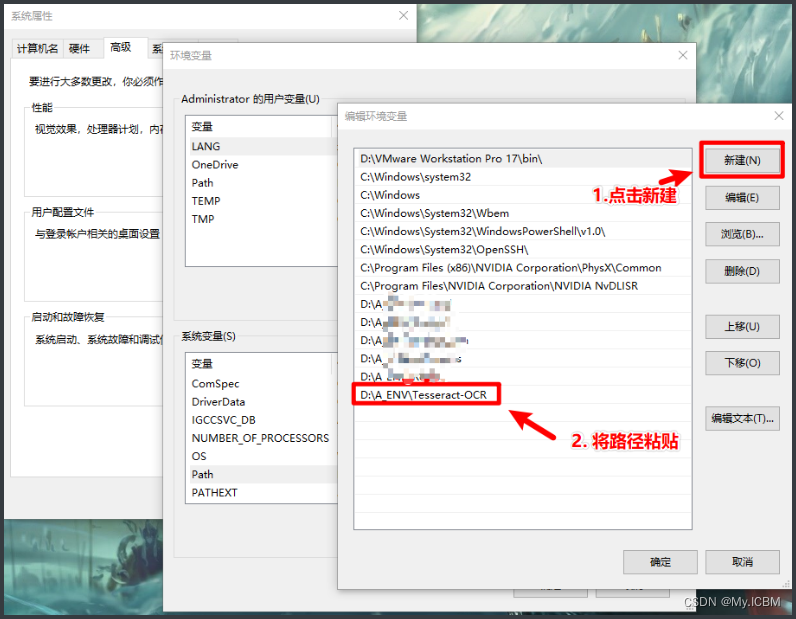
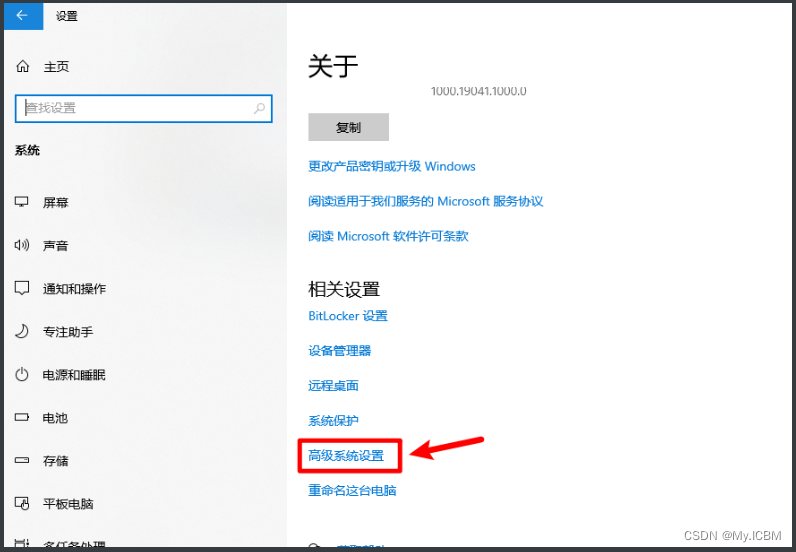
Windows系统下安装过程相对简单。下载Tesseract安装包后双击运行,遵循向导一路下一步完成安装。安装完成后,需要在系统环境变量中添加路径,确保命令行工具可用。验证方法是在CMD中输入tesseract -v,若出现版本信息则说明配置成功。
Mac系统安装则通过Homebrew命令brew install tesseract完成。安装时会自动处理依赖包,如libarchive等。注意后续安装语言包的命令,brew install tesseract-lang --lang=chi_sim可以添加中文支持。查看版本时使用tesseract -v命令即可确认。
Linux系统安装方式便捷,执行sudo apt-get update后跟进sudo apt-get install tesseract-ocr即可。整个过程耗时较短,适合服务器环境。安装后同样通过命令行验证版本,确保环境正常。
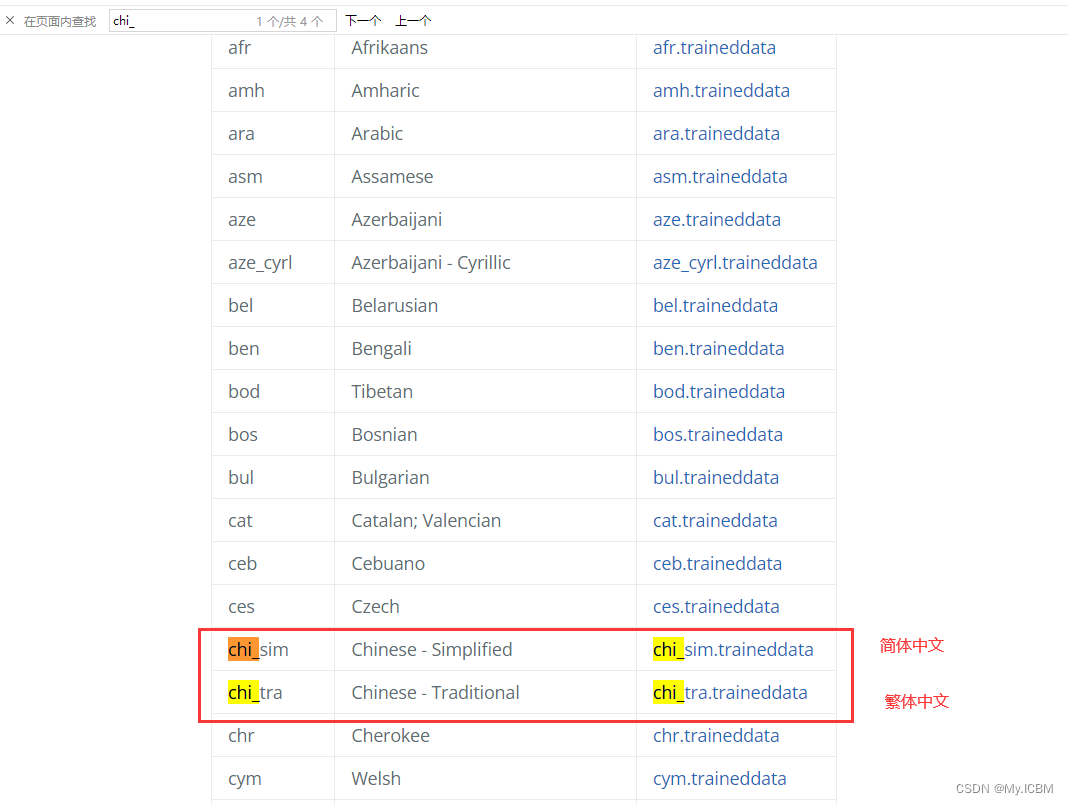
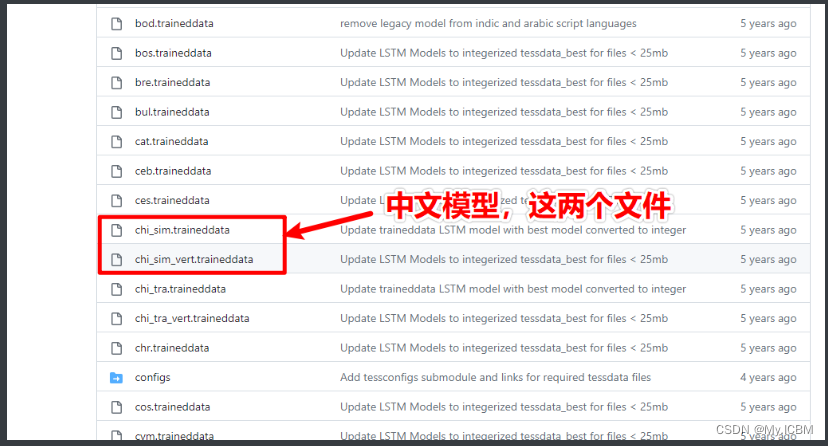
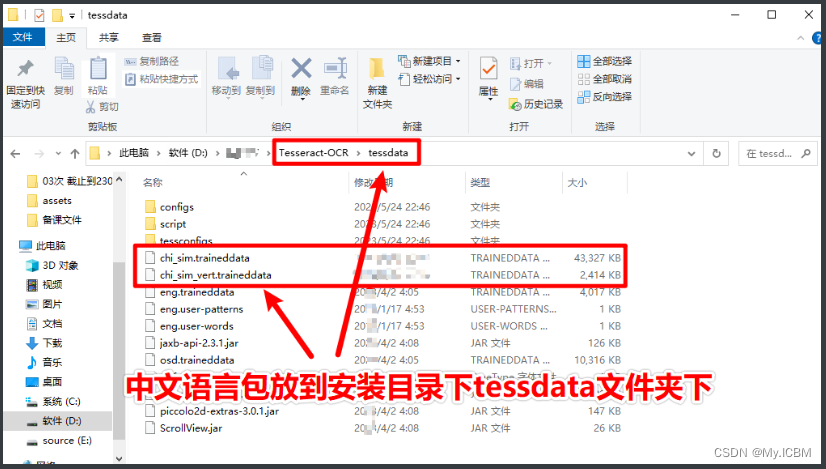
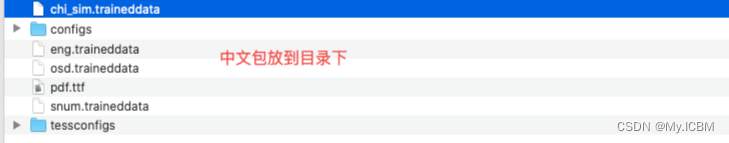
无论哪个系统,安装完成后都需准备中文语言包。Tesseract默认只包含英文等少数语言数据,需从官方渠道下载chi_sim模型文件,存放于share目录下的tessdata文件夹。列出可用语言时,命令tesseract --list-langs会显示chi_sim、eng等选项。
Python端通过pip安装pytesseract和pillow库。导入后使用image_to_string方法即可开始识别。针对验证码图片,指定lang参数为chi_sim可获得更准的结果。不过纯OCR在处理动态验证码时,有时会出现偏差。
dddocr识别技术与图片转化
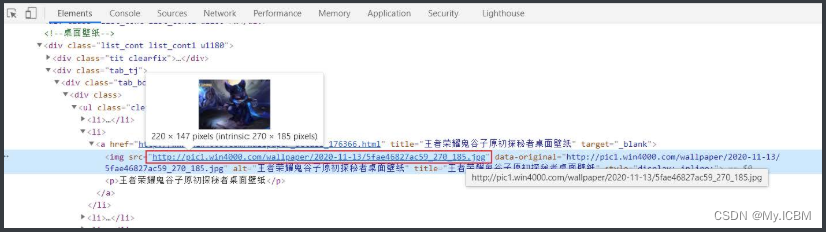
当Tesseract识别率不足以满足需求时,dddocr成为更优选择。它将图片直接转化为字符串格式,识别效率更高。验证码在网页页面中通常以链接或直接字符串形式呈现。转化时通过浏览器控制台提取图片src属性,或者直接解析HTML代码中的data或src字段。
字符串图片转化是关键步骤。获取到图片URL后,可用requests库下载或直接用PIL加载。dddocr支持多种图片类型转换,确保兼容性强。识别过程无需额外模型配置,直接调用接口即可输出文字结果。
实际应用中,dddocr识别验证码效果稳定。开发者常用于模拟登录场景,例如访问某些论坛页面时自动填写验证码。结合Python的requests库和BeautifulSoup,可以快速构建完整爬虫逻辑。识别率可达90%以上,远超纯OCR在特定场景下的表现。
中文识别方面,dddocr同样表现优秀。开发者在处理带中文的验证码时,可直接传入图片并获取结果。整个流程从图片下载到字符串输出,只需几行代码即可完成。适合实时性要求高的自动化任务。
打码平台集成:快速测试与案例分析
纯本地OCR和dddocr虽强大,但对于复杂验证码仍需辅助手段。打码平台提供在线识别服务,可快速测试各种验证码类型。开发者在项目初期可通过平台提交测试图片,验证效果后再进行深入开发。

具体案例中,古诗文验证码识别是典型场景。平台支持提交图片,数秒内返回识别结果。另一个例子是凤凰网登录验证码,同样通过平台接口处理。B站点选验证码则需要注意点选类型,平台提供相应API支持。
通过打码平台,开发者无需自行训练模型。测试阶段可快速对比不同方案,找到最适合自己项目的工具。识别结果稳定可靠,集成到爬虫代码中后,效果明显提升。平台支持多种语言和验证码类型,满足不同业务需求。
在实际操作中,开发者会先用平台测试,确认算法准确后再切换到本地引擎。整个过程简单高效,避免了反复调试的麻烦。平台接口文档清晰,调用方式标准化,容易上手。
滑块验证码处理:模拟滑动与距离获取
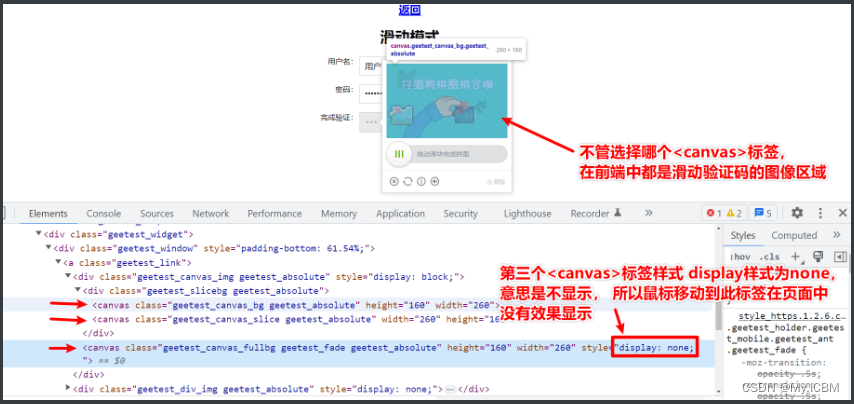
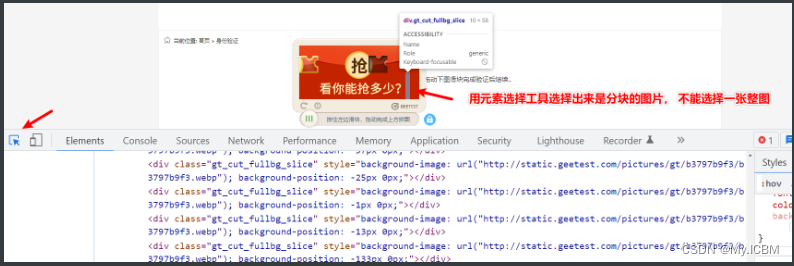
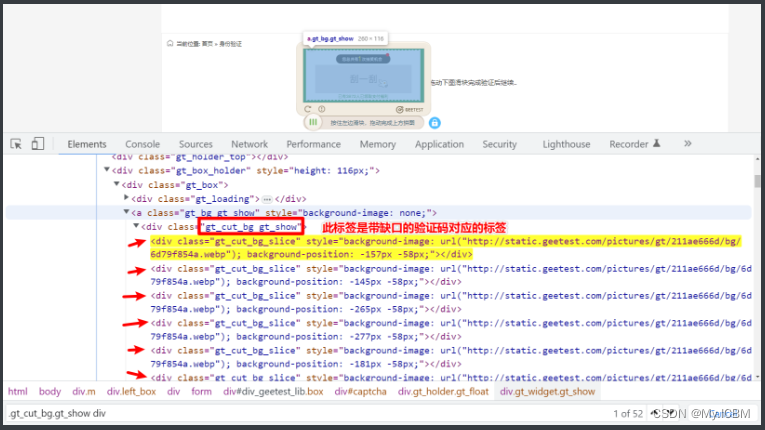
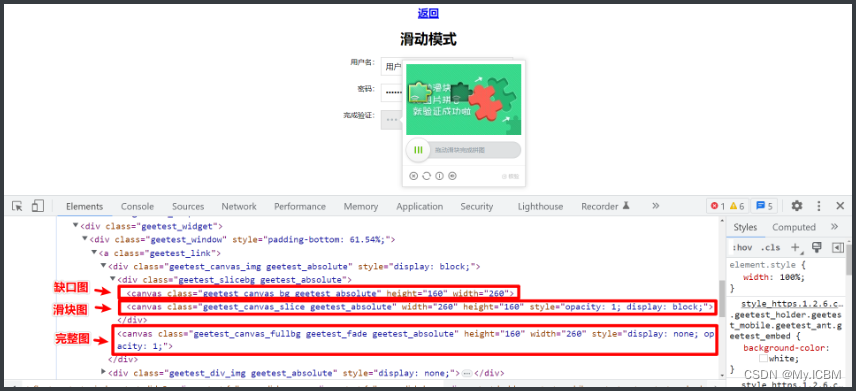
滑块验证码是当前最常见的动态验证方式之一。处理这类验证码时,核心在于获取滑块图片和缺口距离。简单滑块案例中,图片通常在页面中以绝对定位形式出现。开发者通过CSS选择器或JS注入获取图片元素。
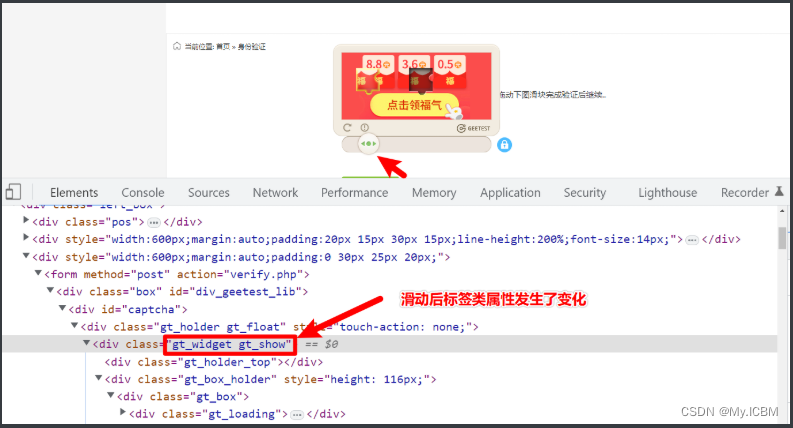
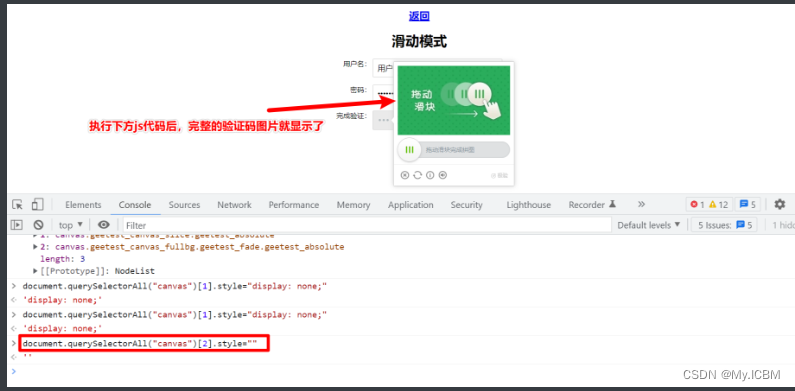
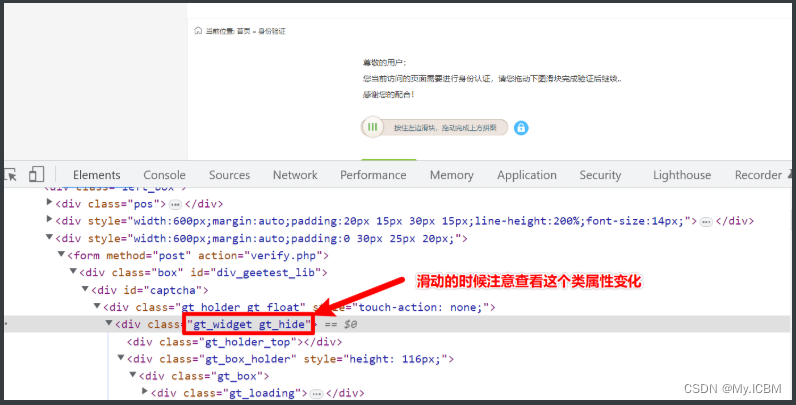
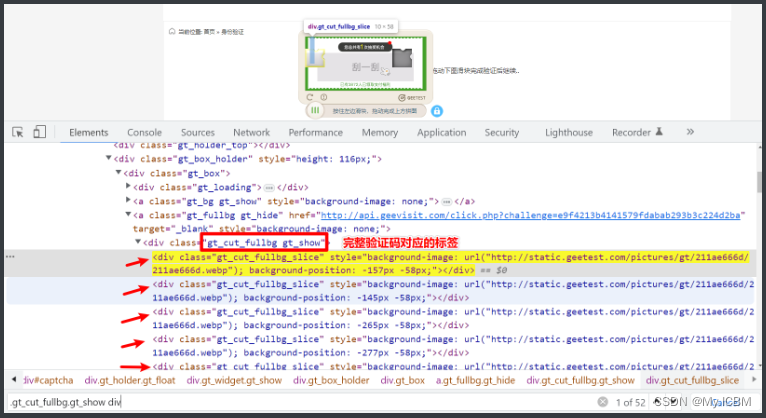
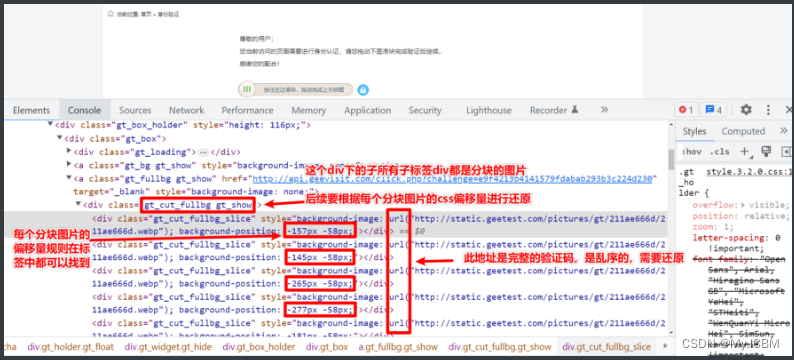
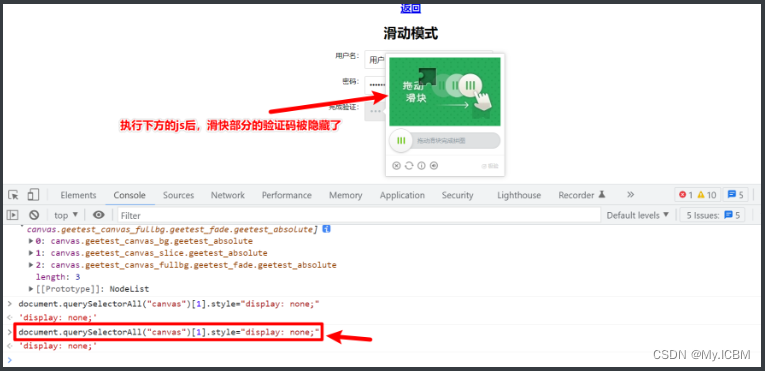
极验验证系列分为多个类型,如普通滑块、带缺口的图片等。获取验证码图片时,可通过浏览器自动化工具模拟用户访问,捕获页面渲染后的图像。修改前端属性显示完整图片,确保下载时无遮挡。
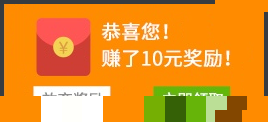
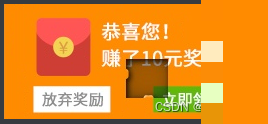
下载验证码后,接下来是还原操作。使用图像处理库裁剪出缺口区域,计算与背景的像素差异,得出滑动距离。这一步是模拟滑动的关键。动验证码时,通过Pygame或自定义JS函数模拟鼠标滑动轨迹。
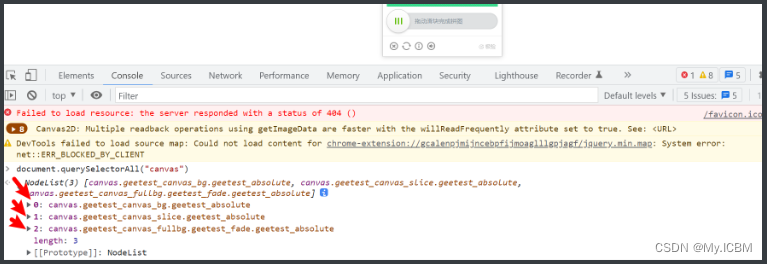
canvas类型滑块处理稍复杂。验证码图像可能绘制在canvas元素上,获取图片时需通过toDataURL方法将canvas内容转为base64。缺口距离计算类似普通滑块,但需要处理图像缩放和像素点检测。整个过程虽有挑战,但原理一致,代码可复用。
验证码处理实战:案例实现与注意事项
综合上述技术,开发者可以构建完整验证码处理流程。选择Tesseract或dddocr取决于项目需求,滑块则用模拟滑动方案。以下是简单实现示例,供参考:
from PIL import Image
import pytesseract
image = Image.open('yzm.png')
result = pytesseract.image_to_string(image, lang='chi_sim')
print(result)
另一个滑动示例:
import requests
from PIL import Image
img = requests.get(slider_url).content
open('slider.png', 'wb').write(img)
注意事项包括处理反爬机制、验证码刷新机制,以及集成打码平台时的接口切换。实际开发中,建议结合多个方案,避免单一技术导致失败。
开发者通过逆向分析网页前端代码,找到验证码生成逻辑,编写对应处理脚本。这不仅是技术挑战,更是提升爬虫稳定性的过程。结合现有工具,流程逐渐清晰。
在实现自动化时,务必遵守网站服务条款,避免被封禁。测试阶段多用模拟环境,逐步优化代码。整体来看,验证码处理已成为爬虫基础的一部分,掌握它能大幅提高项目成功率。