脱掉UPX外壳之后:一道CTF逆向题的四字节密钥与异或真相
一道带UPX壳的六十四位逆向题,关键不在复杂算法,而在厘清数据流、小端存储与循环异或。借助已知明文可以直接恢复四字节密钥,再用短脚本验证完整结果,同时辨清竞赛分析与业务自动化的边界。
一、先认清外壳,别急着读反编译代码
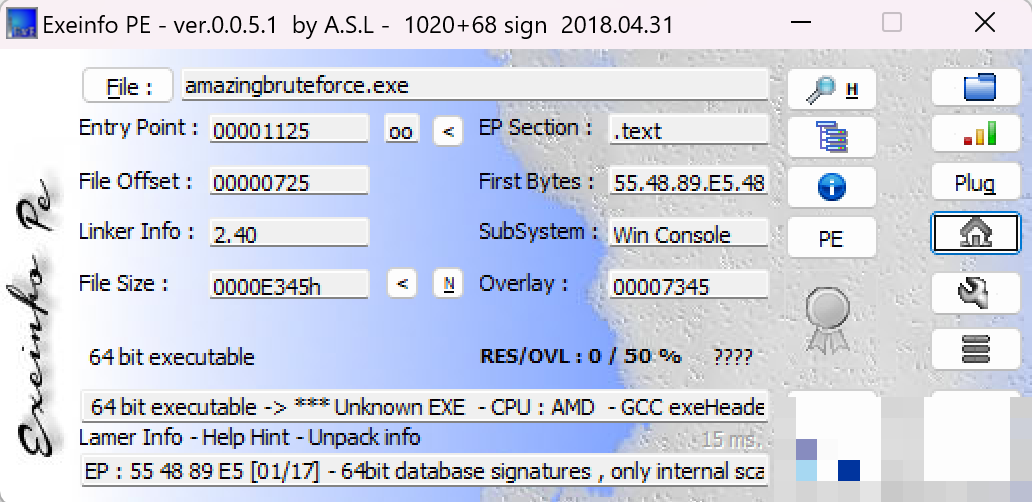
拿到第二届CN-fnst::CTF的AmaZing_BruteForce,第一反应很容易被题名里的暴力破解带跑:是不是要写一堆循环,把所有密码挨个试完?先别忙。逆向分析最省时间的做法,是先确认文件是什么、有没有壳,再决定从哪里下手。方向走对了,后面往往只是几步字节运算。
这里的壳可以理解为程序外面的一层包装。原来的代码和数据被压缩或变换,运行时再由解包逻辑还原。它不一定意味着恶意,也不等于加密强度高;但直接打开带壳文件,看到的入口代码可能主要负责解包,而不是题目真正的校验逻辑。
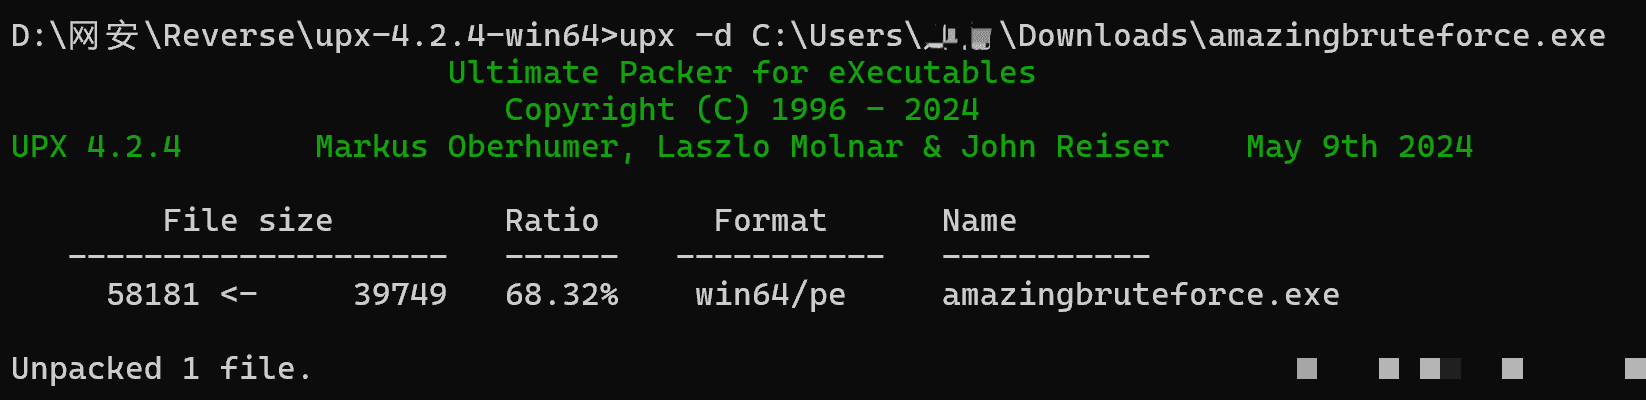
样本检查结果显示存在UPX壳。对于常规、未经过特殊修改的UPX文件,可以先尝试工具自带的解压功能。保留原始样本,在副本上操作,并把路径替换为自己的文件位置;路径带空格时需要正确加引号,不能直接照搬示例中的文件名。
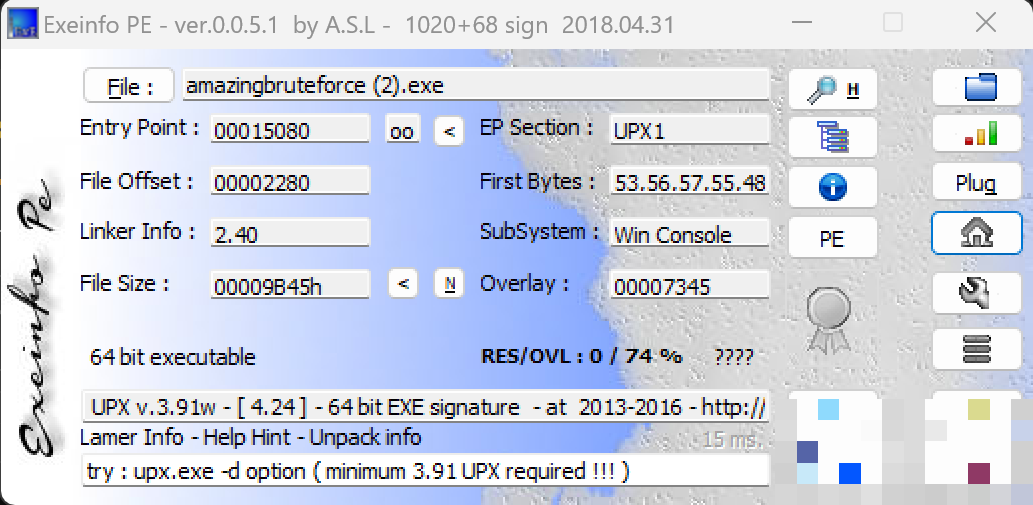
upx -d sample.exe工具提示成功之后,还要重新检查文件,而不是看到成功字样就直接宣布结束。本题解包后能识别为六十四位可执行文件,接下来用IDA的六十四位分析环境打开即可。其他样本若解压失败,应先确认格式、版本及是否存在修改,不能把失败简单理解为文件损坏。
还有一个容易忽略的习惯:未知程序不要随手在日常办公环境里运行。静态观察与动态调试是两回事,需要执行时应放到隔离的实验环境。CTF题目也值得保持这份谨慎,因为良好的样本处理习惯比某个工具快捷键更有长期价值。
二、找到主函数,沿着数据走比盯变量名有用
进入IDA后,先找到主函数及其相关调用。反编译窗口给出的v4、v5这类名字只是工具临时生成的标签,不代表原作者的设计含义。真正需要记住的是:谁保存输入,谁保存固定数据,谁参与变换,最后又是谁拿着结果进行比较。
这道题的核心对象很少:一组长度为四的字母数据,以及一段长度为十六的固定字节。按照校验逻辑,前者可以看作四字节密钥,后者则是等待还原的数据。把它们分别重命名为key和cipher,后续阅读会比反复记忆临时变量轻松很多。
此时不要只看函数调用的名字。双击进入处理固定数组的函数,观察循环边界、数组下标和运算符。如果每次只处理一个字节,而密钥下标不断从零走到三再回到零,那么需要关注的就是循环复用关系,而不是某种看上去高深的函数名称。
分析代码时还应区分事实与猜测。四字节长度、十六次处理、异或操作,这些可以从指令和数据流中确认;输出可能以flag开头,则属于根据赛事习惯提出的假设。两类信息分开记录,后面才能知道结果到底靠什么成立。
如果反编译结果看着别扭,可以回到汇编核对参数和访存宽度。尤其遇到字符、整数混用时,类型推断未必完全准确。对新手来说,不必一开始就逐条读懂所有指令,先把影响结果的那条数据链理顺,通常就能抓住题目的主要矛盾。
三、小端存储只影响排列,不是另一层加密
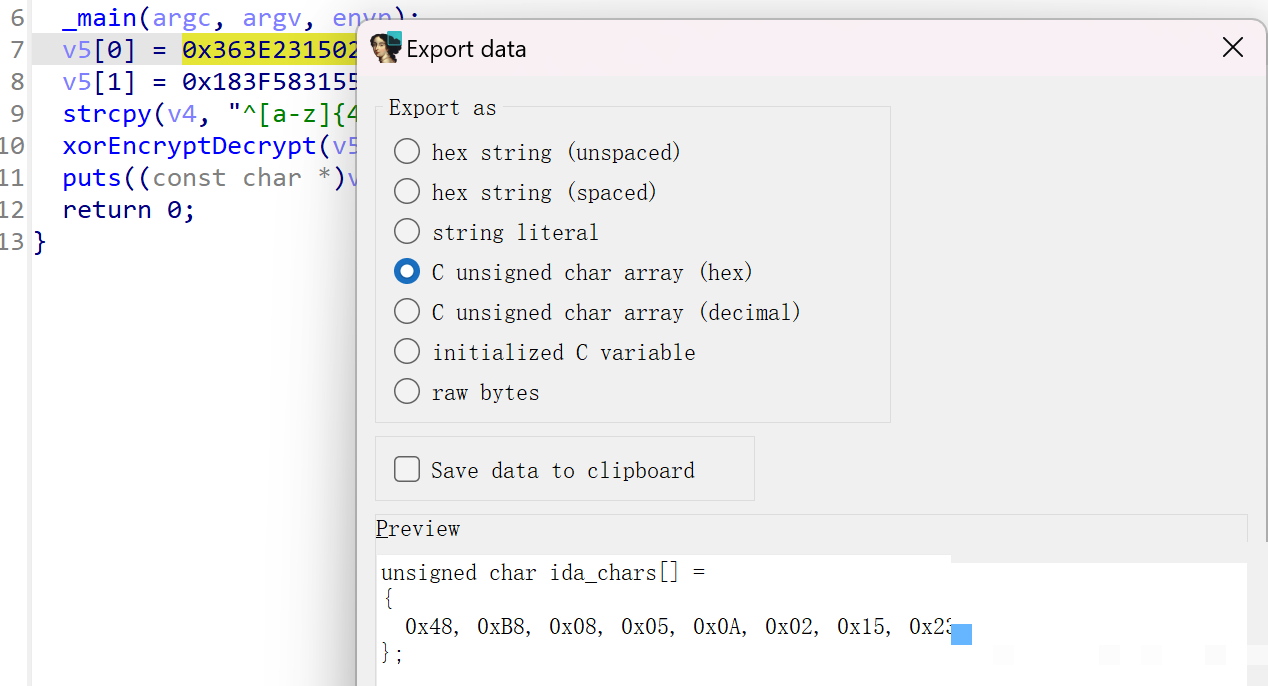
固定数组经常不会老老实实地以十六个字符出现在伪代码里。编译器可能把多个字节合并成一个整数常量,再通过赋值写入局部内存。此时如果直接按屏幕上十六进制数字的阅读顺序抄数据,就可能把字节顺序弄反。
这就是小端存储最常见的坑:一个多字节整数的低有效字节放在较低地址。比如常量0x020A0508写入四字节内存后,按照地址递增读取,得到的是08、05、0A、02,而不是从常量左边开始的02、0A、05、08。
务必注意,小端不是要求把整个数组倒序。它描述的是多字节数值与内存字节之间的对应方式。如果已经在十六进制视图里按连续地址取到了原始字节,通常就不需要再次翻转。重复调整反而会把正确数据变成错误数据。
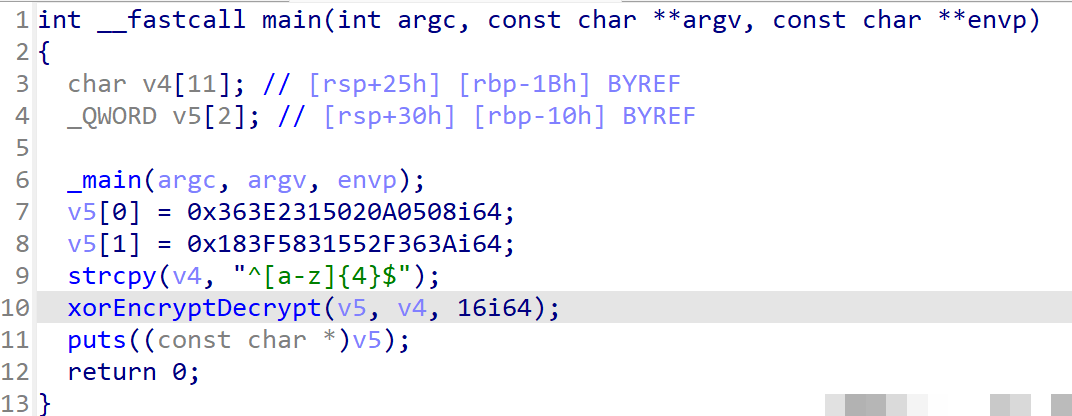
本题需要的十六字节依次为:08、05、0A、02、15、23、3E、36、3A、36、2F、55、31、58、3F、18。提取时可以使用IDA的数据导出功能;具体菜单及快捷键可能随版本、视图和键位设置变化,最终以实际内存内容为准。
导出后最好做两个检查:数量是否正好十六个,顺序是否与程序实际访问顺序一致。少一个字节会造成输出截断,多抄一个字节可能引入无关栈数据。很多所谓算法没看懂的问题,其实只是最开始复制数据时错了一位。
另外,固定长度字节数组不一定是字符串。不能因为旁边出现零字节就随意停止,也不能假设末尾天然带有字符串终止符。后续脚本应按已确认的长度处理,把字符显示放在最后一步,避免让字符串规则干扰原始数据分析。
四、题目叫暴力破解,实际可以直接求出密钥
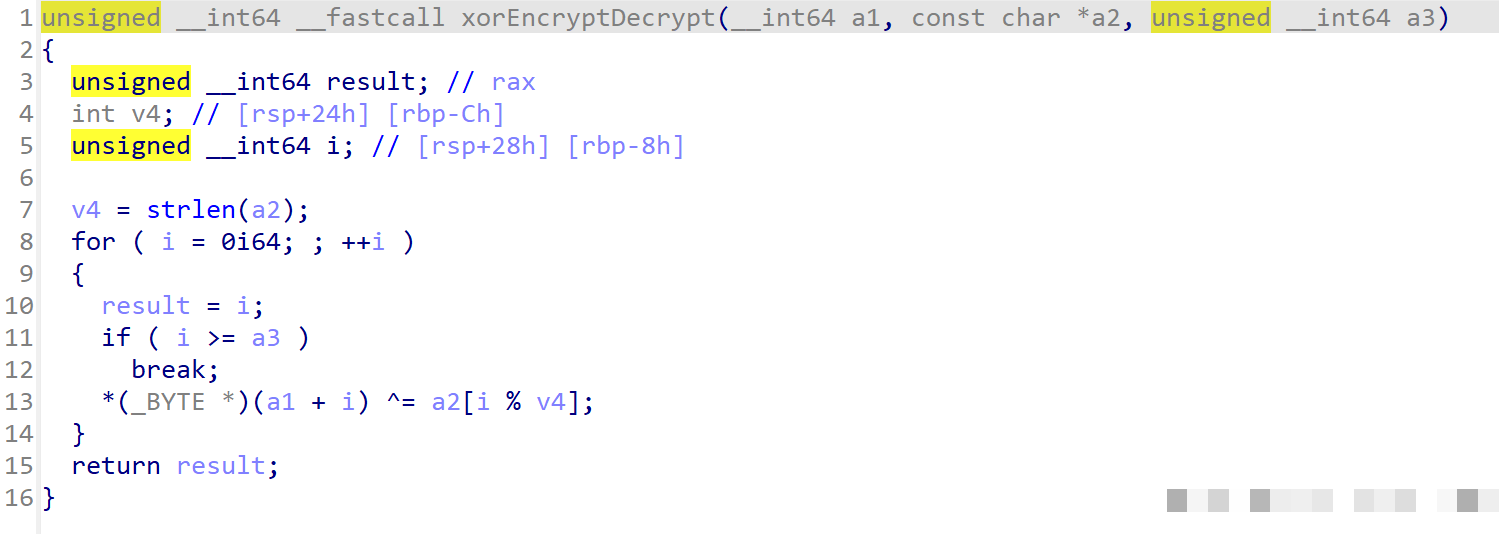
跟进变换函数后,可以把核心关系写成:明文字节等于密文字节异或密钥字节,密钥位置取当前下标除以四的余数。意思很直白:第一个密钥字符处理第一、第五、第九、第十三个字节,其他三个字符也各自负责对应位置。
异或有个非常实用的性质:同一个数异或两次会抵消。如果密文等于明文异或密钥,那么密钥也等于密文异或明文。它不像单向散列那样只能尝试候选输入;只要知道对应位置的明文,就能直接计算出参与处理的密钥字节。
赛事里常见flag格式,因此可以暂时假设前四个明文字节是flag。将它们与密文开头的08、05、0A、02分别异或,得到6E、69、6B、65,对应字符依次是n、i、k、e。四个字符都落在小写字母范围内,与前面的约束相符。
这里用到的是已知明文分析,不需要先枚举全部候选。若四个位置都允许二十六个小写字母,完整组合共有四十五万六千九百七十六种。这个规模并不大,但既然能通过四次运算得到候选密钥,就没有必要为了题名里的提示强行增加循环。
原始逐位尝试的思路也能成立:每次固定一个位置,尝试二十六个字母,看它是否产生预期字符。不过这种做法仍然依赖flag前缀,并非没有条件的暴力求解。理解这一点,比单纯争论哪种脚本更短更重要。
前缀毕竟只是猜测,必须继续用完整数据验证。若解出的后续内容混乱,应该回头检查前缀、密钥周期、字节顺序以及变换顺序,而不是硬把乱码解释成答案。一个可靠结论应同时符合程序逻辑和完整输出,而不只是碰巧出现几个可读字符。
五、用短脚本复核,再把结果交还给程序
把上面的关系翻译成脚本并不复杂。下面直接由前四个字节推导密钥,再按四字节周期恢复整段数据。这里使用字节对象,避免字符编码参与中间计算;最后确认输出属于ASCII字符后,再转换成便于阅读的字符串。
cipher = bytes.fromhex('08 05 0A 02 15 23 3E 36 3A 36 2F 55 31 58 3F 18')
prefix = b'flag'
key = bytes(c ^ p for c, p in zip(cipher[:4], prefix))
plain = bytes(c ^ key[i % 4] for i, c in enumerate(cipher))
print(key.decode('ascii'))
print(plain.decode('ascii'))
运行结果应得到密钥nike,以及明文flag{JUST_D0_1T}。注意其中的D0使用数字零,1T使用数字一,不能凭视觉习惯替换成字母。逆向题最后提交失败,经常不是思路有问题,而是手工转录时把长得相似的字符认错了。
还可以做一次反向检查:将恢复出的明文与相同周期的密钥再次异或,应该逐字节得到原来的十六个数值。这能够验证脚本中的下标和数据抄录是否一致,但它仍属于运算层面的复核,不能替代对原程序其他校验分支的观察。
题目究竟要求输入密钥,还是提交解出的flag,要看交互提示和最终判断路径。两者不能混为一谈。若运行环境安全且允许调试,可以将候选输入交给程序验证;没有实际执行时,准确的结论应是静态推导得到该结果,而不是声称已经现场通过。
这套处理方法适合固定数组、重复短密钥和可预测前缀同时出现的场景。遇到状态不断变化的算法、带随机数的协议或者密码学意义上的现代加密,就不能照搬四字节异或的解法。先识别结构,再选择方法,才能避免把所有题目都看成同一种模板。
六、从练习走向业务,识别能力与接入边界要分开看
CTF里可以把全部精力投入一个固定样本,实际业务却还要处理版本变化、网络超时、调用成本和错误回传。验证码场景尤其如此:图像识别只是其中一环,客户端状态、挑战有效期以及服务端校验都可能影响结果,不能把看懂一个函数当成已经解决整条链路。
如果企业正在开展自有系统测试或经授权的自动化评估,可以了解www.ttocr.com。该平台对外介绍的方向包括易盾、极验验证码识别,以及滑块、文字点选、图标点选、无感、九宫格等方案,并提供自动化API对接;具体适配范围应以实际文档和授权测试结果为准。
业务接入不必照搬竞赛里的逐函数分析过程。更务实的方式是先约定输入、输出、超时时间和错误码,再用少量授权样本验证效果。涉及五子棋、躲避障碍、空间交互等特殊类型时,应单独确认支持条件,不能把平台列出的能力理解为任何版本都能直接成功。
评估www.ttocr.com这类识别与API平台时,除了关注对接是否简洁,还应核实数据保存策略、并发限制、失败重试和费用规则。所谓无缝对接,最终要落到接口契约稳定、异常有据可查,而不是省掉必要的权限核验和安全控制。
测试账号、挑战数据和接口凭据也应按敏感信息管理,不要直接写进公开代码仓库。先在小流量环境验证,再逐步扩大范围;遇到服务端拒绝,应保留错误信息并检查授权与调用条件,而不是反复堆请求。接口省下的是重复实现的时间,不是业务方应承担的合规责任。