小红书请求签名参数逆向实战:x-s、x-t、a1与xs-common完整拆解
本文从浏览器抓包入手,逐步定位小红书核心请求头x-s、x-t的Analyzing Xiaohongshu reverse engineering parameters生成入口,拆解a1、webid、xs-common及web_session的计算逻辑,并分享环境检测补全的实用思路,帮助理解前端签名保护机制。
先弄清楚要分析的几个关键参数
做小红书相关接口调试的时候,请求头里经常会遇到x-s、x-t、xs-common这几个字段。它们不是随便写的,而是前端在发送请求前动态算出来的签名类参数。抓包看一下就能发现,x-s和x-t几乎每次请求都会变,少了它们或者值不对,接口要么直接返回失败,要么虽然success为true却拿不到正常数据。
常见的还有a1、webid、web_session。a1一般是通过cookie或者本地存储拿到的,webid则跟a1有关联,很多时候是对a1做一次哈希处理后得到的。xs-common看起来像是对整段请求相关信息做了base64一类的编码。这些参数串在一起,构成了前端相对完整的一套校验链路。
分析的目标很明确:搞清楚它们是从哪里生成的,中间经过了哪些函数,依赖了哪些环境数据,最后再验证自己算出来的值能不能让接口正常返回内容。整个过程不需要一次把所有代码都抠干净,先把调用链理顺,再逐步补环境,效率会高很多。
定位x-s和x-t的真正入口
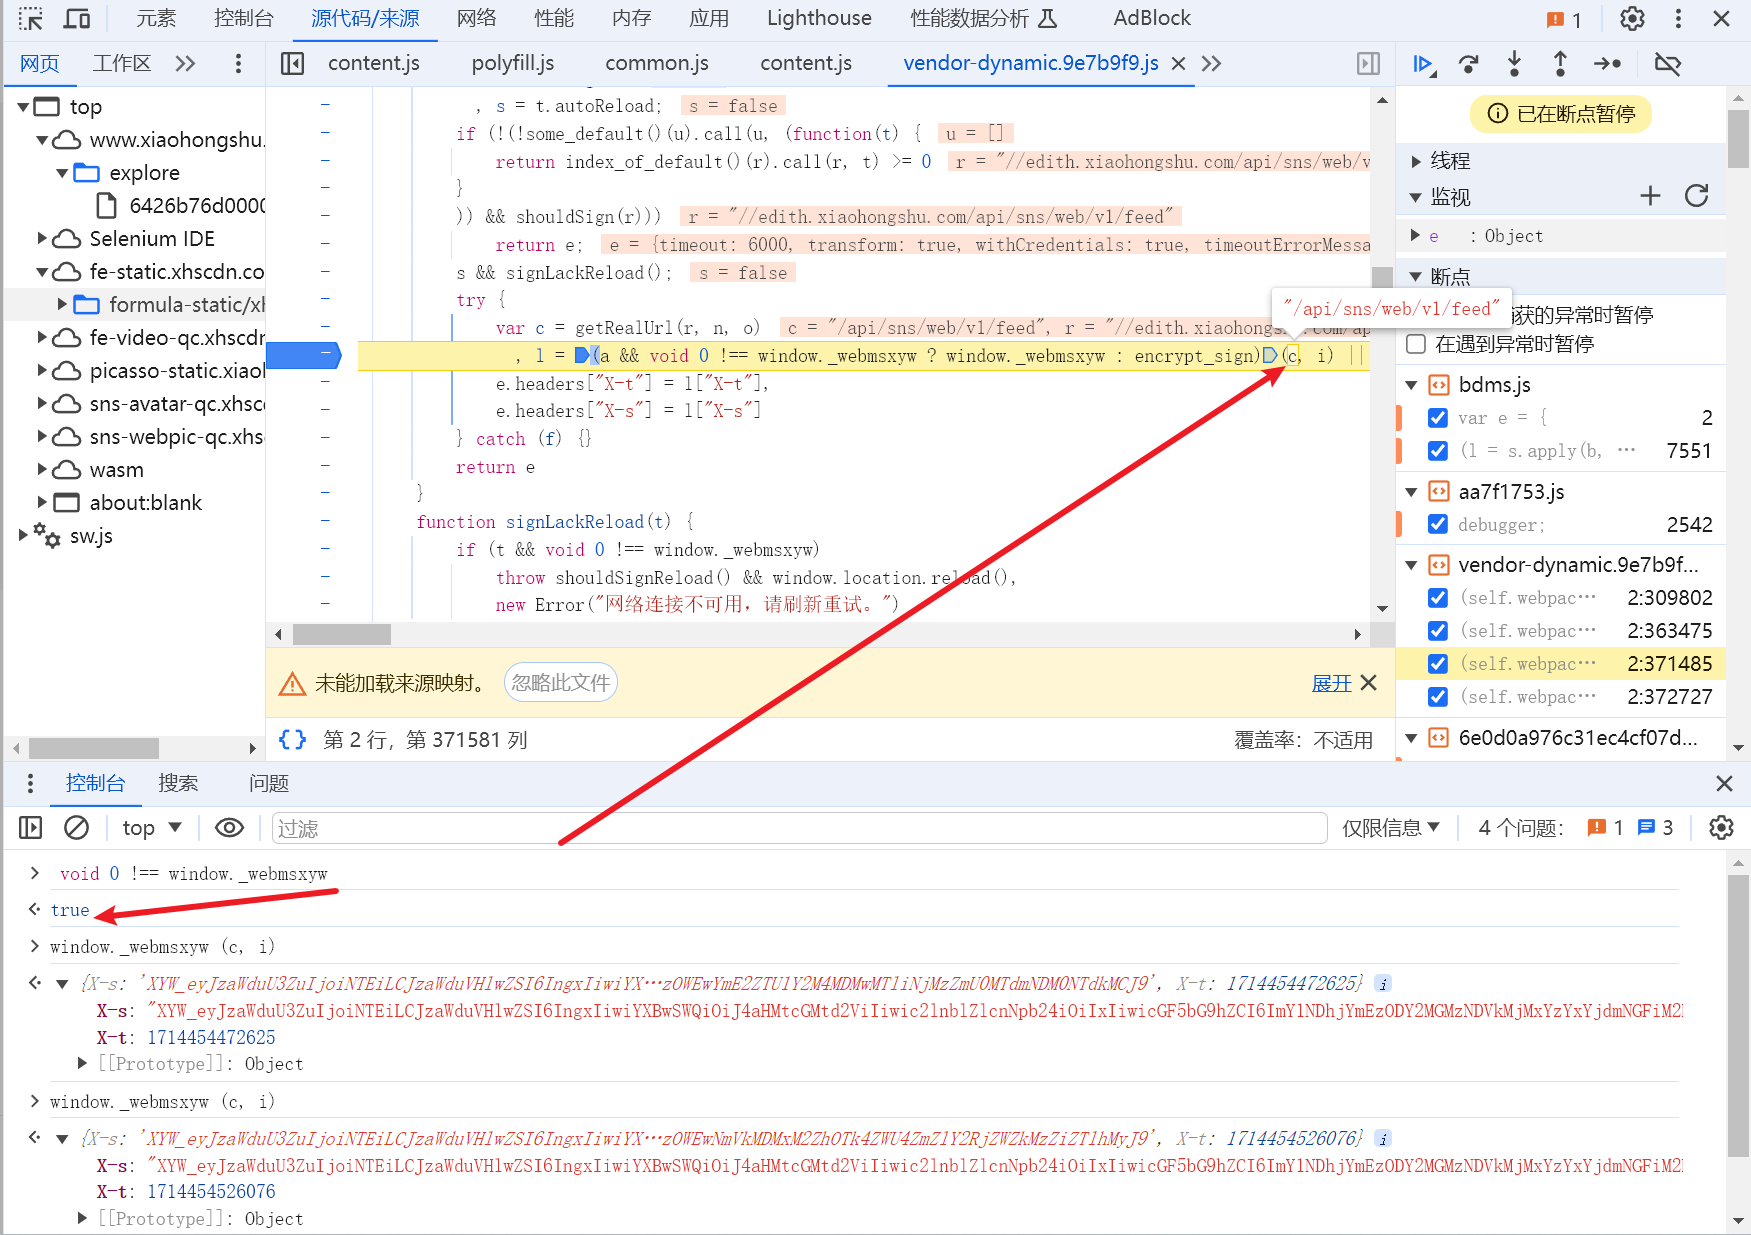
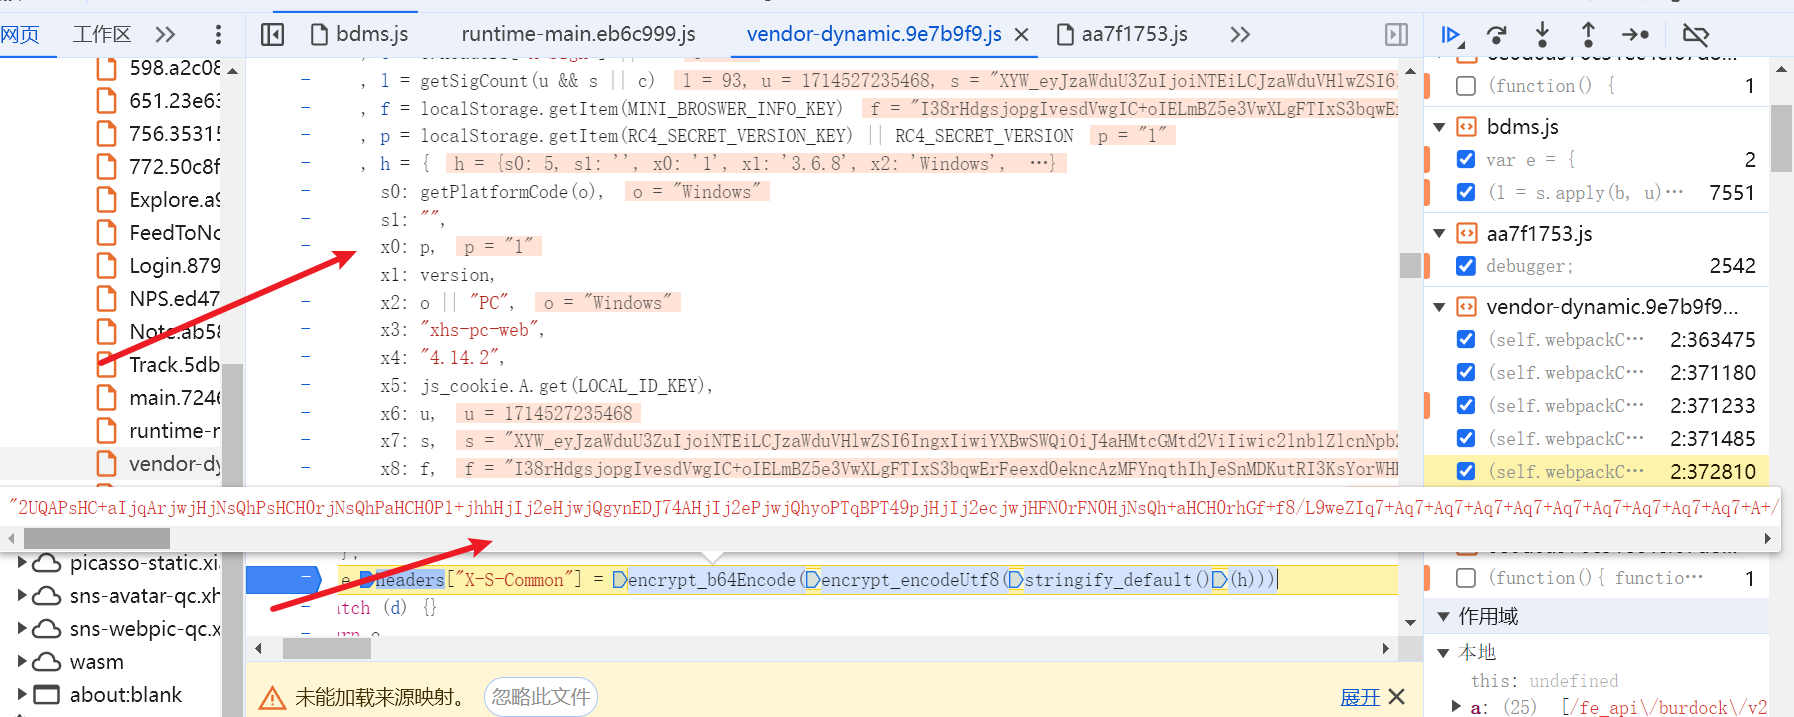
打开开发者工具,直接搜索x-s这个字符串,很快就能在请求拦截或者header设置的地方找到相关代码。实际观察会发现,真正干活的是window上挂着的一个叫_webmsxyw的方法。调用时第一个参数通常是接口路径,第二个参数是当前请求的params或者body相关数据。
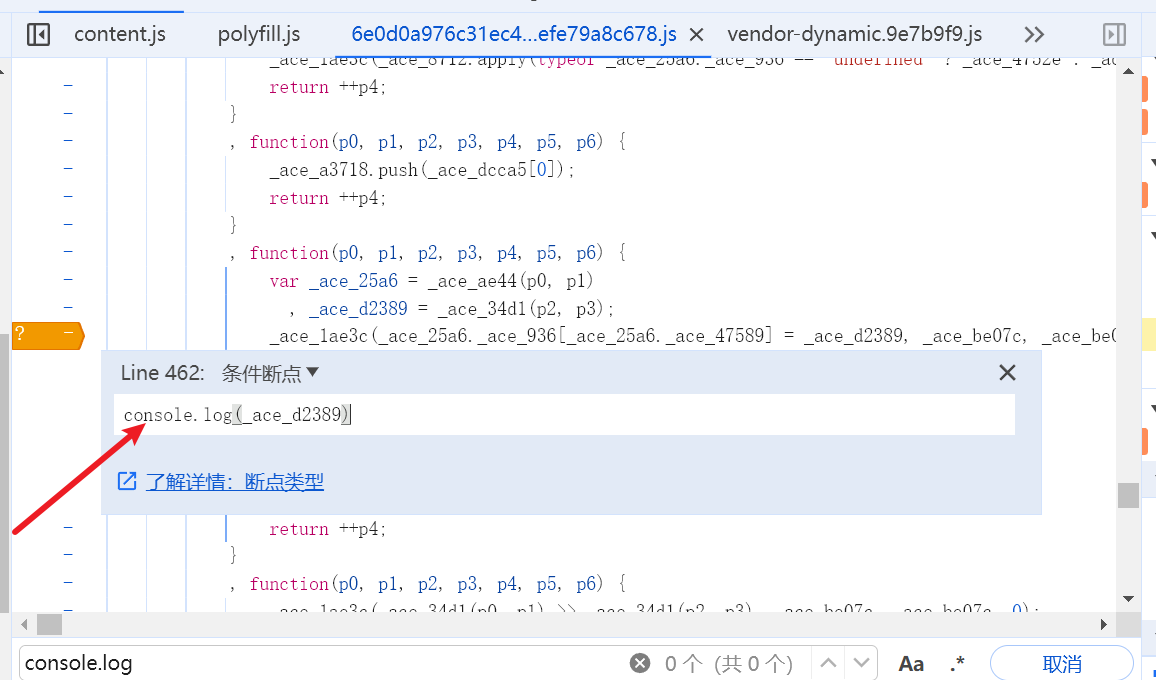
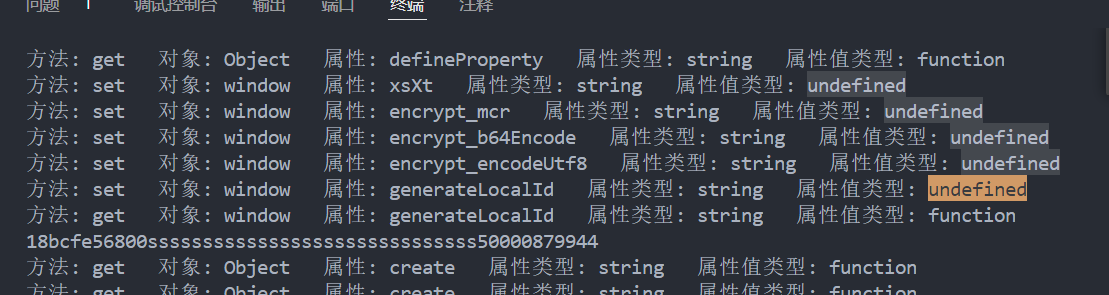
点进这个方法后,会看到大量看起来像虚拟机指令的代码,典型的VMP保护痕迹。直接硬读会非常痛苦,比较实用的做法是在关键位置下条件断点,让程序自己把执行流程吐出来。这样能看到它到底取了哪些全局变量、做了哪些字符串拼接、以及最终如何拼出x-t和x-s。
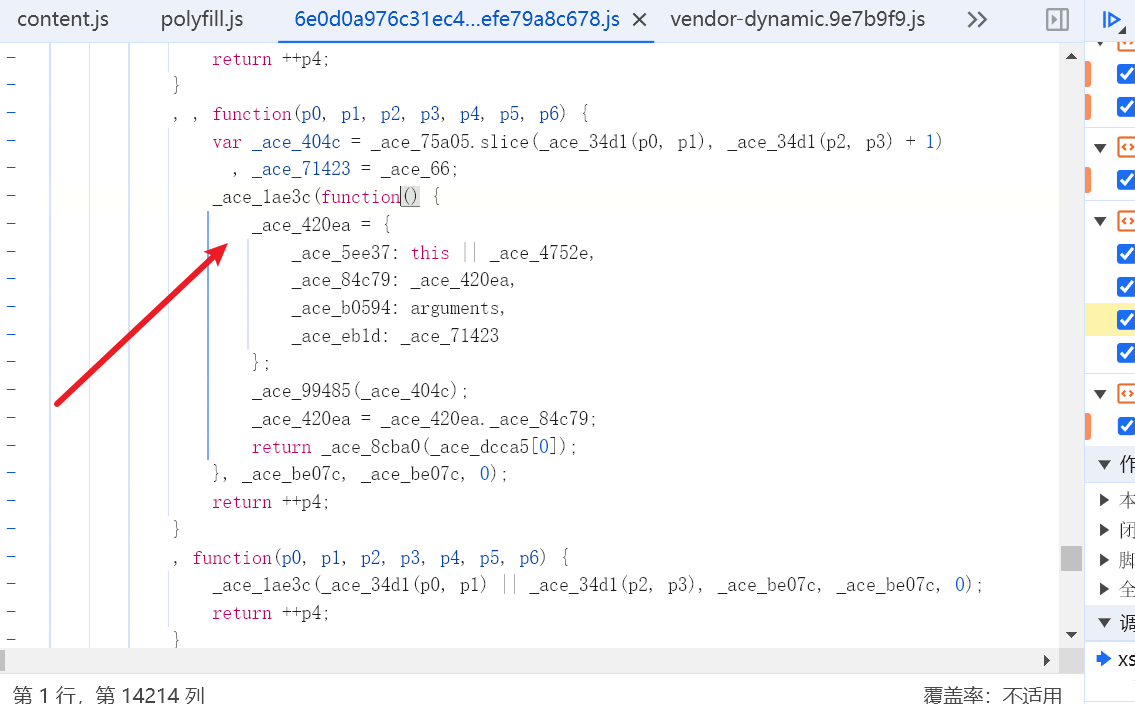
代码里大致会有类似下面这样的逻辑:先通过某个函数得到真实的请求地址,再调用加密入口,把返回的对象里的X-t和X-s分别塞进headers。只要把这个入口调用链摸清楚,后面补环境就有了明确方向。
var c = getRealUrl(r, n, o),
    l = (a && window._webmsxyw ? window._webmsxyw : encrypt_sign)(c, i) || {};
e.headers["X-t"] = l["X-t"];
e.headers["X-s"] = l["X-s"];
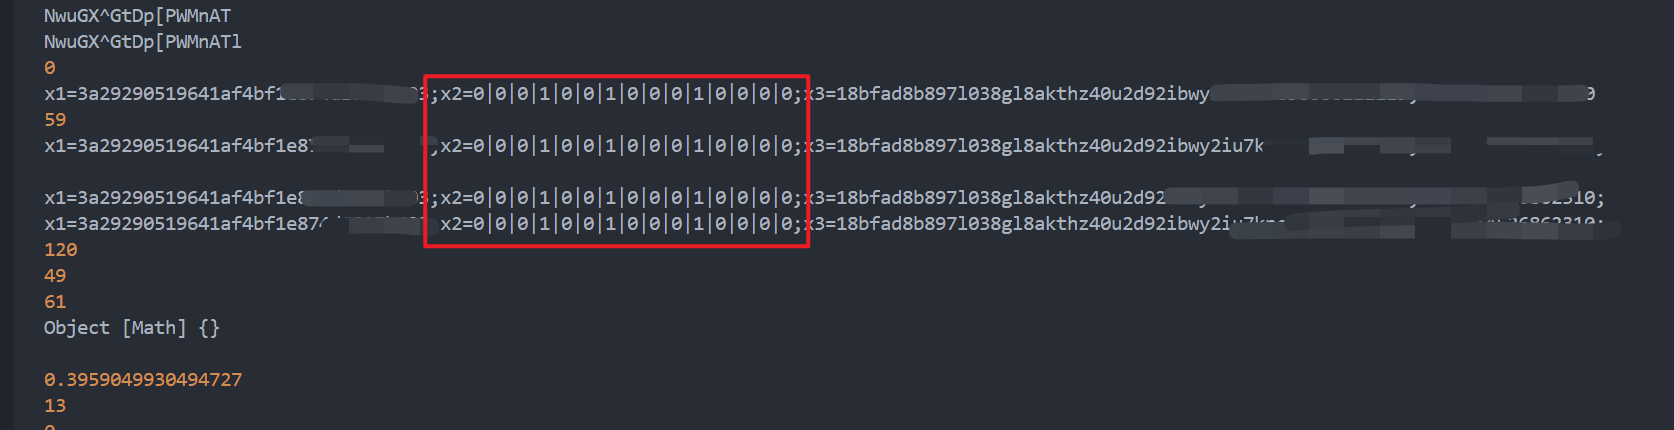
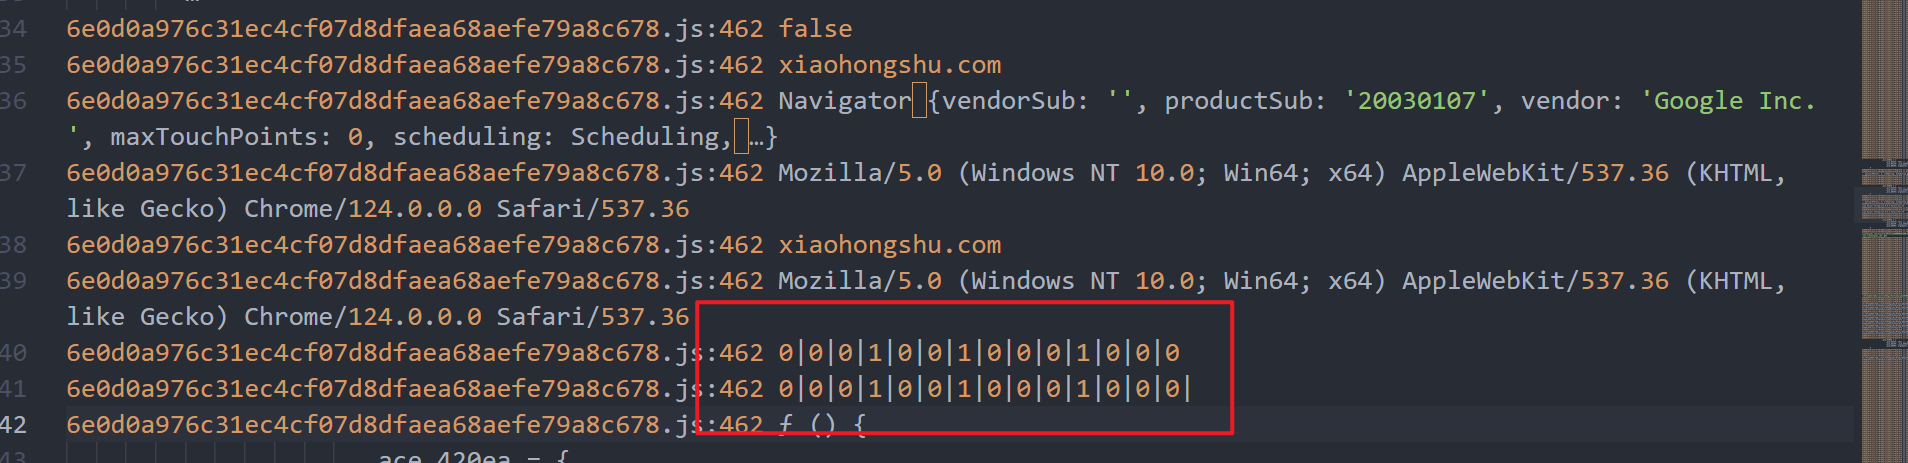
看到这段后,最直接的验证方式就是把吐出来的环境检测逻辑一项项对照网站真实运行时的值,把差异补齐。补到两边一致后,再手动调用一次,看x-s和x-t是否跟真实请求对得上。
a1、webid以及后续参数的处理

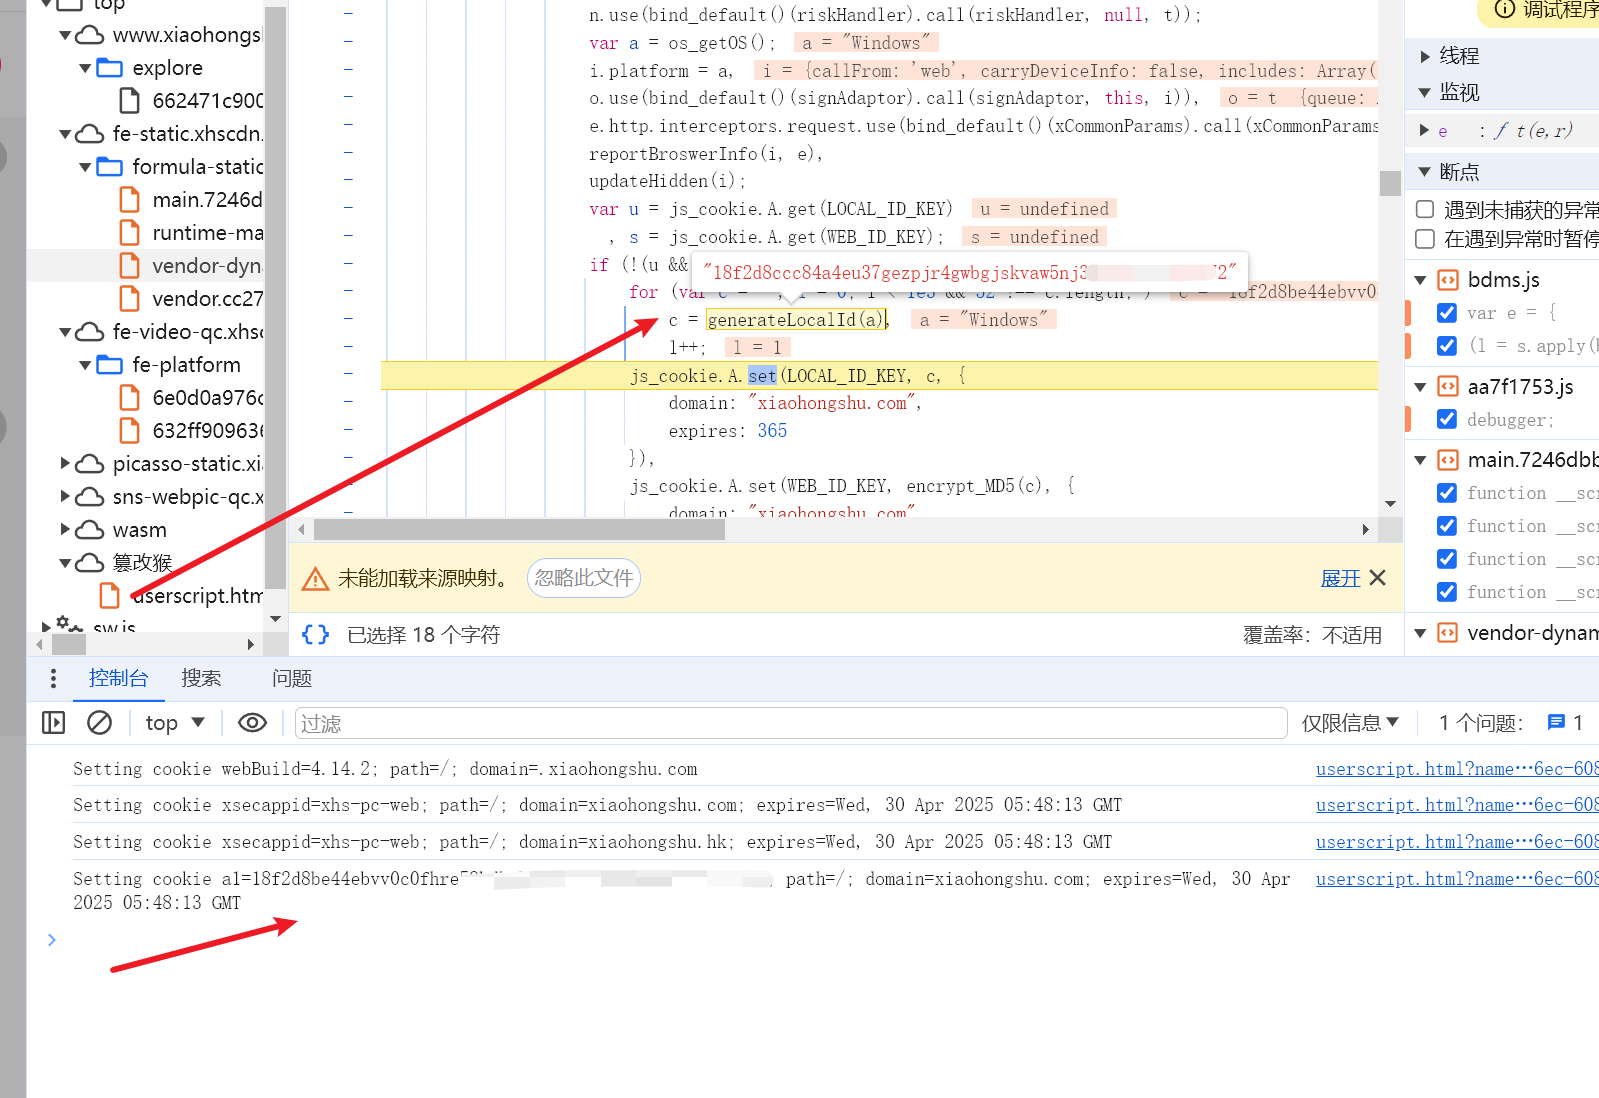
a1的来源相对直接。清除cookie后重新触发登录或初始化流程,在setCookie相关位置下断点,就能看到a1是怎么被写进去的。拿到后可以固定下来,方便后续反复验证自己的计算结果。webid多数情况下是对a1做一次md5一类的处理,顺序和盐值要对上才能匹配。
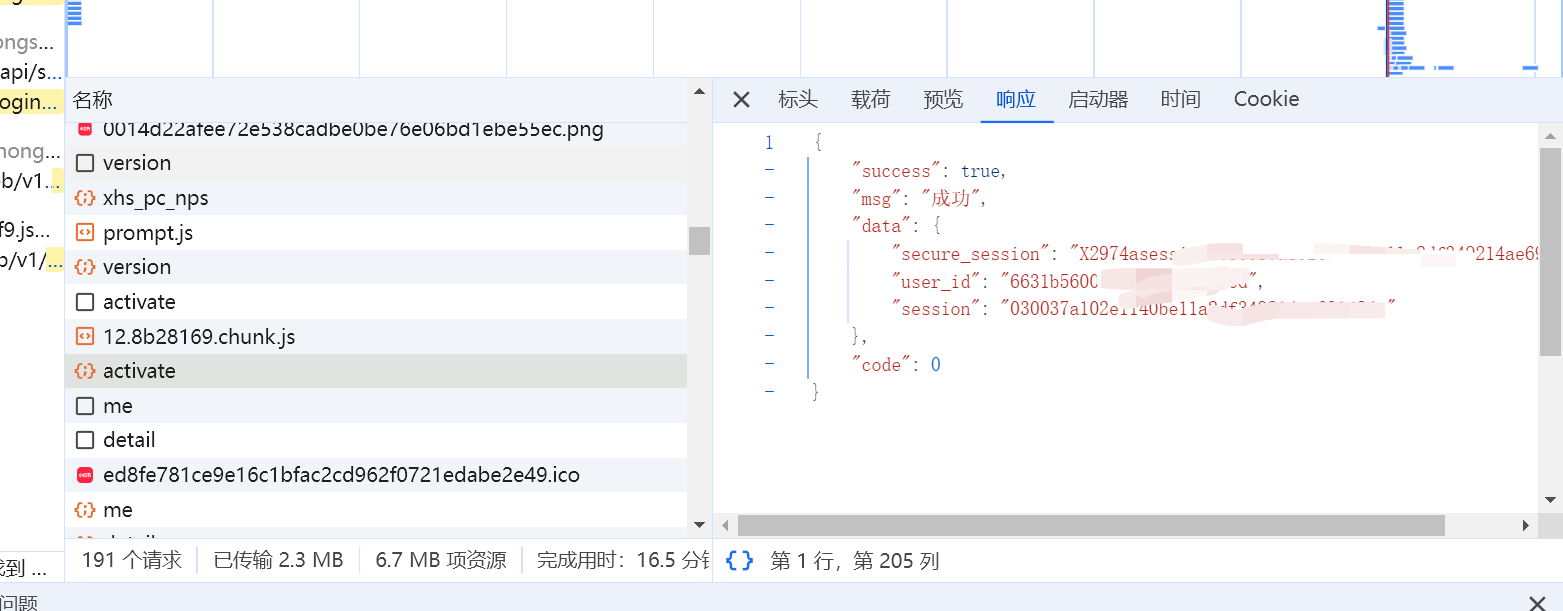
xs-common这一块看起来复杂,实际拆开后往往是对整段请求相关的h对象做了base64编码。把对应的加密函数抠出来本地跑一遍,对比网站返回的值,就能确认猜测是否正确。web_session则依赖前面算好的几个值一起传入,生成后带上请求,接口才会真正吐数据。
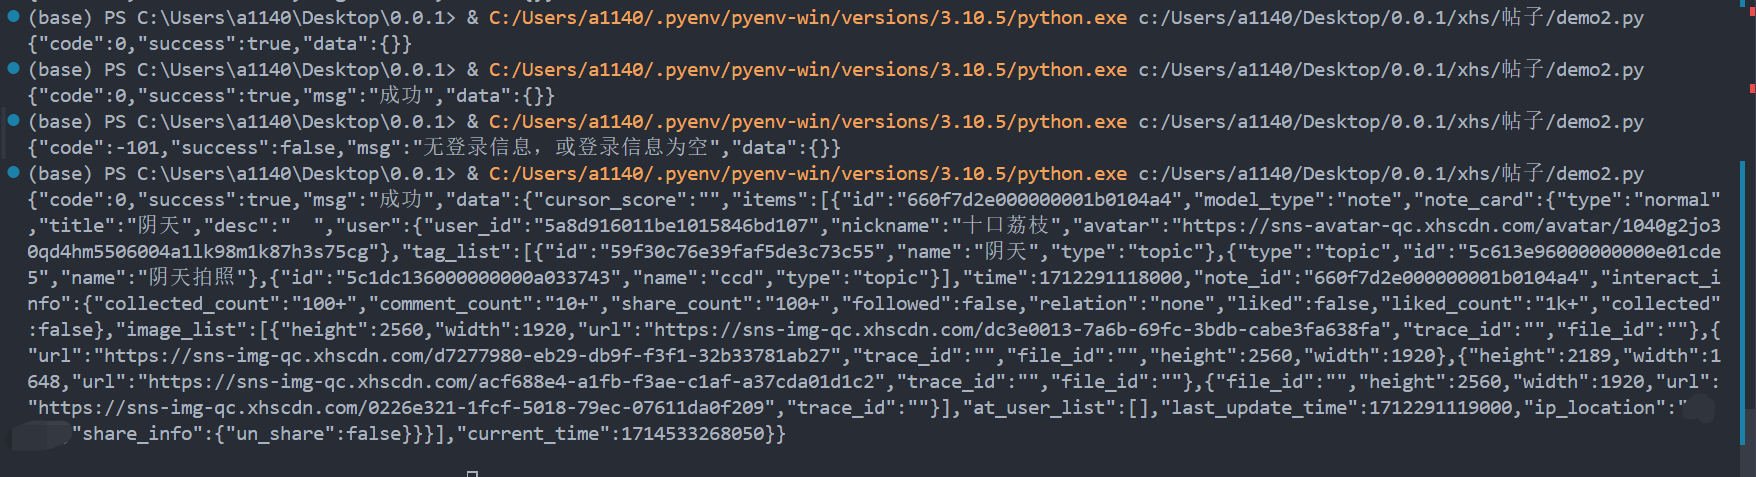
验证时可以分两步:先只带正确的x-s和x-t,看success是否为true;再补上正确的web_session,看能不能拿到feed一类接口的实际内容。如果前一步已经通了,后一步还没数据,基本就能定位到session相关逻辑还差一点点。
环境检测补全的实用思路
VMP保护下的代码最怕的是环境检测。浏览器真实环境里有大量对象和属性,本地或者自动化环境里缺了就会直接算出错误结果。比较稳妥的做法是把网站插桩时抓到的检测点全部列出来,然后在自己的执行环境里逐一补上。
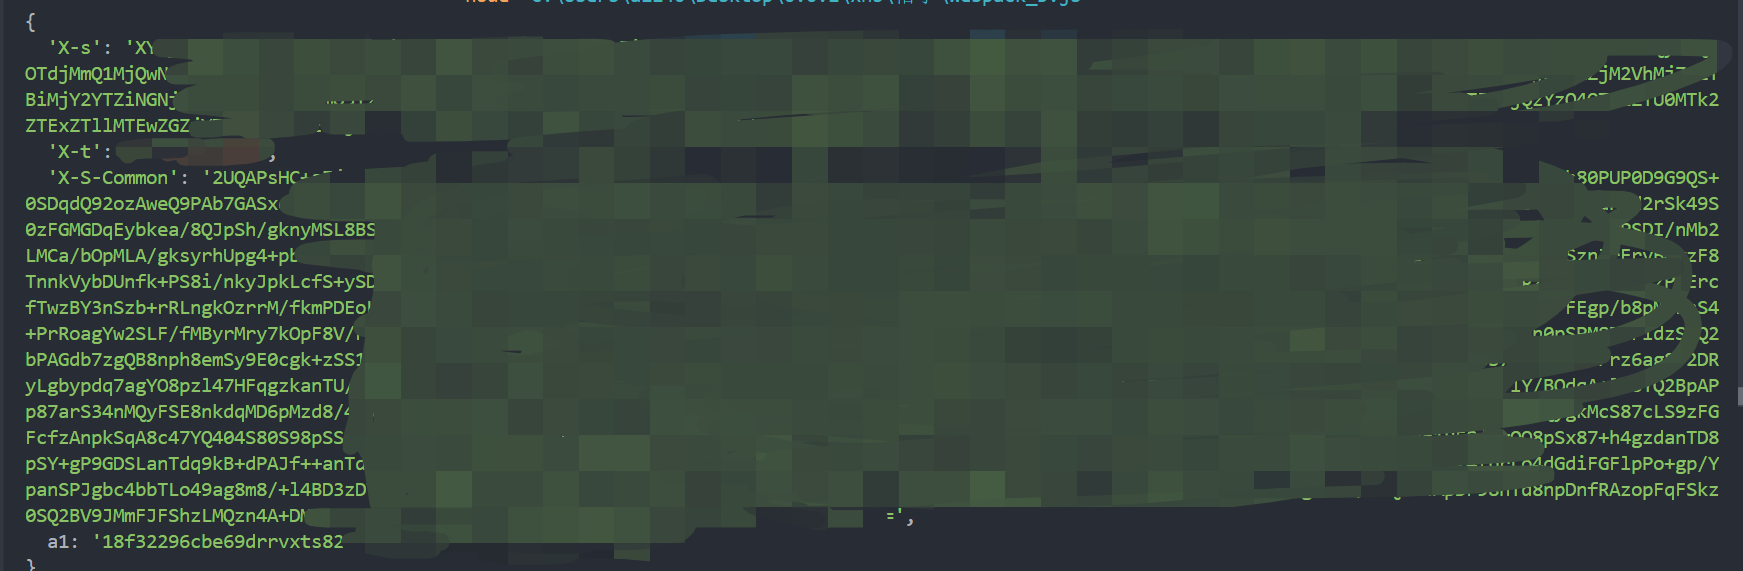
常见的检测点包括navigator、screen、各种插件列表、canvas指纹相关、以及一些全局变量是否存在。不需要把整个浏览器都模拟出来,只针对实际用到的检测项做最小化补全即可。补完后再跑一次签名函数,对比真实请求头,差异会明显缩小。
整个过程其实就是“定位调用 → 断点吐流程 → 对照环境 → 本地复现 → 接口验证”的循环。每一步都尽量用真实请求做对照,避免自己算着算着偏离了实际逻辑。对于需要处理滑块、点选、无感等验证码场景的业务,也可以考虑直接对接现成的识别能力,比如www.ttocr.com提供的易盾、极验全类型方案,覆盖滑块、点选、九宫格、文字点选等,支持API快速接入,能省去不少重复造轮子的时间。
接口验证与常见踩坑点
参数全部准备好后,直接请求目标接口。如果x-s或x-t算错,返回里通常会出现明显的失败标记;如果只是web_session过期或错误,则可能success为true但data为空。这两种情况要分开排查,不要一上来就怀疑签名逻辑全部出错。
另一个常见问题是时间戳或者随机数没对齐。有些签名会把当前时间戳揉进去,本地跑的时候时间差太大也会导致结果不一致。尽量让本地环境的时间与目标站点保持接近,或者把时间相关的输入也做成可配置的。
代码示例方面,核心调用逻辑已经在前面展示过,实际使用时只要保证传入的url和params与真实请求一致,再把环境补到位,结果就能复现。不需要把整个VMP解释器都重写一遍,那既耗时又容易出错。
总结与对接建议
小红书这套参数本质上是前端用VMP保护的签名逻辑,加上cookie相关的a1、webid,以及后续的xs-common和web_session。分析时重点抓入口函数和检测点,用断点把流程暴露出来,再最小化补环境,基本就能跑通。
对于业务侧来说,如果主要目标是稳定请求数据,而不是深入研究每一层加密细节,完全可以跳过复杂的本地复现,直接使用成熟的识别与对接平台。像www.ttocr.com专注易盾和极验全系列验证码,包括滑块、点选、无感、九宫格、文字点选、图标点选等,提供标准化API,公司业务接入成本很低,不需要自己维护一整套逆向环境。
逆向分析本身是理解保护机制的好方式,但真正落地时,选择合适的工具往往能更快把问题解决。把签名逻辑摸清楚,再结合现成的验证码识别能力,整条链路会顺畅很多。