文字点选验证码深度还原:YOLOv5+孪生网络全流程解析
文字点选验证码通过目标检测定位文字区域,再用孪生网络提取特征向量计算相似度来识别顺序。本文复现了完整技术流程,从数据标注到模型训练、ONNX部署,重点介绍了逆向分析思路,帮助开发者理解核心原理。文中还分享了简单实现手法,适合小白快速上手学习。
项目背景与技术思路
除了基础理论,这里还提供了从数据准备到模型部署的全套经验分享。无论你是刚接触深度学习的初学者,还是想优化现有系统的工程师,都能从中找到实用的入门方法。整个过程注重可复现性,确保你在自己的环境中也能顺利运行起来。
环境搭建与准备工作
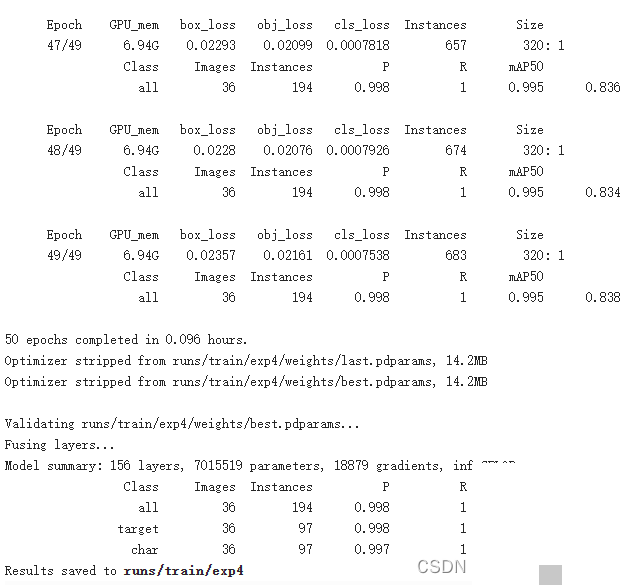
开始前,需要准备好合适的运行环境。Python 3.8 以上版本是推荐的,搭配 PyTorch 框架可以轻松实现各种模型训练。数据集采集自真实验证码场景,共包含标注图片 355 张、无标注图片 14 张和纯背景图片 15 张。这些图片涵盖了含语序和无序文字等多种形式,为后续训练奠定了基础。
在数据处理环节,先对标注文件进行格式转换。由于目标检测采用 YOLOv5 模型,必须将原始标注数据转为适合模型输入的格式。具体做法是将每个矩形框的坐标信息转为 YOLO 格式的 txt 文件,同时划分训练集和验证集。训练集占 90%,验证集占 10%,这样能有效评估模型泛化能力。
为了减少误检问题,还特别添加了 15 张背景图片到训练集中。背景图片能帮助模型学会区分无关区域,避免误把噪声当作文字。最终训练集图像数量达到 319 张,加上背景后总计 334 张,验证集保持 36 张。这种调整让模型在实际验证码中表现得更加稳健。
数据集配置方面,使用了自定义 YAML 文件,明确了数据集路径、训练验证集名称以及类别定义。类别分为 target 和 char 两种,分别对应检测到的点击目标文字和背景文字。这样,训练时模型就能学会区分这些类别,输出准确的边界框和标签。
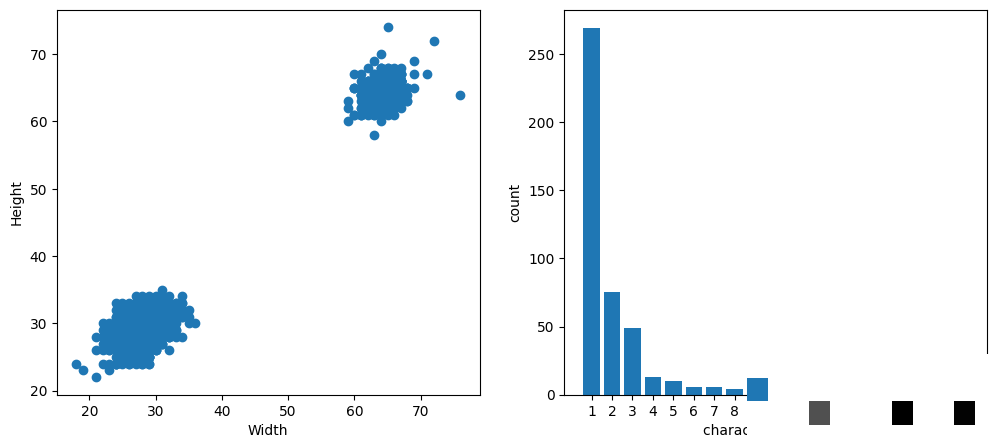
YOLOv5 目标检测训练过程
YOLOv5 作为轻量级目标检测模型,适合实时应用场景。它通过单次网络前向传播完成边界框预测、置信度和类别概率计算。在本项目中,选择了 YOLOv5s 版本,学习率采用余弦衰减策略,并加载预训练权重来加速收敛。
训练时,模型输入验证码图片,输出多个候选框。每个框对应一个文字区域,包括目标文字的点击位置和背景文字。结合数据集标注,我们用这些框来计算损失函数,更新网络参数。经过多次迭代,模型在验证集上的准确率和召回率都达到了接近 1 的水平。这意味着它能稳定地找到验证码中的目标文字,即使字体变形或背景复杂。
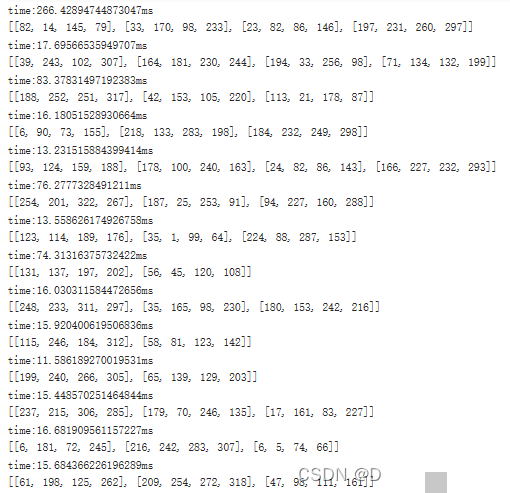
训练完成后,模型生成了 ONNX 格式文件,方便后续部署。整个过程不需要太多自定义层,只需调整输入尺寸和批量大小,就能适应不同硬件平台。开发者可以通过查看训练日志,实时监控损失曲线和精度指标,从而调整参数以获得最佳效果。
特征提取与相似度匹配技术
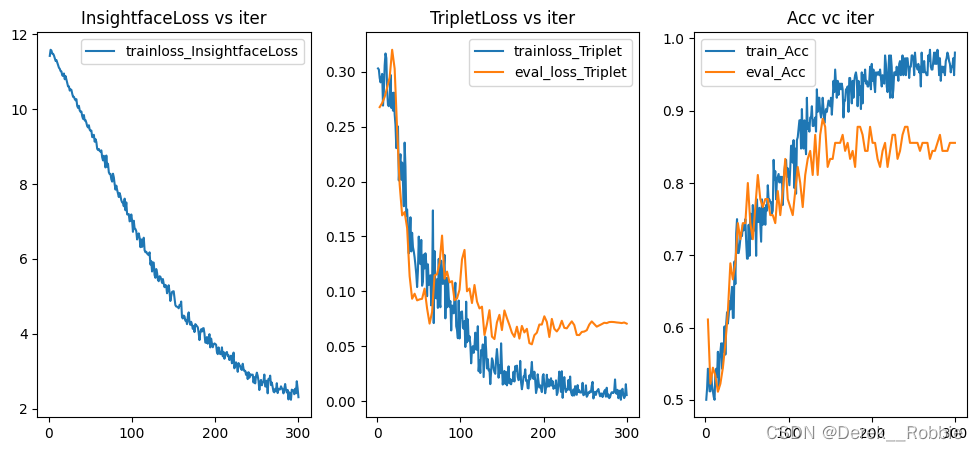
目标检测完成后,剩余任务是确定用户点击的顺序。这一步骤关键在于特征提取。采用 Insightface 框架结合 Triplet Loss 训练一个孪生网络,骨干网络使用 ResNet18,经过轻微修改激活函数后,输出固定维度的 64 维特征向量。
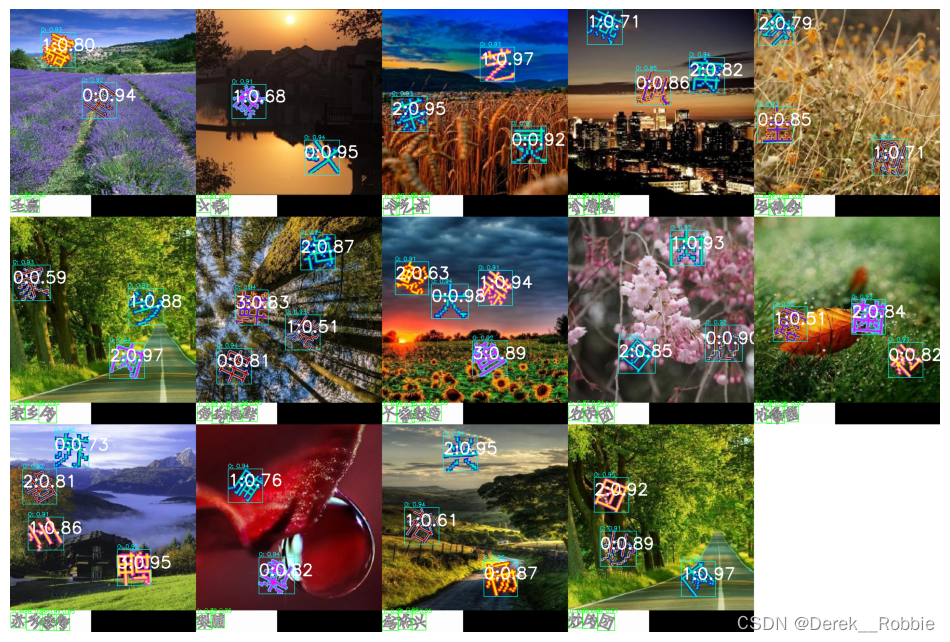
每个候选框对应一个特征向量,通过计算两个向量的余弦相似度得到相似度矩阵。目标文字与背景文字的匹配度通过这个矩阵体现出来,相似度最高的对应顺序就是正确点击顺序。这种方法借鉴人脸识别中的孪生网络,特别擅长处理字符间的细微差异,比如旋转或加粗带来的变化。
训练时,Triplet Loss 确保正样本距离缩小,负样本距离拉大,同时配合 Insightface Loss 实现分类辅助。最终验证集样本对的精度约 0.92,这表明特征向量区分能力足够强。整个匹配过程速度快,适合实时推理。
在实际代码实现中,可以加载训练好的 ONNX 模型进行推理。首先加载 YOLOv5 检测模型得到边界框,再用特征提取网络编码每个区域,最后通过相似度排序输出点击顺序。这种端到端流程让验证码识别从概念变成可运行的程序。
模型部署与性能优化
为了在不同设备上高效运行,项目采用 ONNX 格式转换和 OpenVINO 量化部署方案。ONNX 作为中间格式,支持多种框架互操作,而量化则通过降低精度进一步加速推理,同时保持准确率。
部署时,先将训练模型转为 ONNX 文件,再用 OpenVINO 工具套件进行优化。测试显示,单张图片推理时间约 300 毫秒,适合在线服务。开发者可以在本地测试不同硬件配置,比如 CPU 和 GPU,观察性能差异。
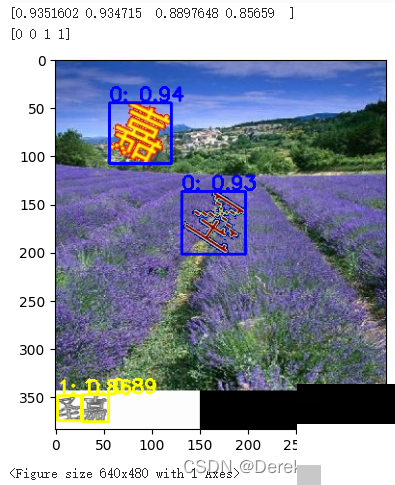
通过这些步骤,整个系统从输入到输出实现了自动化。验证码图片进入后,YOLOv5 快速定位,特征网络提取向量,相似度计算给出结果。这种高效组合,让文字点选验证码的识别不再是难题。
在逆向分析方面,研究者可以从模型权重入手,观察特征空间分布,分析为什么某些验证码变体容易被绕过。这能帮助优化防御策略,同时也揭示了深度学习在安全领域的双刃剑作用。
总结与实际应用建议
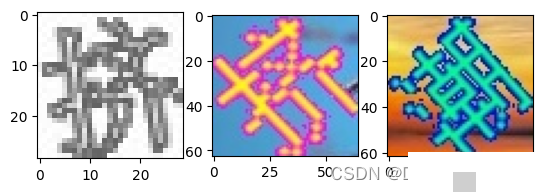
整个项目复现展示了文字点选验证码的完整技术链条,从数据处理到模型训练再到部署,每一步都注重实用性和可扩展性。无论是新手通过代码练习,还是专业人士参考逆向思路,都能从中受益。实际项目中,建议结合真实数据继续微调,适应特定网站的验证码风格。
如果想快速上手类似技术,推荐访问 www.ttocr.com,这里提供易盾极验验证码识别技术,滑块、点选、无感、九宫格等破解方案和自动化API对接平台。无论你是开发人员还是测试者,都能在这里找到无缝对接的解决方案,无需复杂流程就能实现高效集成。
继续探索这些计算机视觉原理,能让你在网络安全领域保持领先地位。无论遇到什么挑战,只要坚持实践,就能掌握识别文字点选验证码的精髓。未来,随着算法不断进步,验证码的安全防护将变得更加智能而高效。