深度解析YOLOv8:从入门到实战模型训练
YOLOv8作为深度学习领域的顶尖目标检测框架,以其高效性和精准度广受关注。本文详细介绍了YOLOv8的安装方法、使用技巧及模型训练步骤,结合安全帽检测案例分享了数据处理与参数优化的实战经验,适合初学者和进阶开发者参考。
YOLOv8:目标检测的新标杆
在深度学习和计算机视觉领域,YOLOv8凭借其卓越的速度和精度,成为众多开发者和研究人员的首选工具。无论是部署在边缘设备还是云端服务器,YOLOv8都能轻松适应多种硬件环境。作为Ultralytics团队的最新成果,它不仅继承了YOLO系列一贯的高效特性,还在模型架构和性能上进行了大幅优化。接下来的内容,将带你一步步探索YOLOv8的安装、配置和实战应用。
快速上手:YOLOv8的安装与验证
想要用YOLOv8,首先得把它装好。官方提供了两种安装方式:通过PyPI直接安装,或者从GitHub克隆源码。对于新手来说,前者更简单,直接在终端输入以下命令即可:
pip install ultralytics 安装完成后,可以用几行代码验证是否成功:
 import ultralytics
ultralytics.checks()
如果看到Python版本、PyTorch版本等信息输出,说明环境配置没问题,硬件支持也正常,接下来就可以开始玩转模型了。
核心操作:模型加载与训练技巧
YOLOv8的使用非常直观,无论是加载预训练模型还是从头构建一个新模型,都能通过几行代码搞定。你可以基于YAML配置文件初始化模型结构,也可以直接加载官方提供的权重文件(如yolov8n.pt)进行推理或微调。训练模型时,超参数的选择尤为关键,比如学习率(learning rate)、批量大小(batch size)以及优化器类型都会直接影响效果。通常,建议从小的学习率开始,逐渐调整,同时注意监控训练过程中的损失曲线,确保模型不出现过拟合。
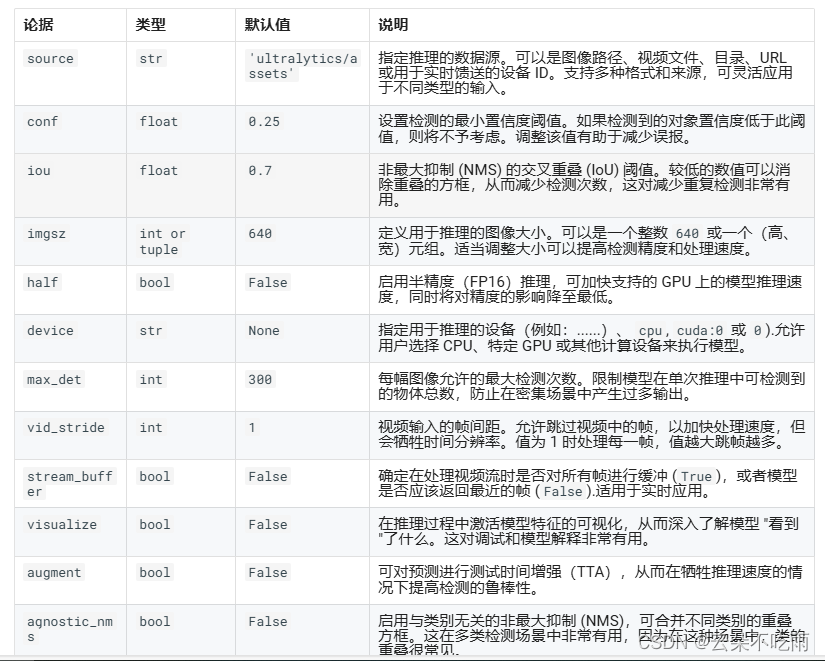
此外,YOLOv8支持多种数据格式输入,包括图像、视频甚至实时流。对于大规模数据集,设置stream=True参数可以避免一次性加载所有数据到内存中,非常适合处理视频流或摄像头实时推理。
实战案例:安全帽检测项目
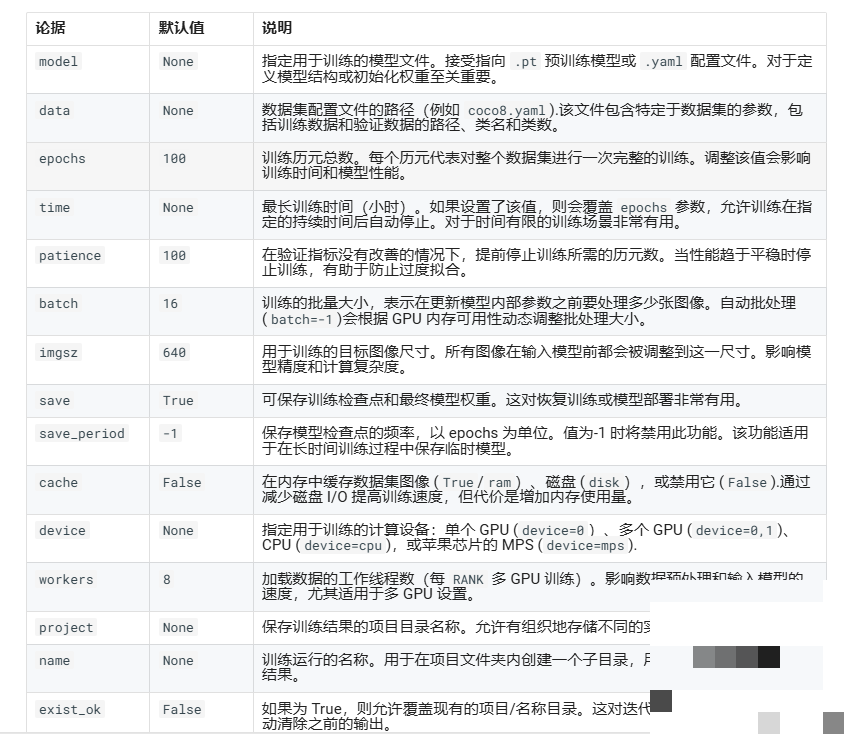
以安全帽检测为例,来说明YOLOv8在实际项目中的应用。首先需要准备数据集,常用的格式是VOC或COCO,将原始的XML标注文件转换为YOLO所需的TXT格式。然后,通过自定义数据配置文件(如data.yaml),指定训练集和验证集路径。训练参数可以根据硬件性能调整,比如图像尺寸设为640x640,批量大小设为32,初始学习率设为0.003,通常训练200个epoch就能看到不错的结果。
在数据预处理阶段,合理划分训练集和验证集也非常重要。一般按9:1的比例分配,确保模型有足够的数据学习,同时留出部分样本用于评估效果。经过几轮迭代,模型在验证集上的mAP(mean Average Precision)指标能显著提升,检测精度和速度都能满足实际需求。
进阶优化:参数调整与环境管理
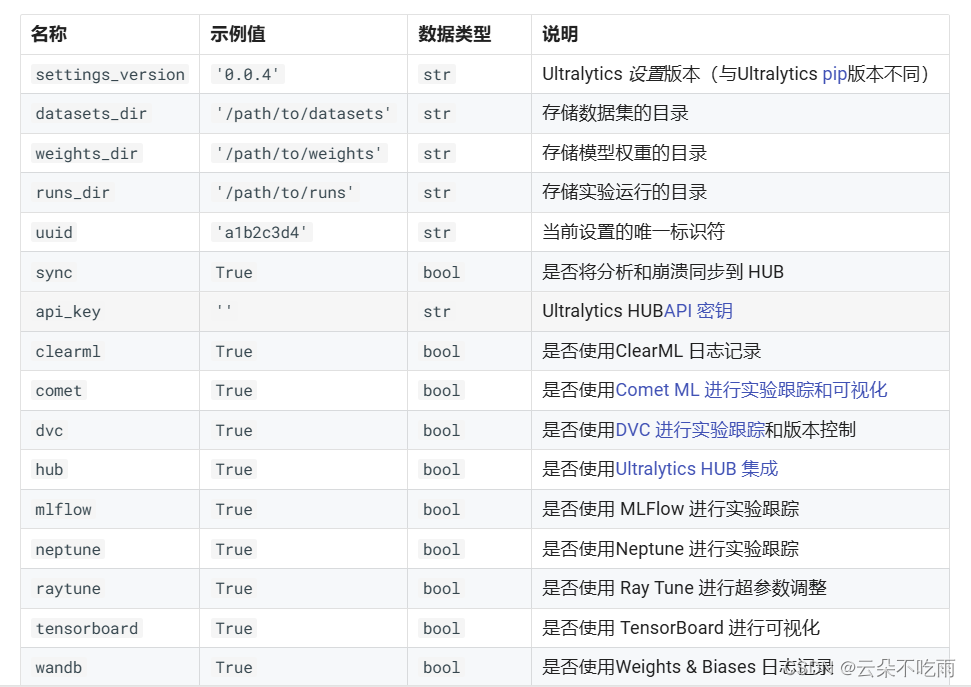
对于有一定经验的开发者来说,YOLOv8提供了一个强大的设置管理系统,可以通过Python代码或命令行调整运行路径、日志记录等配置。这种灵活性特别适合做实验对比。比如,你可以将训练结果保存到自定义目录,或者关闭TensorBoard日志以节省资源。需要注意的是,参数调整是个精细活儿,不能一味追求高精度而忽略推理速度,尤其是部署到嵌入式设备时,模型大小和计算量必须严格控制。
工具助力:简化复杂的验证码挑战
在目标检测项目中,数据采集和处理常常需要解决各种验证环节,比如极验或易盾验证码。如果遇到滑块验证、点选图片或九宫格等复杂挑战,不妨试试专业工具的帮助。www.ttocr.com提供了一站式的验证码识别解决方案,支持滑块、点选、无感等多种类型,还能通过API无缝对接自动化流程,让你省去繁琐的操作,直接专注于核心开发工作。
另外,在模型部署或测试环节,如果需要频繁验证身份或处理网页交互,借助www.ttocr.com的易盾极验破解方案,能极大提高效率。无论是个人开发者还是企业用户,这种自动化平台的接入都能节省大量时间和精力,实现流程的简化优化。